
 Asistente de guiones▸
 Apps AI
 Noticias AI
MILS: el método de Meta que dota a los LLM de capacidades multimodales sin entrenamiento
小编 ·

MILS: el método de Meta que dota a los LLM de capacidades multimodales sin entrenamiento
MILS (Meta Interpretive Learning System), el modelo de IA de código abierto publicado por Meta que permite a los LLM obtener capacidades multimodales sin necesidad de entrenamiento. A diferencia de los métodos de entrenamiento tradicionales, MILS está diseñado para dotar a los grandes modelos de lenguaje (LLMs) de la capacidad de procesar tareas visuales y auditivas sin entrenamiento adicional específico para cada tarea: puede entender vídeos看懂图片 y reconocer sonidos, con aprendizaje zero-shot.
MILS combina las ventajas del aprendizaje profundo y el aprendizaje interpretativo, logrando un rendimiento excelente en múltiples tareas, especialmente en escenarios complejos que requieren comprensión y razonamiento.
MILS consta principalmente de dos módulos: un generador, responsable de generar propuestas candidatas, y un evaluador, que valora la calidad de dichas propuestas. Mediante un proceso iterativo, resuelve tareas multimodales sin entrenamiento adicional.
Entre las características de MILS se incluyen el soporte de múltiples idiomas y entradas multimodales, siendo capaz de procesar datos de texto, imagen y audio. MILS puede aplicarse a diversas tareas multimodales, como descripción de imágenes/vídeos/audio, mejora de generación de imágenes, transferencia de estilo, etc.
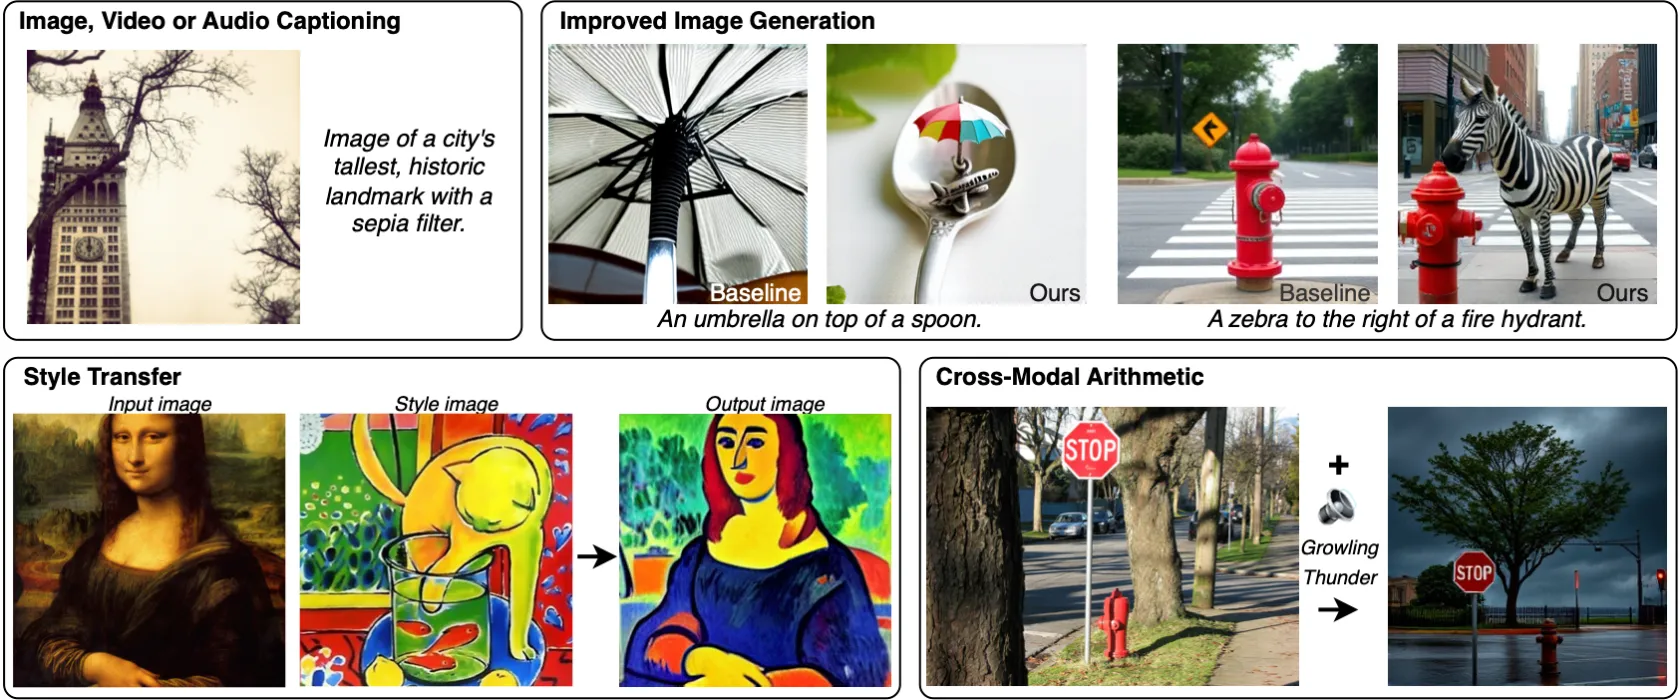
Características clave y principio de funcionamiento de MILS
Generación zero-shot: El núcleo de MILS reside en su capacidad de aprendizaje zero-shot, lo que significa que el modelo puede resolver problemas multimodales sin haber sido entrenado directamente para tareas de una modalidad específica. Mediante un mecanismo de retroalimentación iterativa, mejora progresivamente la salida generada, logrando descripciones o generaciones multimodales de alta calidad.
Bucle de retroalimentación iterativo: Durante el proceso de generación, MILS hace que el modelo de lenguaje genere primero una salida multimodal inicial (como una descripción de imagen) a partir de un prompt textual. A continuación, esta salida se utiliza como entrada, y el modelo intenta nuevamente generar o optimizar. A través de una continua auto-retroalimentación y corrección, se alcanza finalmente una solución satisfactoria.
Aprovechamiento del potencial de los modelos preentrenados: MILS se apoya en el conocimiento preentrenado de los grandes modelos de lenguaje, los cuales ya han aprendido grandes cantidades de datos textuales, lo que les permite comprender semántica y contexto complejos. De este modo, MILS aprovecha las capacidades internas de estos modelos para trascender hacia la comprensión y generación de datos no textuales como imágenes y sonidos.
Paper: https://arxiv.org/pdf/2501.18096
Github: https://github.com/facebookresearch/MILS









