
 Asistente de guiones▸
 Apps AI
 Noticias AI
OmniHuman: framework multimodal de extremo a extremo para la generación de vídeos de humanos digitales
小编 ·

OmniHuman: framework multimodal de extremo a extremo para la generación de vídeos de humanos digitales
OmniHuman esun marco de generación devídeo de humanos digitales multimodal basado en Transformer de difusión de ByteDance. Solo se necesita una foto y un fragmento de audio para generar un vídeo, con movimientos, sincronización labial y expresiones casi perfectos.
El marco OmniHuman amplía la escala de datos al mezclar condiciones relacionadas con el movimiento durante la fase de entrenamiento, y su núcleo reside en su capacidad para procesar múltiples modalidades de entrada, generando así vídeos de humanos digitales más realistas y naturales.
Características clave de OmniHuman
Entrada multimodal: OmniHuman admite múltiples formas de entrada, incluyendo texto, audio y vídeo, lo que permite que los humanos digitales generados muestren emociones y acciones más ricas en diferentes escenarios, fusionando datos de distintas modalidades para superar el cuello de botella de la escasez de datos de alta calidad.
Escalado de datos: al introducir condiciones relacionadas con el movimiento, OmniHuman puede ampliar eficazmente el conjunto de datos durante el entrenamiento, mejorando así la capacidad de generalización y el rendimiento del modelo generativo.
Salida de alta calidad: este marco utiliza tecnología avanzada de aprendizaje profundo para generar vídeos de humanos digitales de alta calidad, compatibles no solo con personas reales, sino también con personajes en 3D y personajes de anime, aplicable a múltiples campos como transmisiones en vivo, entretenimiento y educación.
Generación en tiempo real: OmniHuman también posee capacidad de generación en tiempo real, lo que permite a los usuarios obtener retroalimentación y rendimiento instantáneos del humano digital en escenarios interactivos.
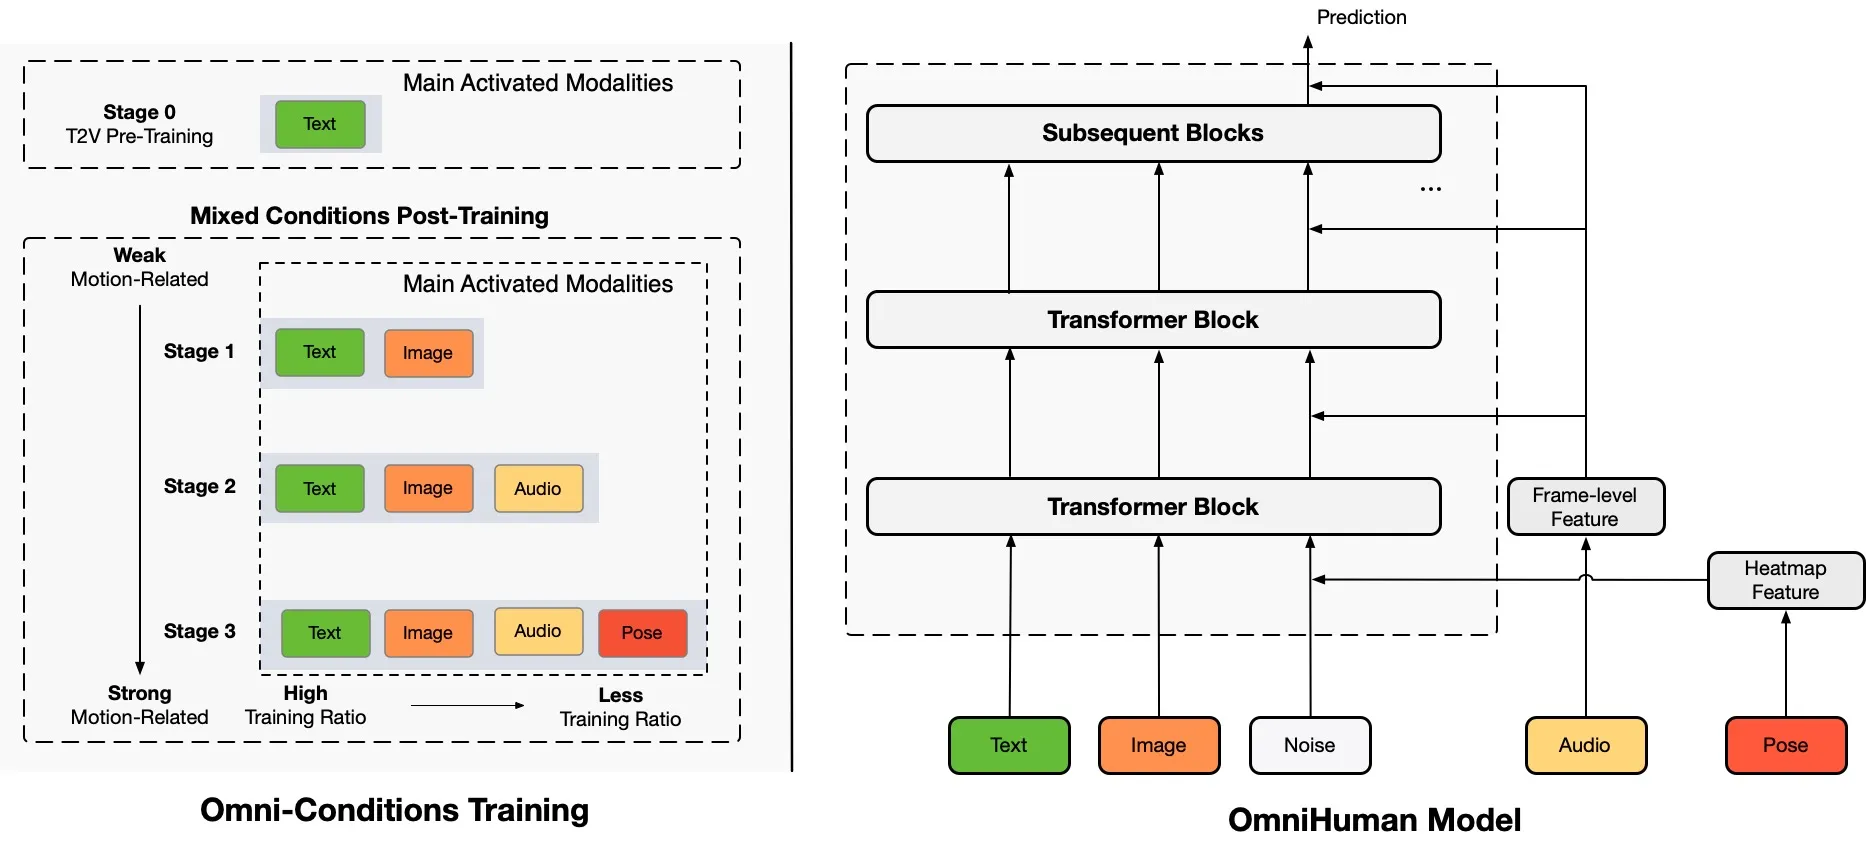
OmniHuman también admite múltiples modos de control, incluyendo control por audio, control por vídeo y señales de control combinadas, lo que ofrece a los usuarios una mayor flexibilidad en la entrada. Además, OmniHuman puede manejar interacciones entre personas y objetos y posturas corporales desafiantes, mejorando aún más el realismo y la expresividad de los vídeos generados. La filosofía de diseño del marco OmniHuman es aprovechar al máximo la generación de acciones basada en datos, logrando finalmente una generación de vídeo humana altamente realista. En comparación con los métodos existentes de extremo a extremo controlados por audio, OmniHuman no solo puede producir vídeos más realistas, sino que también ofrece una mayor flexibilidad en la entrada. Las muestras de vídeo están disponibles en la página del proyecto ttfamily, mostrando sus efectos de aplicación en diferentes escenarios.
Escenarios de aplicación de OmniHuman
Presentadores virtuales: en plataformas de transmisión en vivo, OmniHuman puede generar presentadores virtuales que ofrecen interacción en tiempo real y contenido de entretenimiento.
Educación y formación: mediante la generación de profesores virtuales, OmniHuman puede ofrecer experiencias de aprendizaje personalizadas en la educación en línea.
Desarrollo de videojuegos: en los videojuegos, los personajes virtuales pueden generarse mediante OmniHuman, mejorando la inmersión y la interactividad del juego.
Dirección del proyecto OmniHuman:https://omnihuman-lab.github.io









