
 Asistente de guiones▸
 Apps AI
 Noticias AI
Open R1: un proyecto de reproducción completamente de código abierto de DeepSeek-R1
小编 ·

Open R1: un proyecto de reproducción completamente de código abierto de DeepSeek-R1
Open R1 es un proyecto de reproducción completamente de código abierto de DeepSeek-R1 iniciado por Hugging Face, con el objetivo de reproducir por completo el proceso de entrenamiento del modelo DeepSeek R1. El objetivo del proyecto es construir las partes que faltan en el proceso de DeepSeek-R1, proporcionando un pipeline completo de entrenamiento con optimización de razonamiento para la investigación y la industria.
Objetivos del proyecto
Reproducir el pipeline de entrenamiento de DeepSeek-R1: mostrar de forma abierta en detalle cómo reproducir paso a paso el proceso de entrenamiento de DeepSeek-R1, desde la destilación de conocimiento hasta el aprendizaje por refuerzo, y luego el entrenamiento en varias etapas.
Proporcionar una implementación completa: el proyecto incluye un pipeline completo de entrenamiento con optimización de razonamiento, garantizando que los usuarios puedan utilizar y modificar el modelo con facilidad.
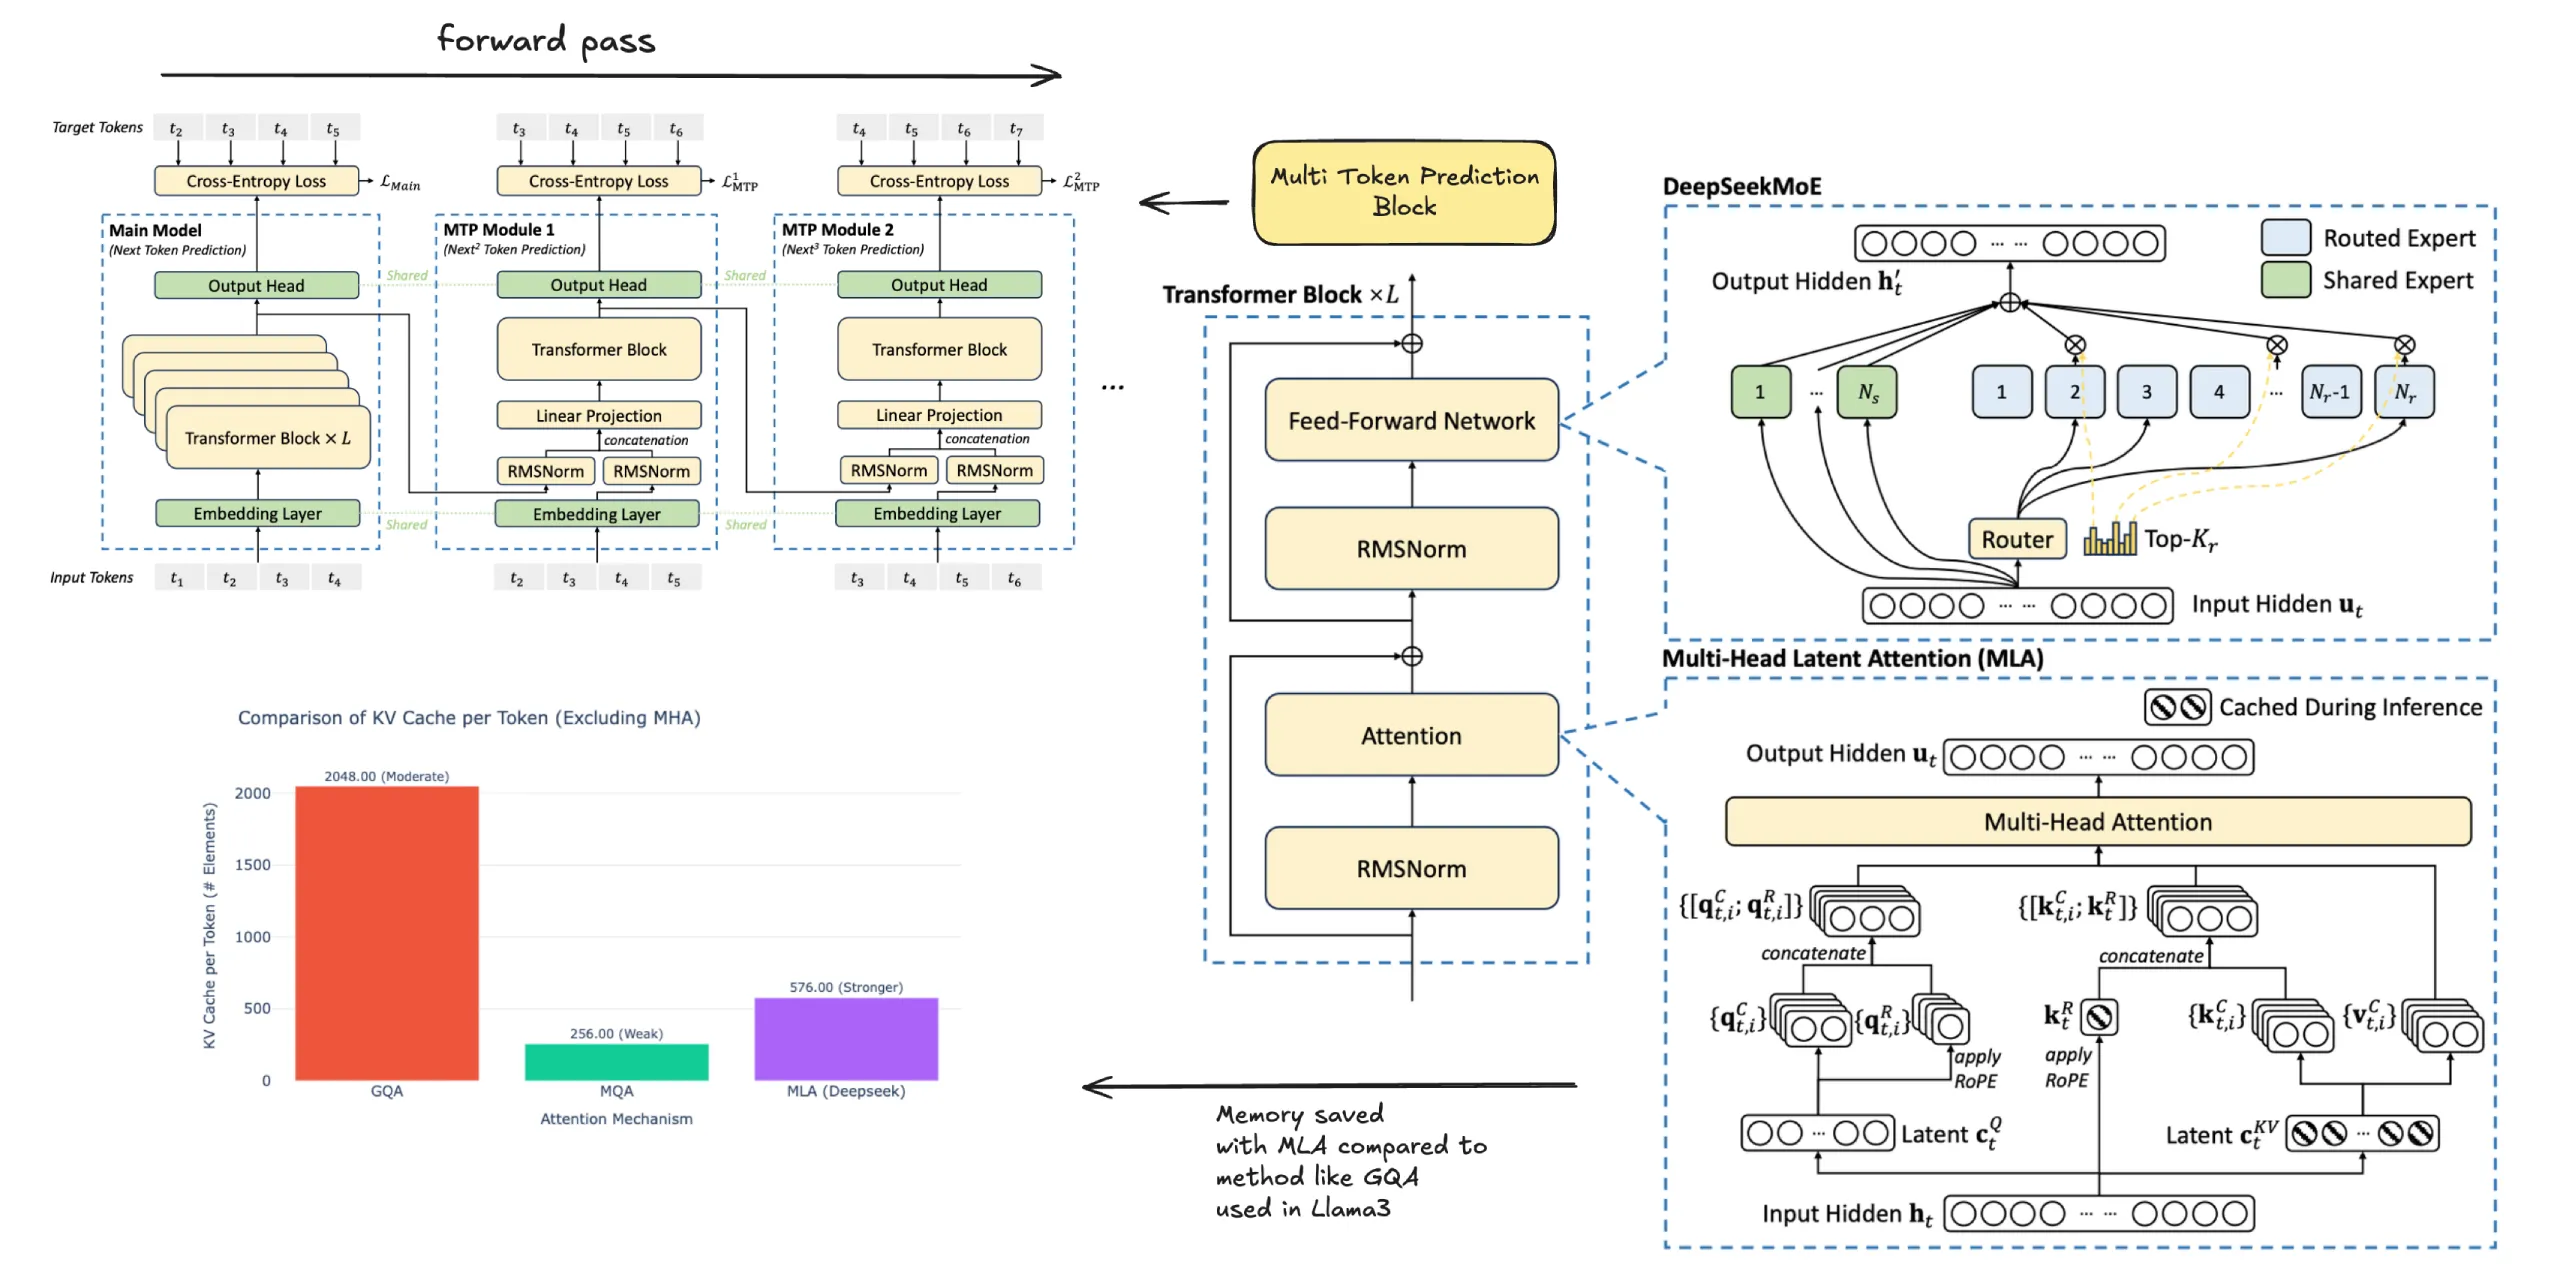
Composición del proyecto
Datos y scripts de entrenamiento: proporciona conjuntos de datos de código abierto y scripts de entrenamiento para llevar a cabo experimentos y validaciones.
Documentación y ejemplos: documentación detallada y código de ejemplo que ayudan a los usuarios a comenzar rápidamente y a comprender el uso del modelo.
El proyecto Open R1 también presta especial atención a los siguientes aspectos:
Recopilación de datos y código de entrenamiento: aunque los pesos del modelo DeepSeek-R1 son abiertos, los conjuntos de datos y el código utilizados para su entrenamiento no se han publicado. Open R1 planea reconstruir sistemáticamente los datos y el pipeline de entrenamiento de DeepSeek-R1 para verificar los efectos que afirma y empujar los límites de los modelos de razonamiento abiertos.
Entrenamiento en varias etapas: el plan del proyecto incluye un proceso de entrenamiento en varias etapas que va desde el modelo base hasta el ajuste fino supervisado (SFT) y luego al aprendizaje por refuerzo (RL), con el objetivo de mostrar cómo ajustar modelos existentes o nuevos mediante conjuntos de datos sintéticos para transformarlos en modelos de razonamiento.
Aplicaciones entre dominios: además de conjuntos de datos matemáticos, Open R1 también espera explorar el potencial en otros campos, como el código y dominios científicos como la medicina, donde los modelos de razonamiento podrían tener un impacto significativo.
¿Cómo operar el proyecto Open R1?
Paso 1: destilar un corpus de alta calidad con DeepSeek-R1 para reproducir el modelo R1-Distill y comprobar si el efecto es tan bueno como dice DeepSeek.
Paso 2: reproducir el pipeline de aprendizaje por refuerzo (RL) puro que DeepSeek utilizó para construir R1-Zero.
Paso 3: mediante entrenamiento en varias etapas, pasar del modelo base a la versión RL.
Proyecto Open R1: https://huggingface.co/blog/open-r1
Código de Open R1: https://github.com/huggingface/open-r1









