
 Asistente de guiones▸
 Apps AI
 Noticias AI
¿Qué es la destilación de modelos grandes y de qué tratan las acusaciones de «destilación de modelos» contra DeepSeek?
小编 ·

¿Qué es la destilación de modelos grandes y de qué tratan las acusaciones de «destilación de modelos» contra DeepSeek?
DeepSeek es una empresa emergente de inteligencia artificial que recientemente ha generado una gran atención tras ser acusada de utilizar la tecnología de Openai para la destilación de modelos. OpenAI afirma que DeepSeek podría haber extraído el conocimiento de sus modelos mediante técnicas de destilación, desarrollando así productos competidores.
¿Qué es la destilación (Distillation) de modelos grandes?
La destilación de modelos grandes es una técnica de compresión de modelos cuyo objetivo es transferir el conocimiento de un modelo grande y complejo (denominado modelo profesor) a un modelo más pequeño y eficiente (denominado modelo estudiante). Este proceso consiste en entrenar al modelo estudiante para que imite las salidas del modelo profesor, manteniendo así el rendimiento a la vez que se reduce el consumo de recursos computacionales.
Este concepto fue propuesto por Hinton y otros en 2015 y se utiliza comúnmente para la compresión de modelos, la aceleración de la inferencia y la reducción de los costes de despliegue, intentando al mismo tiempo conservar el rendimiento del modelo original. La técnica de destilación se aplica ampliamente en el aprendizaje profundo, especialmente en ámbitos como el procesamiento del lenguaje natural y la visión por computadora.
A continuación, se muestra un mapa mental de YouTube del canal "Jeff科技视角" de Jeff Li para comprender mejor el concepto. El profesor Jeff Li lo explica con gran detalle en el vídeo «Episodio 379: Destilación (Distillation) de modelos grandes y las acusaciones contra DeepSeek».
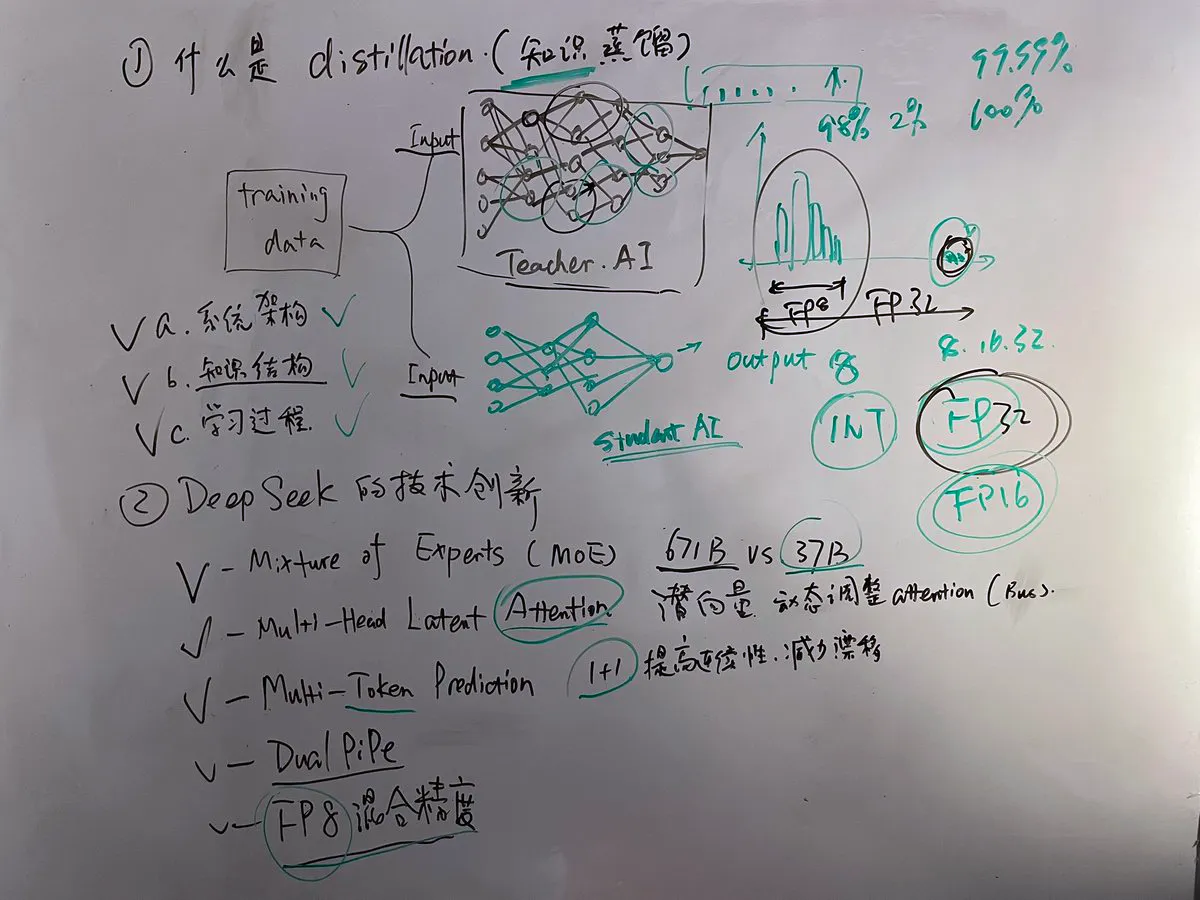
Métodos de implementación de la destilación de modelos grandes:
Etiquetas blandas (Soft Labels): se utilizan las distribuciones de probabilidad generadas por el modelo profesor en lugar de etiquetas duras para el entrenamiento.
Activaciones ocultas (Hidden Activations): se usan como señales auxiliares para el modelo estudiante las salidas de algunas capas intermedias del modelo profesor.
Pesos de atención (Attention Weights): en el caso de modelos secuenciales, también se puede transferir información relacionada con el mecanismo de atención.
Acusaciones de "destilación de modelos" a las que se enfrenta DeepSeek
Antecedentes:
DeepSeek es una empresa emergente que ofrece sus propios productos de modelos de lenguaje de gran tamaño.
El desarrollo de modelos de bajo coste, el código abierto y la estrategia gratuita de DeepSeek podrían amenazar la posición en el mercado de empresas como OpenAI y Anthropic, lo que ha provocado críticas de sus competidores, que consideran que DeepSeek ha utilizado de forma desleal su tecnología y sus datos.
Puntos clave:
La postura de OpenAI
Acusa a DeepSeek de extraer y utilizar datos sin autorización para entrenar sus propios modelos.
Problemas propios: OpenAI también ha sido criticada por extraer ilegalmente datos de Internet para entrenar sus modelos, en particular artículos protegidos por derechos de autor. Además, OpenAI ha enfrentado demandas legales por comportamientos similares de editores como el New York Times.
El punto de vista de Anthropic
Rebatiendo la gravedad: Anthropic considera que DeepSeek no representa una amenaza real para sus productos y afirma que su nivel tecnológico equivale al de hace unos pocos meses.
La actitud de Microsoft
Microsoft ha puesto en línea los modelos de DeepSeek en sus plataformas Azure AI y GitHub, mostrando una cierta forma de apoyo, lo que también ha suscitado debate sobre un posible conflicto de intereses.
La controversia concreta sobre la destilación de modelos
Legalidad y normativa: la destilación de modelos es una práctica técnica habitual, pero en su aplicación existen normas estrictas. Especialmente en lo relativo a los usos comerciales y a los acuerdos de intercambio tecnológico, cada empresa tiene diferentes interpretaciones y niveles de aplicación.
¿Cómo definir la obtención de datos "de forma no autorizada"?
¿Se permite utilizar los datos de salida de ciertas API para entrenar nuevos modelos competitivos?
Pruebas y materiales de apoyo: actualmente ninguna de las partes ha hecho públicos por completo los detalles de las pruebas que respalden sus respectivas posturas, lo que aumenta la complejidad y la incertidumbre del caso.
Reacción del sector y opinión pública
Las opiniones dentro y fuera de la comunidad son diversas; algunos consideran que se trata de una manifestación de la competencia en el mercado, pero también son muchas las voces que se preocupan por si se han respetado debidamente las implicaciones éticas y legales que subyacen a este asunto.
Las acusaciones de "destilación de modelos" a las que se enfrenta DeepSeek reflejan la intensa competencia existente en el sector actual de la IA, así como los desafíos derivados de las zonas grises legales en torno a los derechos de uso de datos y los límites de la innovación tecnológica.









