
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba Qwen presenta su modelo visión-lenguaje de nueva generación: Qwen2.5-VL
小编 ·

Alibaba Qwen presenta su modelo visión-lenguaje de nueva generación: Qwen2.5-VL
Ali Qwen2.5-VL es el nuevo modelo de comprensión visual presentado por el equipo Tongyi Qianwen de Alibaba. Este modelo cuenta con potentes capacidades de comprensión visual, agente y comprensión de vídeos largos, así como de captura de eventos, con el objetivo de impulsar la aplicación y el desarrollo de la ia en múltiples campos.
Funciones principales de Qwen2.5-VL
Comprensión visual: Qwen2.5-VL puede identificar con precisión objetos comunes en imágenes, como flores, pájaros, peces e insectos, y analizar textos, gráficos, iconos, figuras y diseños en las imágenes. Esto le permite ofrecer un rendimiento excelente en el procesamiento de información visual y proporcionar a los usuarios resultados detallados de análisis de imágenes.
Comprensión de vídeo: el modelo soporta de forma innovadora la comprensión de vídeos de más de 1 hora, siendo capaz de identificar y analizar eventos concretos dentro de los vídeos. Esta función ofrece a Qwen2.5-VL una ventaja significativa en el análisis y procesamiento de contenidos de vídeo.
Capacidad de razonamiento dinámico: Qwen2.5-VL cuenta con capacidad de razonamiento dinámico, lo que le permite tomar decisiones y realizar operaciones complejas en función del entorno visual y de instrucciones textuales. Esto le permite actuar como un agente visual de IA capaz de controlar directamente dispositivos como teléfonos móviles y ordenadores.
Versiones multiescala: Qwen2.5-VL ofrece tres modelos de distintos tamaños: 3B, 7B y 72B, para que los usuarios puedan elegir la versión adecuada según sus necesidades y satisfacer así diferentes escenarios de aplicación y recursos computacionales.
Características principales
Versiones multiescala
Ofrece tres versiones con diferentes cantidades de parámetros: 3B, 7B y 72B, cada una adecuada para distintos escenarios de aplicación y configuraciones de hardware.
Versión 3B: adecuada para dispositivos móviles y otros entornos con recursos limitados.
Versión 7B: equilibra rendimiento y consumo de recursos, siendo adecuada para la mayoría de los escenarios de aplicación.
Versión 72B: la versión de máximo rendimiento, adecuada para aplicaciones que requieren alta precisión y potentes funcionalidades.
Funciones avanzadas
Capacidad de localización visual: identifica con precisión los objetos en las imágenes y devuelve información de ubicación en forma de coordenadas.
Reconocimiento de imágenes general: no solo identifica objetos comunes (como flores, pájaros y peces), sino que también analiza elementos como textos, gráficos e iconos presentes en las imágenes.
Análisis de documentos: mejora significativamente la comprensión de documentos y tablas, destacando especialmente en la resolución de problemas académicos, capacidades matemáticas y verificación de documentos.
Comprensión de vídeo: soporta la comprensión de vídeos de larga duración (hasta varias horas), con capacidad de localización de eventos al segundo, siendo capaz de resumir los puntos clave del vídeo y extraer información esencial.
Agente visual: puede operar ordenadores y teléfonos móviles sin necesidad de ajustes específicos para cada tarea, ejecutando tareas complejas de razonamiento y toma de decisiones.
Reconocimiento y comprensión de texto: mejora la capacidad de OCR, soportando el reconocimiento y la extracción de información de textos en múltiples escenarios, idiomas y orientaciones.
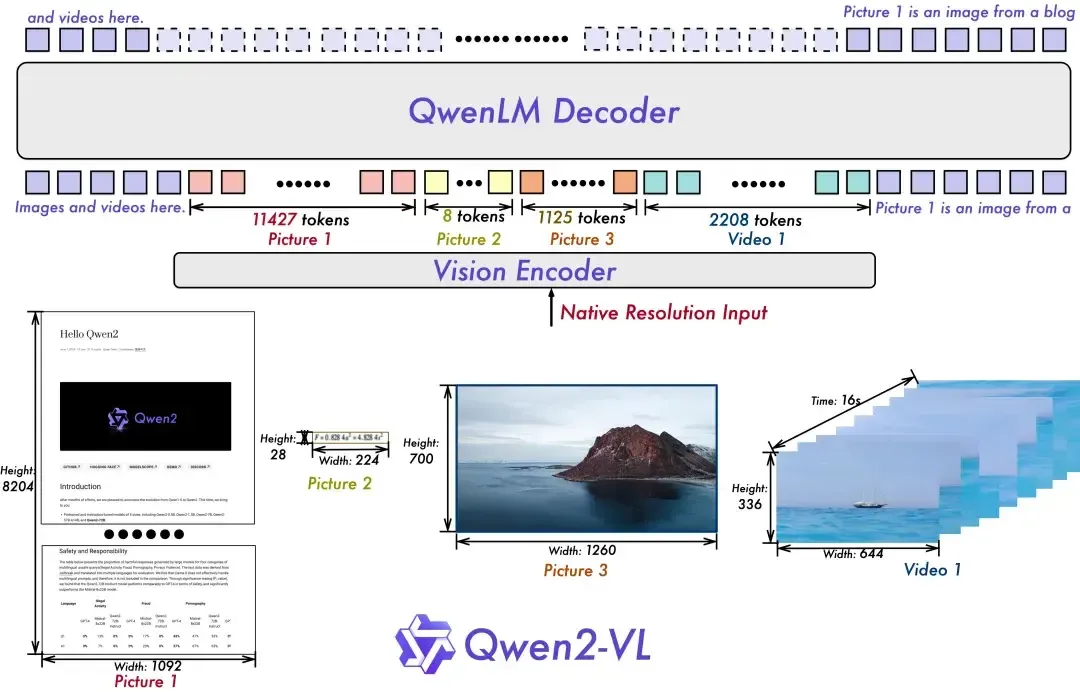
Mejoras
Capacidad de percepción espacio-temporal: se ha reforzado la percepción del modelo respecto a las escalas temporal y espacial, lo que le permite comprender y procesar mejor distintos tipos de datos.
Simplificación de la estructura de red: se ha introducido un mecanismo de atención por ventanas, reduciendo la carga computacional y mejorando la eficiencia del modelo.
Resolución dinámica: se utiliza un ViT con resolución dinámica nativa, garantizando que el modelo mantenga la resolución original y reduciendo al mismo tiempo la presión computacional.
Rendimiento
Líder en múltiples pruebas de referencia: muestra un rendimiento excelente en pruebas de referencia de diversos campos, superando a modelos competidores en tareas como comprensión de documentos, respuesta visual a preguntas, comprensión de vídeo y agente visual.
Casos concretos:
Comprensión de documentos: destaca en tareas como DocVQA.
Comprensión de vídeo: puede comprender con precisión contenidos de vídeo de varias horas de duración, localizando y resumiendo rápidamente eventos importantes.
Agente visual: capaz de ejecutar tareas complejas de automatización sin ajustes adicionales, como el control de dispositivos e interfaces de software.
Escenarios de aplicación de Qwen2.5-VL
Atención al cliente inteligente: Qwen2.5-VL puede aplicarse en escenarios de atención al cliente mediante vídeo, analizando en tiempo real las imágenes de productos o códigos de barras mostrados por los usuarios y proporcionando información relevante sobre los productos.
Sector financiero y empresarial: el modelo admite salidas estructuradas, siendo adecuado para el procesamiento de datos como facturas y formularios, lo que lo hace especialmente apropiado para aplicaciones en los ámbitos financiero y empresarial.
Educación y formación: en el ámbito educativo, Qwen2.5-VL puede emplearse para analizar vídeos didácticos, ayudando a los estudiantes a comprender conceptos y contenidos complejos.
Análisis de imágenes médicas: la capacidad de comprensión visual del modelo también puede aplicarse al análisis de imágenes médicas, ayudando a los médicos a interpretar mejor los datos de imagen.
El modelo Qwen2.5-VL mantiene la estructura de su predecesor Qwen-VL, adoptando una arquitectura en serie con ViT (transformador de visión) y Qwen2, y soporta entradas unificadas de imágenes y vídeo. Este diseño permite al modelo fusionar mejor la información visual y lingüística, mejorando la comprensión de datos multimodales. Además, Qwen2.5-VL incorpora la codificación posicional rotacional multimodal (M-ROPE), que descompone la codificación posicional en tres partes: temporal y espacial (altura y anchura), reforzando así la capacidad de procesamiento y razonamiento multimodal del modelo. El modelo también dispone de capacidad de reconocimiento de imágenes con cualquier resolución, siendo capaz de procesar imágenes con distintas resoluciones y relaciones de aspecto, garantizando la coherencia entre la entrada y la información de la imagen.
Cómo obtener Qwen2.5-VL:
Dirección de código abierto: Hugging Face
Github: Qwen2.5-VL
Prueba en línea: Qwen Chat









