
 Asistente de guiones▸
 Apps AI
 Noticias AI
DeepSeek R1: modelo de razonamiento de código abierto de DeepSeek, rival de OpenAI o1
小编 ·

DeepSeek R1: modelo de razonamiento de código abierto de DeepSeek, rival de OpenAI o1
¿Qué es DeepSeek R1?
DeepSeek R1 es un modelo de lenguaje grande de razonamiento de código abierto lanzado por la empresa china de inteligencia artificial DeepSeek. Mediante una ruta técnica impulsada por aprendizaje por refuerzo, alcanza un rendimiento comparable a la versión oficial de o1 de Openai en tareas complejas como matemáticas, código y razonamiento en lenguaje natural, con un desempeño especialmente destacado en tareas de razonamiento. Emplea técnicas de aprendizaje por refuerzo que mejoran significativamente la capacidad de razonamiento del modelo y permiten un entrenamiento eficiente con muy pocos datos etiquetados. Este enfoque también le otorga una ventaja en costes, afirmando que su coste de operación es solo el 3% del de OpenAI.
Tecnología central de DeepSeek R1:
1. Capacidad de razonamiento impulsada por aprendizaje por refuerzo
Entrenamiento con aprendizaje por refuerzo puro (RL): DeepSeek R1-Zero aplica directamente aprendizaje por refuerzo a gran escala sobre el modelo base, sin necesidad de ajuste fino supervisado (SFT), validando por primera vez que el RL puro puede estimular la capacidad de razonamiento de los LLM. El modelo utiliza el algoritmo GRPO (Group Relative Policy Optimization) para reducir el coste de entrenamiento y emplea un sistema de recompensas basado en reglas (recompensa de precisión y recompensa de formato) que guía al modelo a generar cadenas de pensamiento (CoT) estructuradas.
Optimización con datos de arranque en frío: Para resolver los problemas de legibilidad y mezcla de idiomas de R1-Zero, DeepSeek R1 introduce una pequeña cantidad de datos de arranque en frío (ejemplos de CoT largas) y, mediante un entrenamiento multifase (ajuste fino de arranque en frío → RL orientado al razonamiento → RL de escenarios completos), mejora la legibilidad y la generalidad de las salidas.
Razonamiento de cadenas largas y destilación del modelo
Soporte de cadenas de pensamiento ultralargas: Soporta una ventana de contexto de 128K y puede descomponer problemas complejos en razonamiento de varios pasos; por ejemplo, en problemas matemáticos genera procesos de deducción detallados de decenas de miles de caracteres.
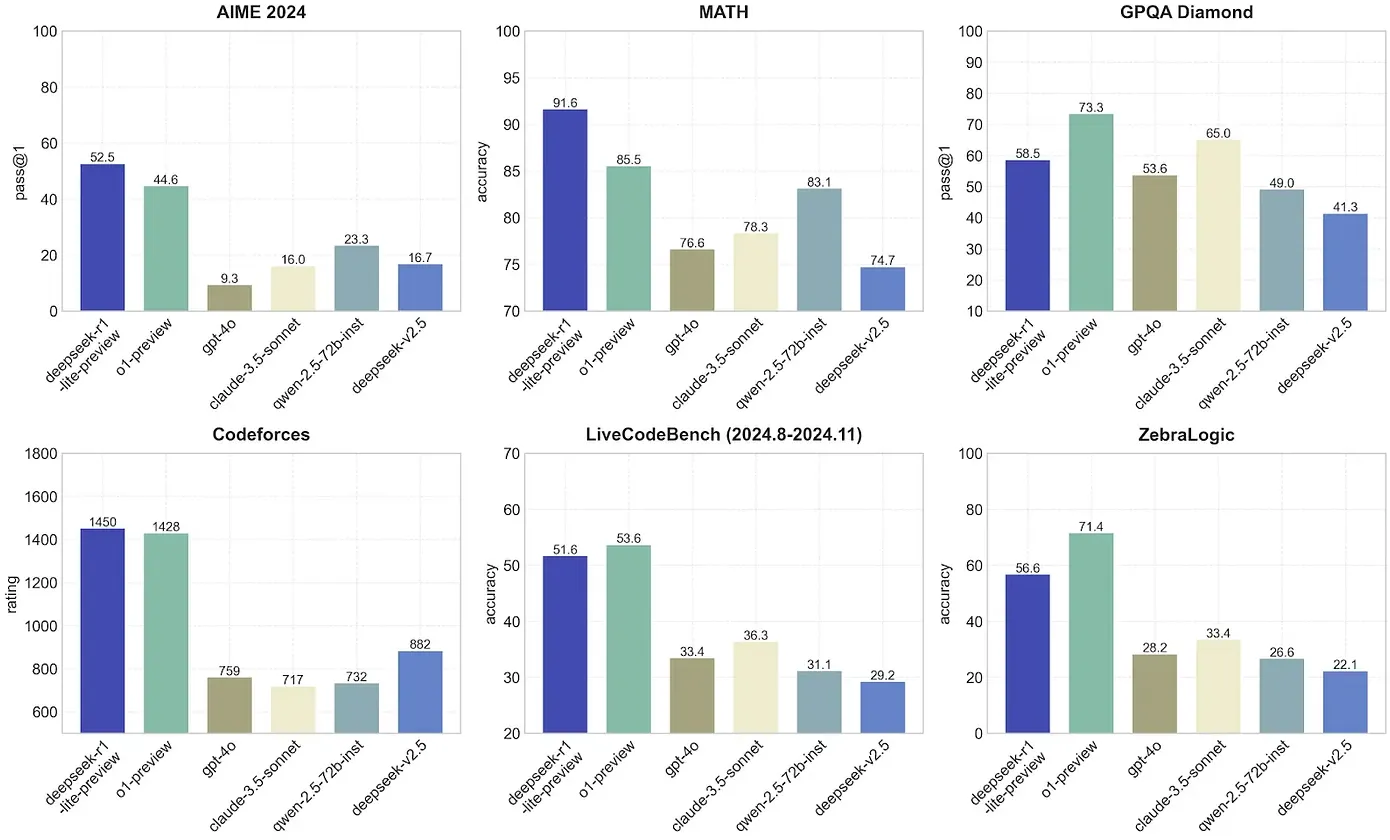
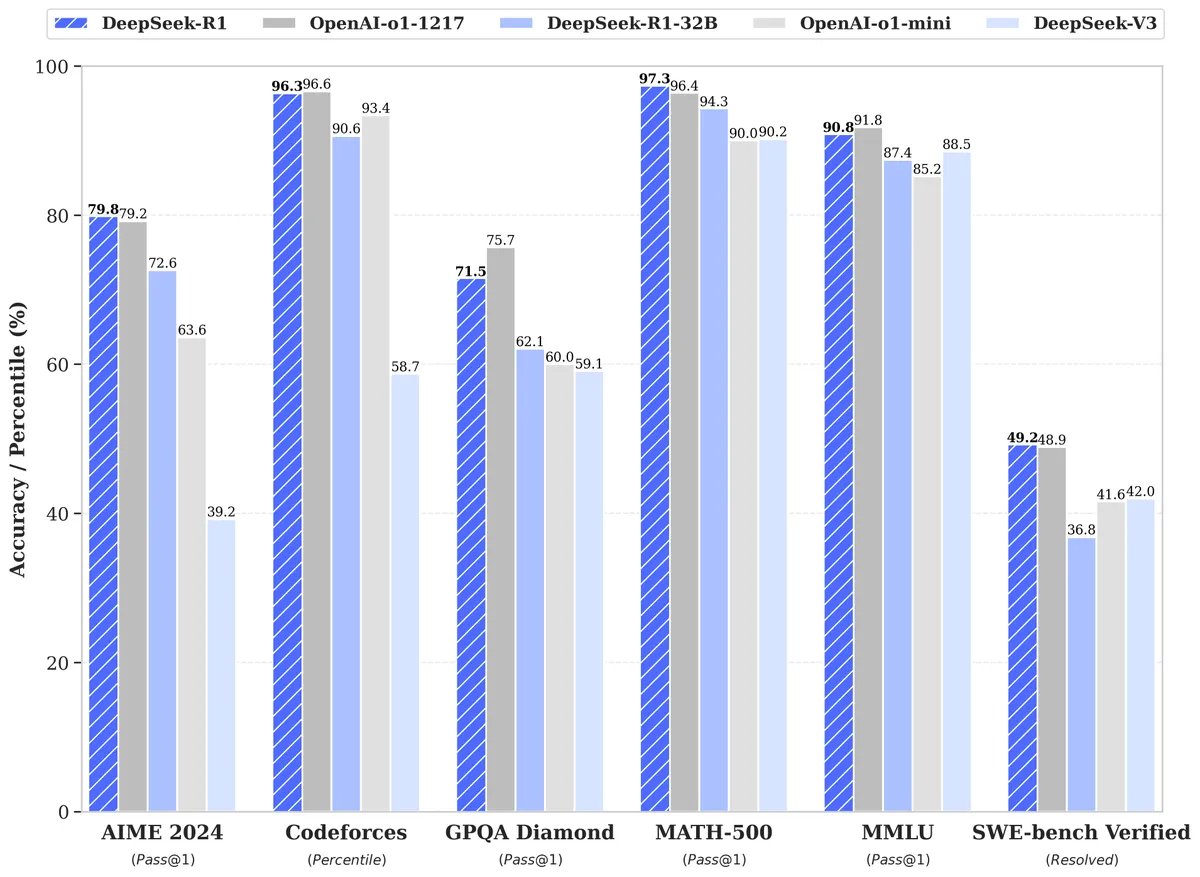
Técnica de destilación eficiente: Destila la capacidad de razonamiento de R1 a modelos pequeños de las series Qwen y Llama (como 7B, 32B, 70B) mediante 800k muestras. La versión destilada de Qwen-32B alcanza una precisión pass@1 del 72,6% en la prueba AIME 2024, con un rendimiento cercano al de o1-mini.
2. Rendimiento y pruebas de referencia
Capacidades matemáticas y de programación
Rendimiento a nivel de competición matemática: En la AIME 2024 (American Mathematics Invitational Examination), R1 alcanza una precisión pass@1 del 79,8%, y en el benchmark MATH-500 obtiene un 97,3%, superando a OpenAI-o1-1217. En pruebas con los problemas más difíciles de matemáticas de la gaokao, R1 resuelve la respuesta en solo 83 segundos, aunque presenta недостаточная нормативность de los pasos.
Nivel experto en generación de código: Obtiene una calificación Elo de 2029 en Codeforces (superando al 96,3% de los participantes humanos) y un pass@1 del 65,9% en LiveCodeBench. Pruebas de usuarios muestran que R1 genera código de visualización de mecánica cuántica en solo 9 minutos y puede ejecutarse directamente.
Tareas de lenguaje general y conocimiento
Capacidad integral en múltiples dominios: Obtiene un 90,8% en MMLU (comprensión lingüística multitarea), un 84% en MMLU-Pro y un 71,5% en GPQA Diamond, superando significativamente a DeepSeek-V3 y acercándose a OpenAI-o.
Razonamiento en humanidades e historia: Alcanza una tasa de acierto del 100% en acertijos chinos (brain teasers), y también ofrece respuestas lógicamente claras a preguntas históricas complejas sobre el antiguo Egipto y pueblos indígenas africanos, con una riqueza informativa superior a la de los modelos no orientados al razonamiento.
3. Ecosistema de código abierto y ventaja de bajo coste
Estrategia de código abierto y amigabilidad comercial
Código abierto bajo licencia MIT: Tanto el modelo completo (671B parámetros) como los 6 modelos destilados (1.5B-70B) son de código abierto, admitiendo uso comercial gratuito, modificación y desarrollo posterior. Por ejemplo, la versión destilada de Qwen-14B puede ejecutarse en hardware de escritorio y obtiene una puntuación de 53,1% en LiveCodeBench.
Revolución en precios de la API: El coste del token de entrada es de tan solo 1 yuan/millón (con caché) y el token de salida es de solo 16 yuanes/millón, aproximadamente el 3,7% del precio de OpenAI-o1. Mediciones de usuarios muestran que una sola llamada a la API puede costar tan solo 0,06 dólares.
Herramientas para desarrolladores y soporte de integración
Despliegue multiplataforma: Soporta Hugging Face, el framework vLLM y la integración con Spring AI; los desarrolladores pueden invocar al modelo mediante una configuración sencilla. Por ejemplo, los usuarios de Spring AI solo necesitan añadir la dependencia y configurar la clave de API para conectarse.
Optimización de la estabilidad del razonamiento: La API desactiva por defecto el parámetro temperature para garantizar la estabilidad de los resultados, y devuelve por separado la cadena de pensamiento y la respuesta final a través de los campos reasoning_content y content.
4. Escenarios de aplicación
Investigación y educación: Asiste en modelado matemático, generación de código y análisis histórico, proporcionando procesos de razonamiento detallados que impulsan la investigación académica. Por ejemplo, generar código de animaciones de mecánica cuántica o analizar problemas matemáticos complejos.
Inteligencia empresarial: Integración en sistemas de atención al cliente, análisis de datos o plataformas de decisión automatizada, reduciendo el coste de despliegue de IA.
R1, con su estrategia de código abierto y su coste ultrabajo (coste de entrenamiento de 5,576 millones de dólares, aproximadamente 1/10 del de GPT-4), impulsa una guerra de precios en el sector. Empresas como Meta ya han creado equipos especializados para investigar su ruta tecnológica.
Expertos como Yann LeCun consideran que el éxito de R1 marca la transición de los modelos de código abierto de "seguidores" a "líderes", promoviendo la colaboración global entre desarrolladores y la innovación tecnológica.
DeepSeek R1, con su capacidad de razonamiento impulsada por el aprendizaje por refuerzo y su estrategia de código abierto y bajo coste, se convierte en un avance importante en el campo de la IA. No solo destaca en tareas profesionales como matemáticas y código, sino que también impulsa la innovación tecnológica global a través de su ecosistema de código abierto, ofreciendo un nuevo paradigma para el desarrollo de la AGI.









