
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba lanza oficialmente el modelo grande de código abierto Qwen2.5-1M
小编 ·

Alibaba lanza oficialmente el modelo grande de código abierto Qwen2.5-1M
Alibaba lanzó oficialmente el 27 de enero de 2025 la serie de modelos de código abierto Qwen2.5-1M, marcando la primera vez que el equipo Tongyi Qianwen amplía la longitud de contexto de un modelo de código abierto hasta 1 millón de tokens (aproximadamente el equivalente a 10 novelas largas o 30.000 líneas de código), logrando avances significativos en el rendimiento del procesamiento de textos largos.
I. Características principales de Qwen2.5-1M
Soporte de contexto ultralargo: el modelo Qwen2.5-1M admite el procesamiento de contextos de hasta 1 millón de tokens, lo que equivale a aproximadamente 1 millón de palabras en inglés o 1,5 millones de caracteres chinos. Esta característica permite al modelo manejar documentos extensos, como libros, documentos legales e informes largos, sin necesidad de realizar tediosas divisiones de texto.
Variedad de tamaños del modelo: los modelos lanzados en esta ocasión incluyen Qwen2.5-7B-Instruct-1M y Qwen2.5-14B-Instruct-1M, ofreciendo diferentes escalas de parámetros para satisfacer las necesidades de distintos escenarios de aplicación.
Marco de inferencia eficiente: el equipo de Qwen ha publicado como código abierto un marco de inferencia basado en vLLM, que integra un mecanismo de atención dispersa, logrando un aumento de velocidad de entre 3 y 7 veces al procesar entradas de 1M tokens. Esta eficiencia permite a los desarrolladores desplegar y aplicar el modelo de forma más rápida.
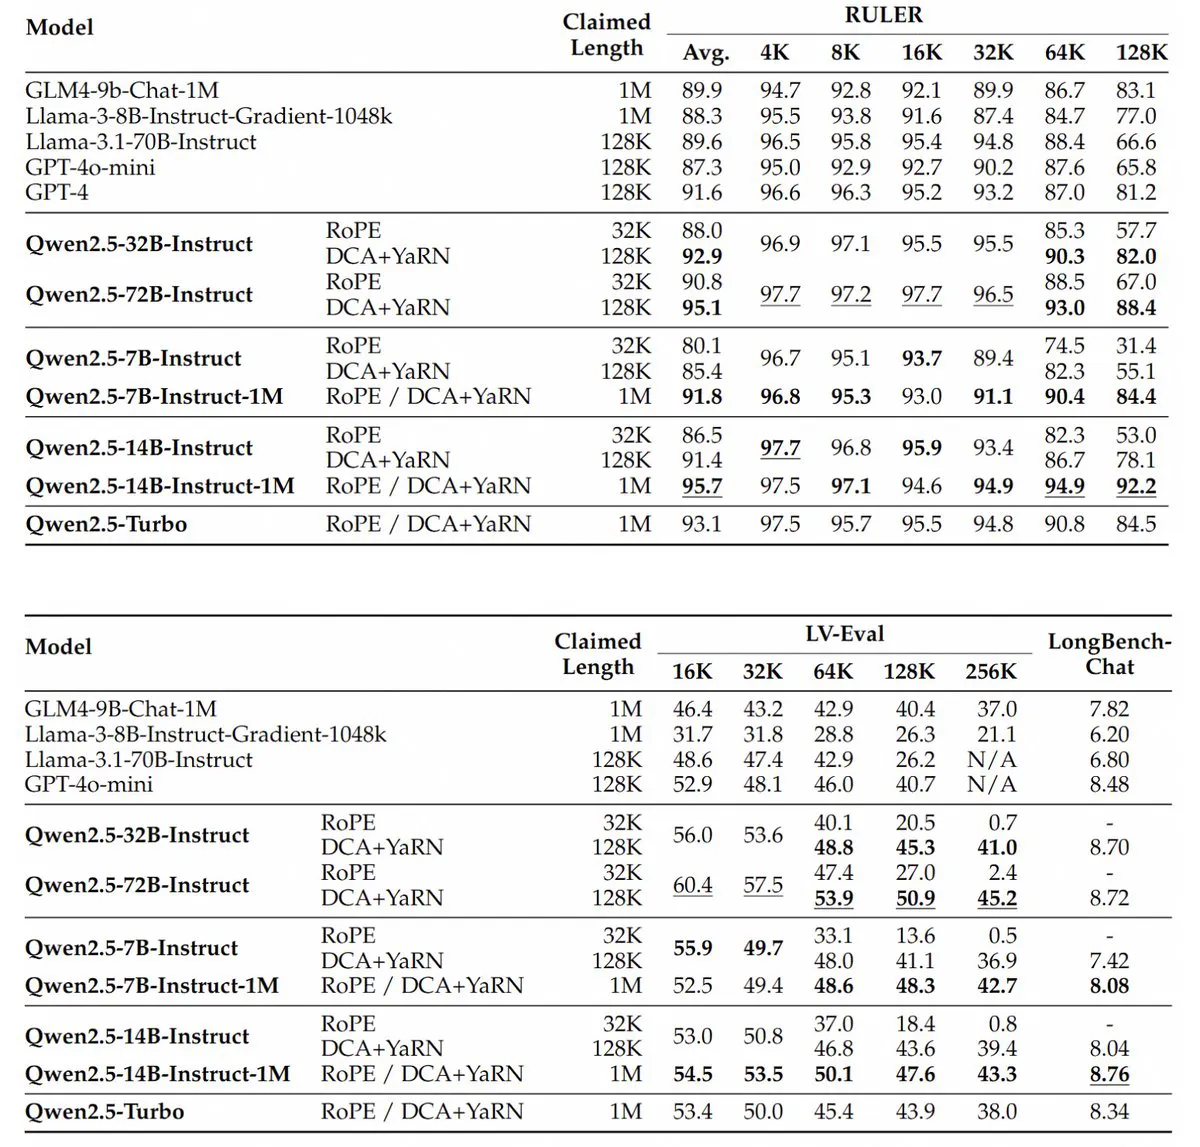
Ventajas de rendimiento: en tareas de texto largo, el modelo Qwen2.5-1M supera significativamente a la versión anterior de 128K, mostrando una capacidad especialmente superior al manejar tareas de más de 64K de longitud.
II. Características del modelo y rendimiento
Capacidad de procesamiento de contexto largo
Soporte de 1 millón de tokens: la serie Qwen2.5-1M incluye las versiones 7B y 14B, con soporte nativo para una longitud de contexto de 1M tokens, capaz de procesar documentos extensos, repositorios de código o conversaciones complejas de múltiples turnos sin necesidad de dividir la entrada.
Recuperación y comprensión precisas: en la tarea de "Buscar la aguja en el pajar" (Passkey Retrieval), el modelo puede extraer con precisión información oculta de documentos de 1M tokens, con solo algunos errores en la versión 7B; en pruebas de referencia de comprensión de textos largos como RULER y LV-eval, la versión 14B supera de forma estable a su propio modelo cerrado Qwen2.5-Turbo y al GPT-4o-mini de Openai.
Compatibilidad con tareas de texto corto
Los modelos 7B y 14B presentan un rendimiento equivalente al de la versión 128K en tareas de texto corto (como preguntas y respuestas, resúmenes), sin sacrificar el rendimiento básico a causa de la mejora en la capacidad de contexto largo. Por ejemplo, el modelo 14B presenta un rendimiento cercano al de GPT-4o-mini en tareas de texto corto, pero con una longitud de contexto 8 veces mayor.
III. Avances técnicos y marco de código abierto
Entrenamiento progresivo y extrapolación de longitud
Extensión por etapas: desde el preentrenamiento hasta el ajuste fino supervisado, la longitud del contexto se amplía progresivamente de 4K a 256K, y luego se optimiza la capacidad de alineación con textos cortos mediante aprendizaje por refuerzo56.
Dual Chunk Attention (DCA): se introduce una innovadora técnica de extrapolación de codificación posicional que permite ampliar la longitud de contexto soportada por el modelo de 256K a 1M sin entrenamiento adicional, resolviendo el problema de degradación de la atención en la codificación posicional de larga distancia.
Optimización de inferencia eficiente
Mecanismo de atención dispersa: basado en el marco vLLM, se integra atención dispersa (MInference), combinada con técnicas de prellenado por bloques y paralelismo dinámico, logrando un aumento de velocidad de inferencia de entre 3,2 y 6,7 veces para entradas de 1M tokens y reduciendo significativamente el uso de memoria (por ejemplo, la memoria de activación del modelo 7B se reduce un 96,7%).
Soporte de marco de código abierto: el marco de inferencia y el informe técnico de entrenamiento son completamente de código abierto, permitiendo a los desarrolladores desplegar el modelo rápidamente, y soportan cuantización FP8 para reducir los requisitos de hardware.
IV. Escenarios de aplicación
Generación de texto: el modelo Qwen2.5-1M puede utilizarse para generar artículos largos, informes e historias, siendo adecuado para campos como la creación de contenido, la redacción de noticias y artículos.
Recuperación de información: gracias a su capacidad de procesamiento de contexto ultralargo, el modelo puede realizar búsquedas efectivas de información en textos extensos, siendo adecuado para industrias como la legal y la médica que requieren procesar grandes volúmenes de documentos.
Sistemas de diálogo: este modelo puede usarse para construir sistemas de diálogo inteligentes, capaces de comprender y generar contenido conversacional complejo, mejorando la experiencia del usuario.
Aplicaciones multimodales: el diseño del modelo Qwen2.5-1M le permite combinarse con otras modalidades (como imágenes y audio), ampliando su alcance de aplicación a tareas de comprensión y generación multimodal.
El lanzamiento de Qwen2.5-1M no solo填补了开源模型在超长上下文处理领域的空白,更通过技术创新与生态开放,为开发者提供了高性能、低门槛的herramientas的选择。其成功可能加速全球AI产业对长文本应用的探索,并推动开源社区在AGI竞赛中的角色升级。









