
 Asistente de guiones▸
 Apps AI
 Noticias AI
Hallo: síntesis visual jerárquica guiada por audio para animación de imágenes de retrato
小编 ·

Hallo: síntesis visual jerárquica guiada por audio para animación de imágenes de retrato
Hallo puedegenerar vídeos de canto y habla a partir de una sola imagen y una entrada de audio, vídeos, y puede controlar las expresiones y posturas del personaje. En comparación con EMO,Hallo, al utilizar un modelo de difusión para lograr una síntesis visual jerárquica driven by audio,es capaz de generar animaciones con sincronización labial, cambios de expresión y cambios de postura correspondientes al introducir voz. Esto mejora la precisión de alineación entre la voz y la animación generada, haciendo que los labios, las expresiones y la postura de la animación estén sincronizados con la voz.
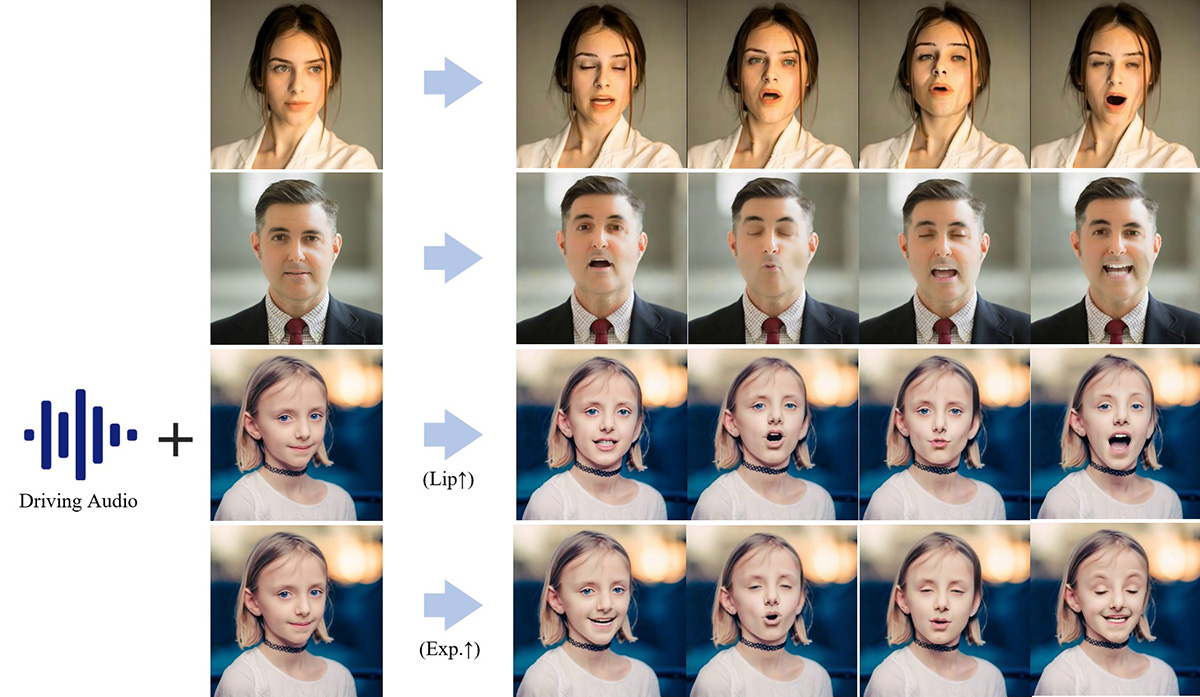
Características y funciones de Hallo:
Generación de animación de personajes virtuales: genera animaciones realistas y dinámicas de personajes virtuales a partir de entradas de audio de voz, logrando una sincronización precisa de los movimientos de los labios, expresiones y posturas del personaje virtual.
Generación de animación de personajes reales: aplica la tecnología a la generación de animaciones driven by voz de personas reales; las animaciones generadas reflejan con precisión los cambios de expresión y movimiento de la persona real.
Control de movimiento múltiple: ofrece un control preciso sobre las expresiones, la postura y el movimiento de los labios del personaje, admitiendo un control自适应 de múltiples expresiones y posturas, lo que mejora la diversidad y el realismo de la animación.
Aplicación跨演员: admite la generación de animaciones个性化 para diferentes identidades; a través de la entrada de audio, genera efectos de animación que se adaptan a diferentes identidades de personajes.
Generación de animación de canto: genera animaciones de canto sincronizadas a partir de entradas de voz y audio de canciones; la animación refleja con precisión los movimientos de los labios y los cambios de expresión al cantar.
Otras características de Hallo:
Tiempo real: adopta una estructura de modelo de difusión, lo que mejora la capacidad de tiempo real en la generación de animaciones y hace que las animaciones generadas sean más realistas y naturales.
Personalización: permite personalizar diferentes efectos de animación según distintos actores o personajes.
Diversidad: ofrece múltiples controles de movimiento, incluyendo expresiones, postura y movimiento de los labios, lo que hace que la animación sea más diversa y realista.
Dirección del proyecto Hallo:https://fudan-generative-vision.github.io/hallo
Hallo Github:https://github.com/fudan-generative-vision/hallo
Paper de Hallo:https://arxiv.org/abs/2406.08801
HuggingFace:https://huggingface.co/fudan-generative-ai/hallo









