
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba Cloud lanza el modelo de código abierto Qwen2
小编 ·

Alibaba Cloud lanza el modelo de código abierto Qwen2
Alibaba Cloud ha lanzado el modelo de código abierto Qwen 2, cuyo rendimiento supera al de todos los modelos de código abierto actuales y a los modelos cerrados nacionales.
El modelo Qwen 2 abarca múltiples tamaños, incluyendo 0.5B, 1.5B, 7B, 57B-A14B y 72B en 5 versiones. En las pruebas comparativas, el modelo Qwen 2 ha obtenido resultados superiores a todos los modelos de código abierto del mismo tamaño. Lo probé en CompassArena, el campo de entrenamiento de grandes modelos, y realmente es muy potente. Debería ser uno de los mejores en chino en la actualidad.
Características de Qwen 2:
5 tamaños de modelos preentrenados y ajustados por instrucciones, incluyendo Qwen2-0.5B, Qwen2-1.5B, Qwen2-7B, Qwen2-57B-A14B y Qwen2-72B;
Además de inglés y chino, ha sido entrenado con datos de 27 idiomas más;
Rendimiento de vanguardia en una amplia gama de evaluaciones comparativas;
Mejora significativa en el rendimiento en programación y matemáticas;
Compatibilidad con una longitud de contexto ampliada de hasta 128K tokens para Qwen2-7B-Instruct y Qwen2-72B-Instruct.
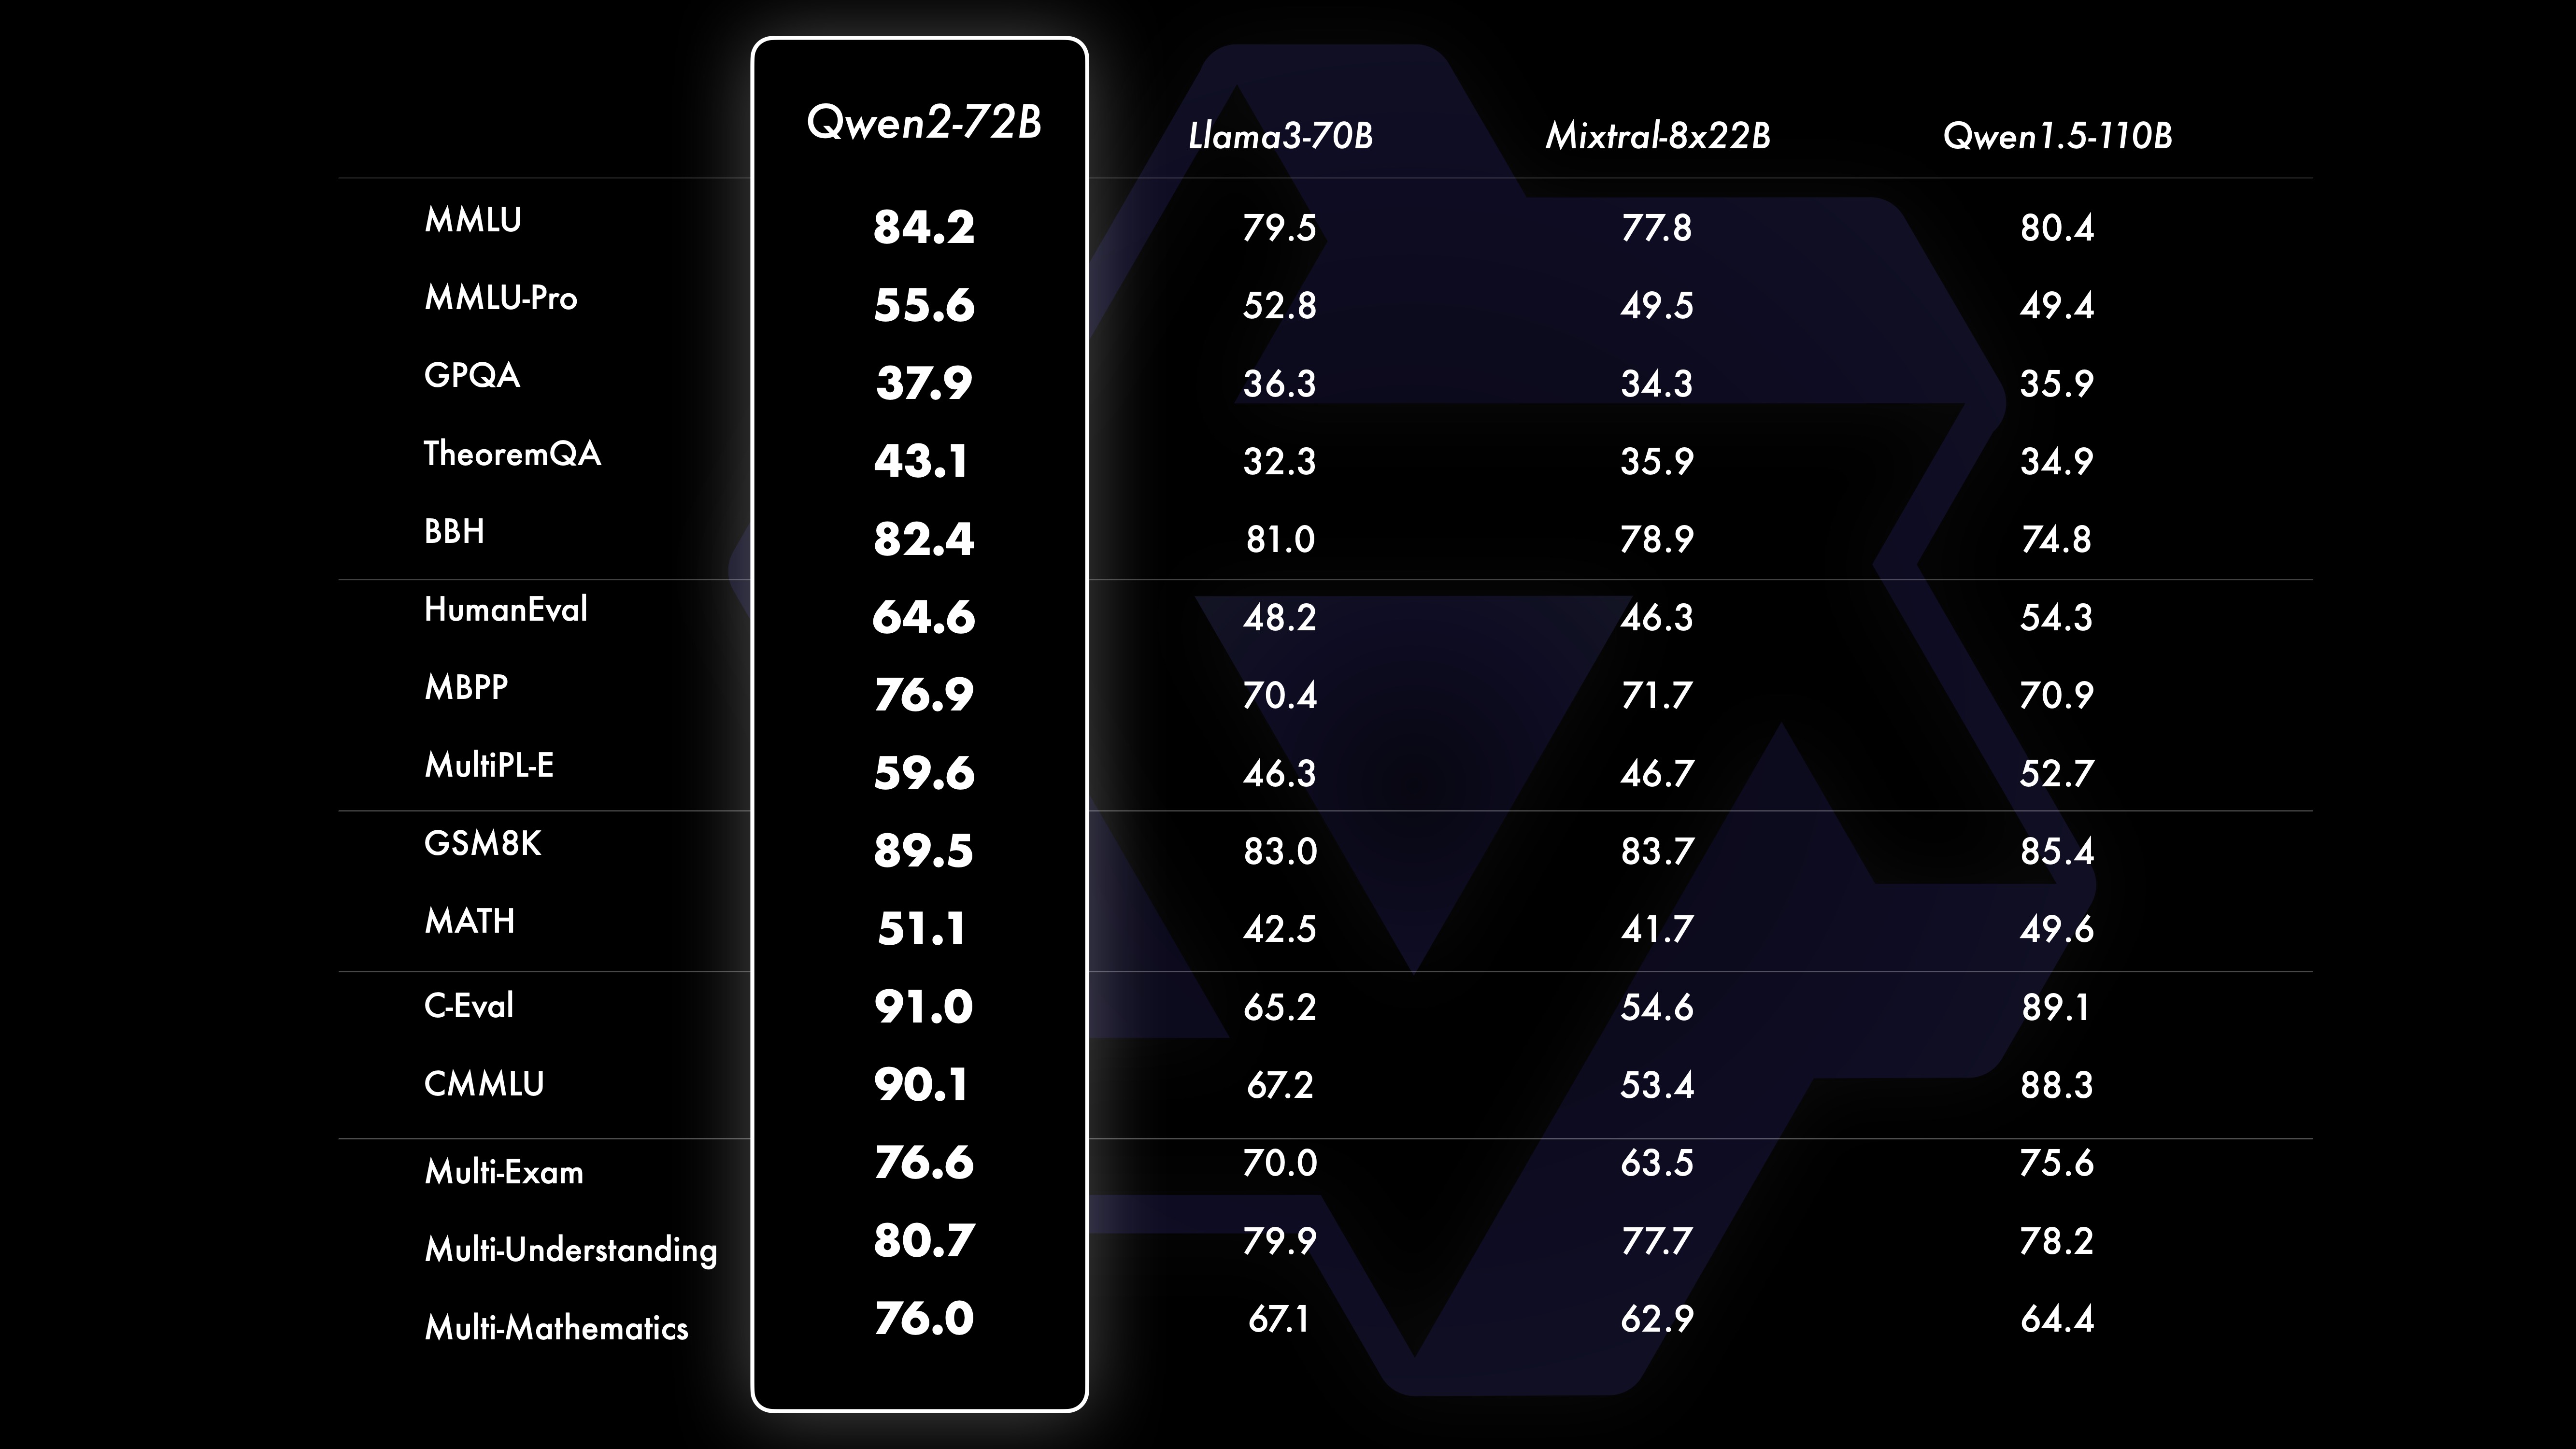
Las evaluaciones comparativas muestran que, en comparación con Qwen1.5, el rendimiento de los modelos grandes (70B+ parámetros) se ha mejorado notablemente. Aquí nos centramos en la evaluación del modelo grande Qwen2-72B. En cuanto a los modelos de lenguaje base, Qwen2-72B y los modelos abiertos más avanzados se han evaluado en diferentes capacidades, incluyendo comprensión del lenguaje natural, adquisición de conocimientos, capacidades de programación, habilidades matemáticas y capacidades multilingües. Gracias a un conjunto de datos cuidadosamente seleccionado y a un método de entrenamiento optimizado, Qwen2-72B muestra un rendimiento excelente en comparación con modelos líderes como Llama-3-70B. Cabe destacar que, a pesar de tener menos parámetros, su rendimiento supera al de su predecesor Qwen1.5-110B.
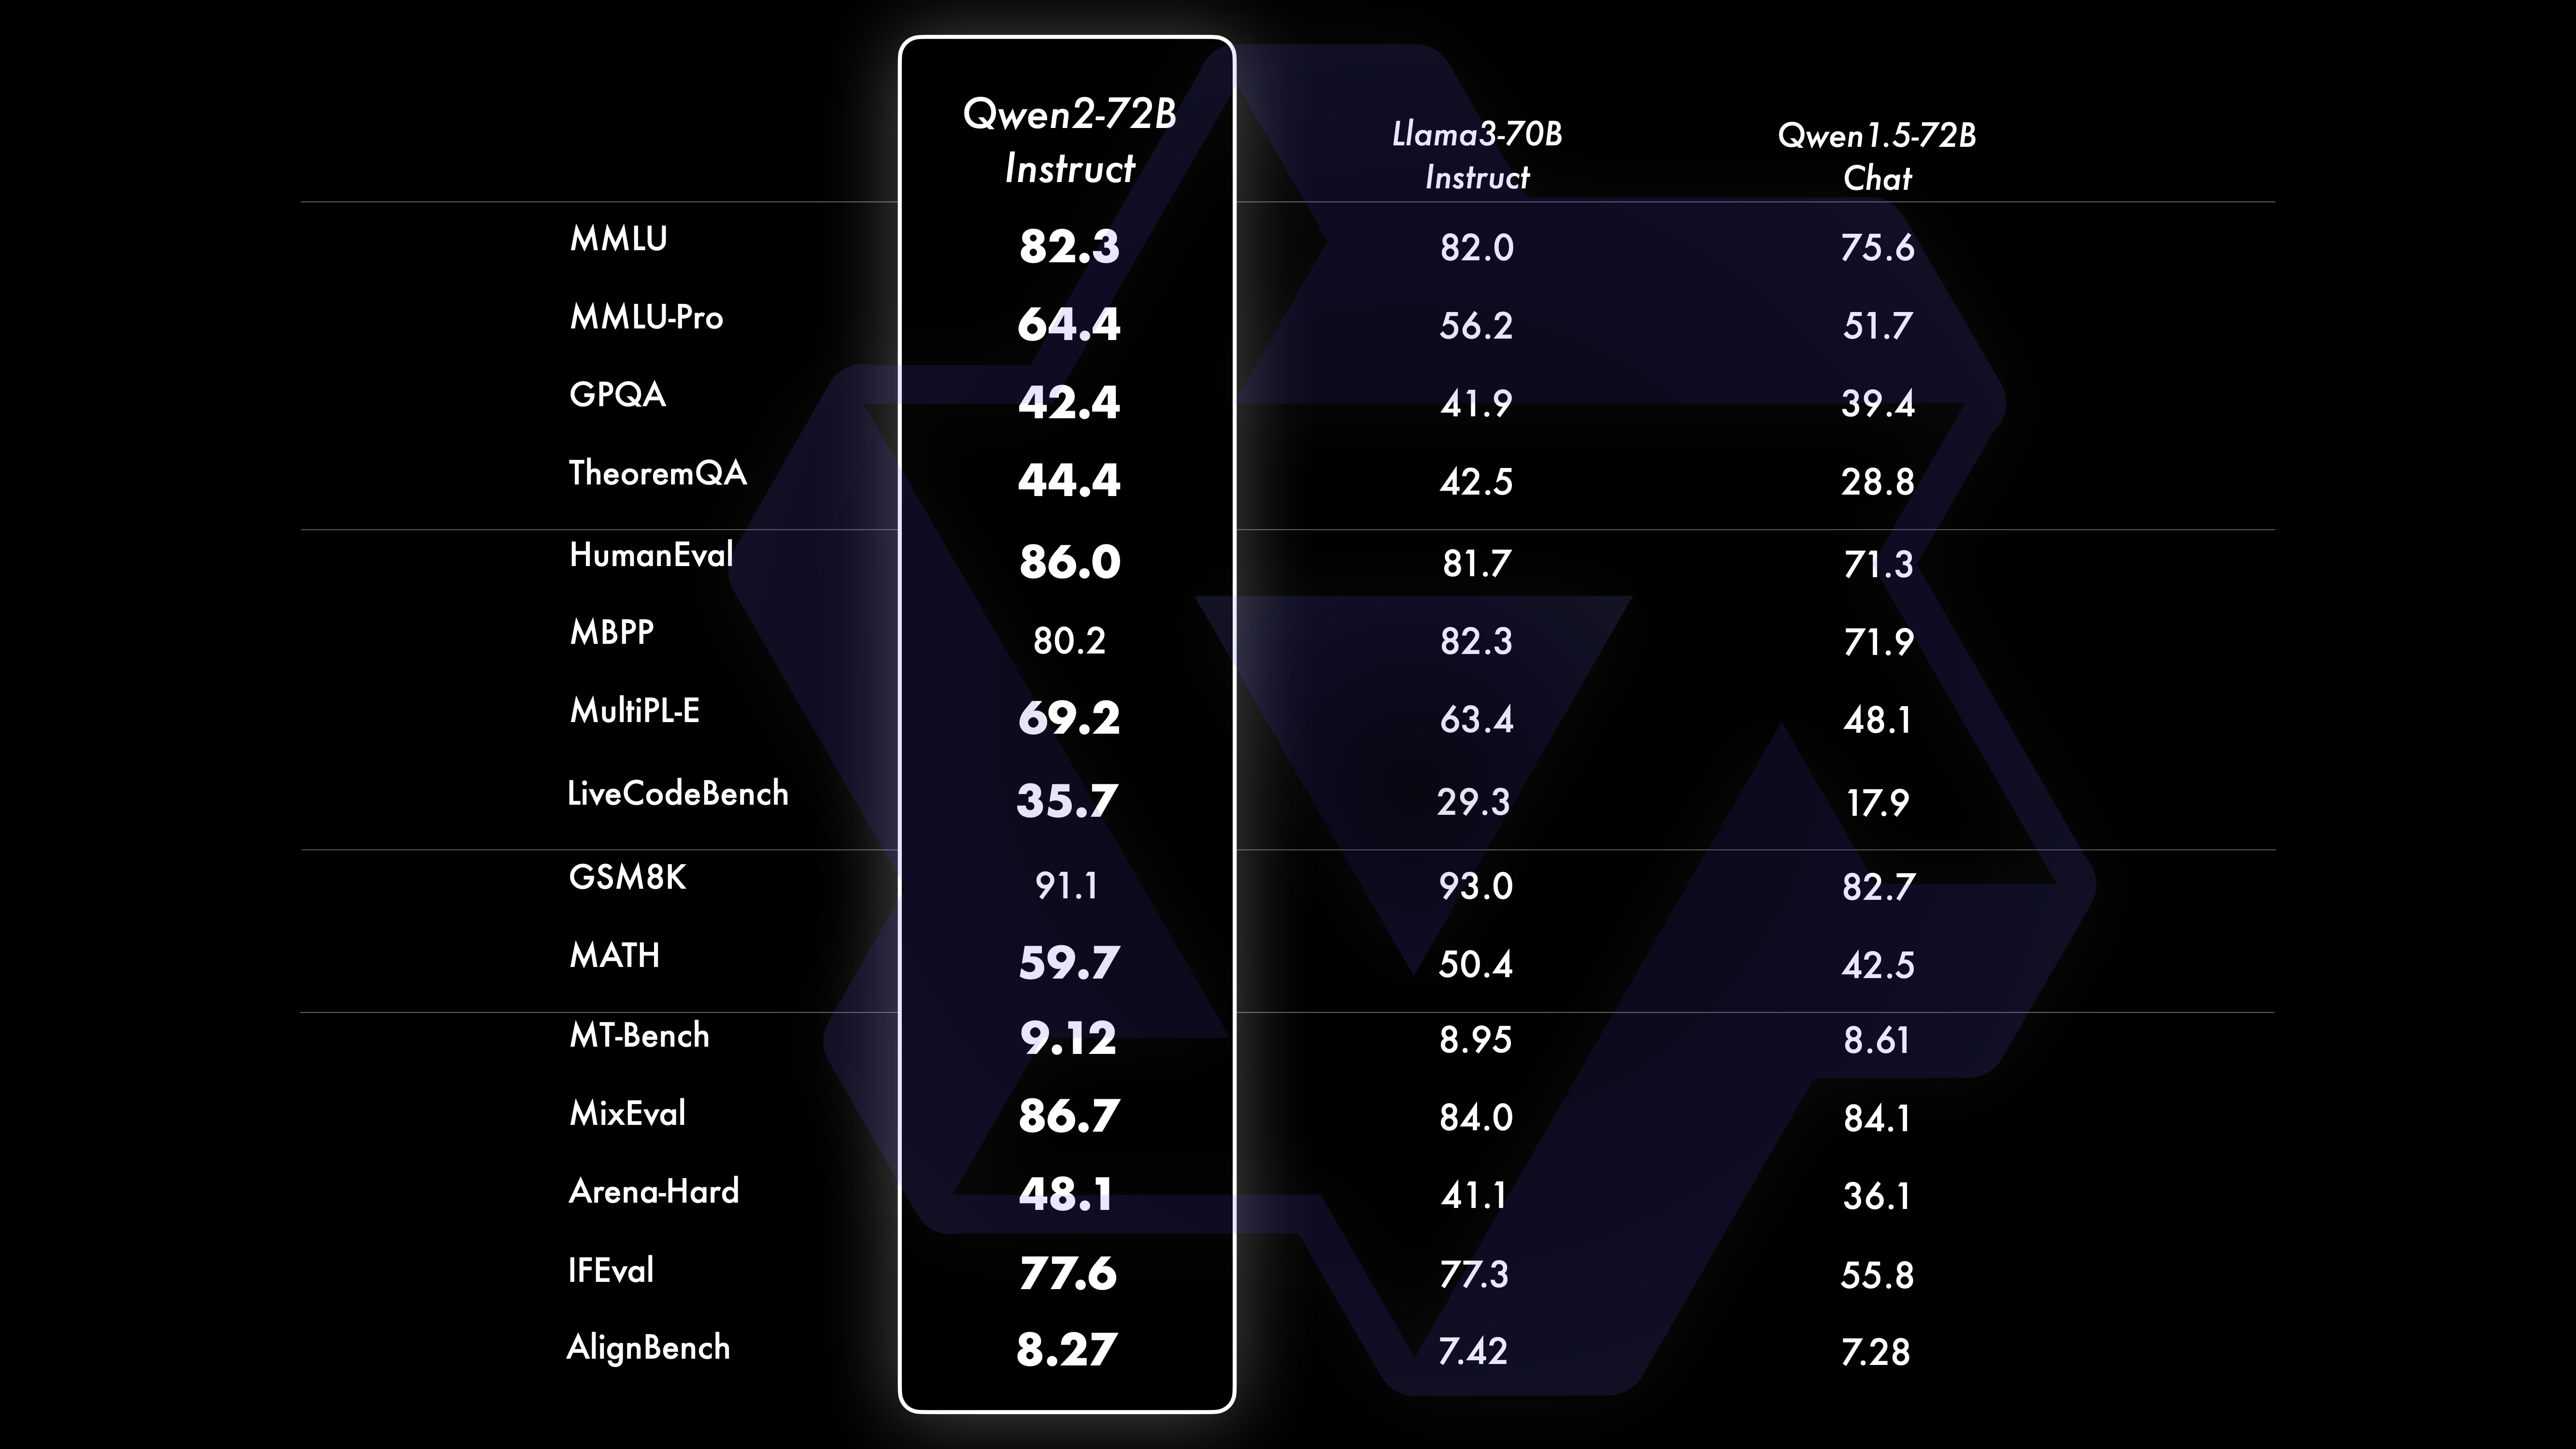
Tras un extenso preentrenamiento a gran escala, llevamos a cabo un post-entrenamiento para mejorar aún más la inteligencia de Qwen, acercándola a la humana. Este proceso mejora aún más las capacidades del modelo en programación, matemáticas, razonamiento, seguimiento de instrucciones, comprensión multilingüe y otros campos. Además, alinea la salida del modelo con los valores humanos, garantizando que sea útil, honesto e inofensivo. Nuestro diseño de la fase de post-entrenamiento sigue el principio de entrenamiento escalable y requiere una cantidad mínima de anotaciones humanas. En concreto, investigamos cómo obtener datos de demostración y datos de preferencias de alta calidad, fiables, diversificados y creativos a través de diversas estrategias de alineación automática, como el muestreo por rechazo para matemáticas, la retroalimentación de ejecución para programación y seguimiento de instrucciones, la retroalimentación negativa de escritura creativa, y la supervisión escalable para el juego de roles. En el entrenamiento, adoptamos una combinación de ajuste fino supervisado, entrenamiento del modelo de recompensa y entrenamiento DPO en línea. También empleamos un novedoso optimizador de fusión en línea para minimizar el impuesto de alineación. Estos esfuerzos colectivos mejoran significativamente las capacidades e inteligencia de nuestro modelo, como se muestra en la siguiente tabla.
¿Qué viene después para Qwen2?
Estamos entrenando un modelo Qwen2 aún más grande para explorar más a fondo la escalabilidad del modelo y nuestra reciente escalabilidad de datos. Además, ampliaremos el modelo de lenguaje Qwen2 a multimodal, capaz de comprender información visual y de audio. En un futuro próximo, seguiremos lanzando nuevos modelos de código abierto, acelerando el código abierto de ai. ¡Manténganse al tanto!
Github:https://github.com/QwenLM/Qwen2
Enlace de descarga:https://modelscope.cn/organization/qwen
Enlace de experiencia:https://modelscope.cn/studios/opencompass/CompassArena/summary
Introducción detallada:https://qwenlm.github.io/blog/qwen2/









