
 Asistente de guiones▸
 Apps AI
 Noticias AI
Stable Diffusion 3: ¿qué mejoras y novedades trae?
小编 ·

Stable Diffusion 3: ¿qué mejoras y novedades trae?
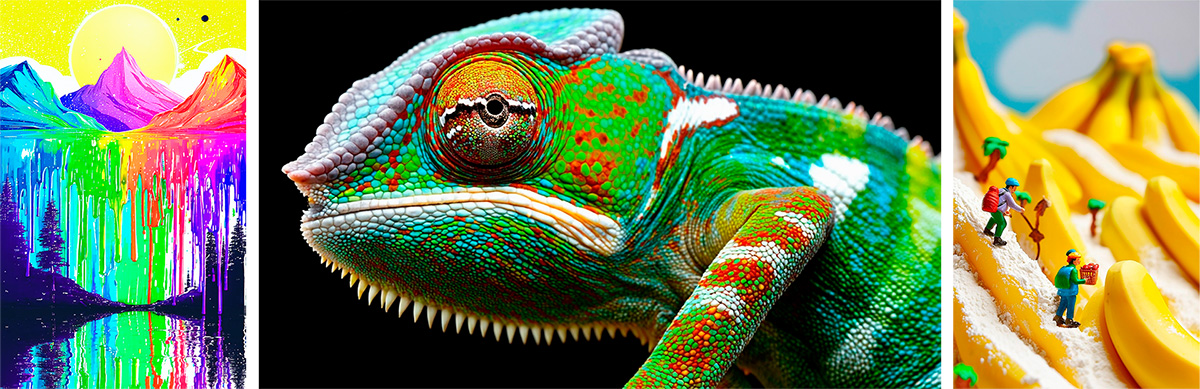
El jueves, Stability AI anunció el lanzamiento de Stable Diffusion 3, la versión más reciente y potente del modelo de generación de imágenes con ia de la compañía. El modelo emplea una arquitectura de transformador de difusión, lo que mejora significativamente el rendimiento en prompts con múltiples temas, la calidad de imagen y las capacidades ortográficas.
Stable Diffusion 3 utiliza un "transformador de difusión" actualizado, una tecnología pionera en 2022 pero revisada en 2023, y que ahora es escalable. El impresionante generador de vídeos de OpenAI, Sora, aparentemente también sigue un principio similar (uno de los coautores del artículo, Will Peebles, continuó codirigiendo el proyecto Sora). La familia de modelos Stable Diffusion 3 (que toman descripciones de texto llamadas "prompts" y las convierten en imágenes coincidentes) varía en tamaño desde 800 millones hasta 8 mil millones de parámetros. El rango de tamaños permite que diferentes versiones del modelo se ejecuten localmente en diversos dispositivos, desde teléfonos inteligentes hasta servidores.
Mejoras de rendimiento y avances de Stable Diffusion 3:
1. Mayor capacidad de procesamiento multitema: el nuevo modelo mejora significativamente la comprensión y el procesamiento de prompts que contienen varios temas o elementos. Esto permite a los usuarios describir escenas más complejas en un único prompt, y el modelo puede generar imágenes con mayor precisión basándose en esas descripciones.
2. Mejora en la calidad de imagen: Stable Diffusion 3 logra avances notables en la calidad de las imágenes generadas, incluyendo una representación de detalles más fina, una coincidencia de colores más precisa y efectos de luz y sombra más naturales. Estos avances hacen que las imágenes generadas sean más realistas y capten mejor la intención del usuario.
3. Mejora de la ortografía y el procesamiento de texto: esta versión muestra una mejor ortografía y comprensión de texto al procesar imágenes que contienen elementos textuales (por ejemplo, lemas, etiquetas, etc.). Esto significa que el modelo puede reconocer y representar con mayor precisión el texto presente en los prompts, incluso en contextos visuales complejos.
4. Adopción de una nueva tecnología de transformador de difusión: Stable Diffusion 3 introduce una nueva técnica de transformador de difusión, similar a la de Sora, que dota al modelo de una capacidad de generación de imágenes más potente. El transformador es un modelo de aprendizaje profundo diseñado para construir los detalles de la imagen de forma progresiva, generando contenido visual de alta calidad.
5. Flujo matching y otras mejoras técnicas: el modelo incorpora la técnica de flujo matching y otras mejoras técnicas para elevar aún más la calidad y la diversidad de las imágenes generadas. La técnica de flujo matching ayuda al modelo a comprender y simular mejor los elementos dinámicos y las estructuras de las imágenes, haciendo que las imágenes resultantes sean visualmente más coherentes y naturales.
6. Aprovechamiento de los avances en la tecnología Transformer: Stable Diffusion 3 aprovecha al máximo los últimos avances en la tecnología Transformer, no solo ampliando las capacidades del modelo, sino permitiéndole también procesar entradas multimodales. Esto significa que el modelo puede manejar tipos de datos más complejos y diversos, como entradas que combinan texto e imagen, ofreciendo mayor flexibilidad y precisión en la comprensión y generación de contenido visual.
Aunque ya se han mencionado algunas innovaciones técnicas clave, Stability AI planea publicar pronto más detalles técnicos. Estos detalles proporcionarán a la comunidad tecnológica y a los usuarios interesados una comprensión profunda de los fundamentos técnicos y las novedades de Stable Diffusion 3.
Aunque Stable Diffusion 3 aún no está ampliamente disponible, Stability afirma que, una vez finalizadas las pruebas, los usuarios podrán descargar sus pesos de forma gratuita y ejecutarlo en entornos locales. Stability señaló en su comunicado: "Al igual que en la fase de preestreno de modelos anteriores, esta fase es extremadamente importante para recopilar comentarios, optimizar el rendimiento y mejorar la seguridad antes del lanzamiento oficial."
Recientemente, Stability ha estado explorando múltiples técnicas de síntesis de imágenes. Además de SDXL y SDXL Turbo, la compañía también presentó la semana pasada Stable Cascade, una técnica de síntesis que genera imágenes a partir de texto mediante un proceso de tres etapas. Además, otro producto de texto a vídeo y de imagen a vídeo de Stability AI, Stable Video, también se lanzó en esta beta pública, ofreciendo a los usuarios más opciones.









