
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Story-Iter: Lösung zur Visualisierung langer Geschichten von UCSC-VLAA
Story-Iter: Lösung zur Visualisierung langer Geschichten von UCSC-VLAAEinführung
Was ist Story-Iter?
Story-Iter ist eine von UCSC-VLAA vorgeschlagene Lösung zur Visualisierung langer Geschichten. Diese Aufgabe erfordert die Generierung kohärenter Bildsequenzen auf Basis narrativer Texte und unterstützt lange Story-Szenen mit bis zu 100 Frames .
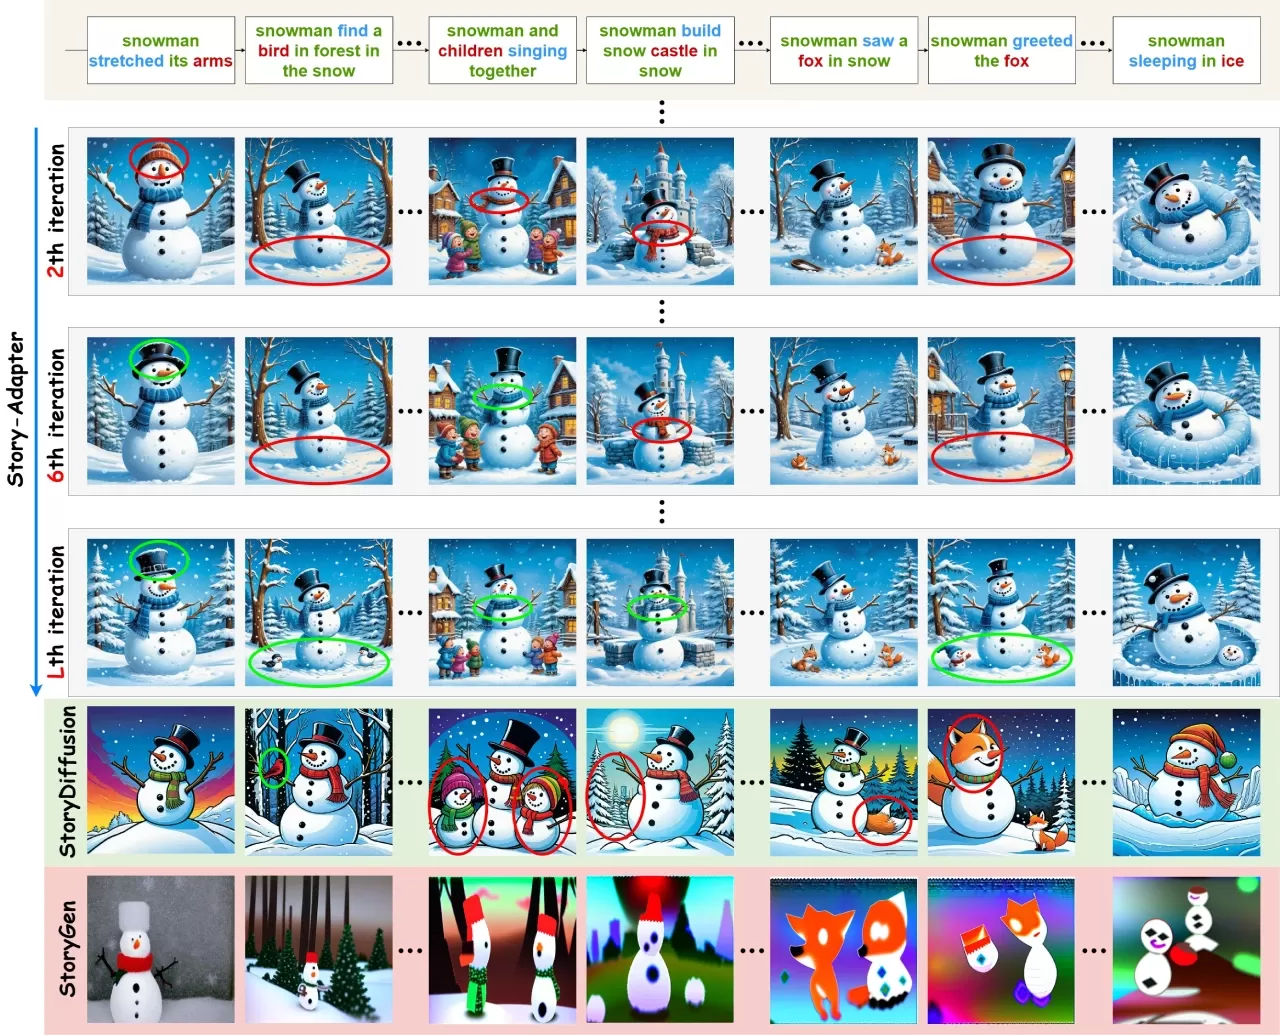
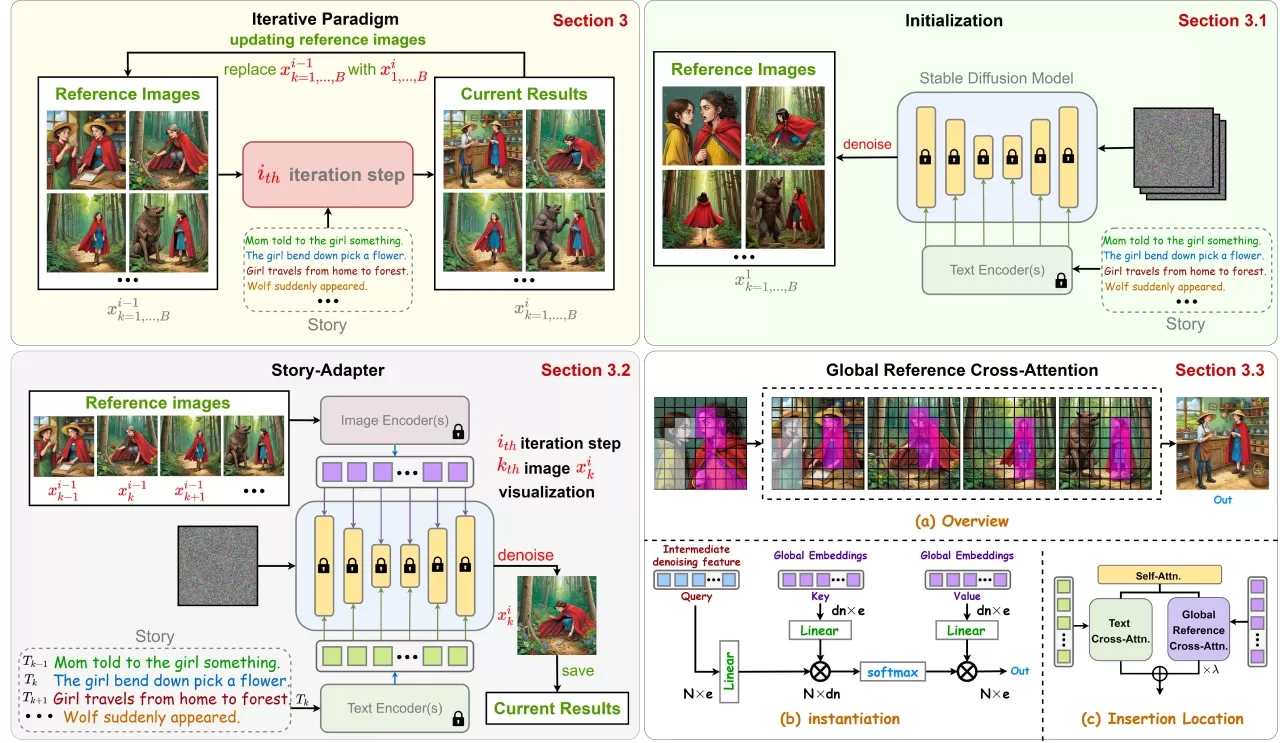
Im Gegensatz zu autoregressiven Methoden verwendet Story-Iter einen externen Iterationsmechanismus – zusätzlich zu den Entrauschungsschritten innerhalb des Diffusionsmodells wird eine zusätzliche Iterationsschleife eingeführt, die die Qualität jedes Frames durch kontinuierliche Integration aller in der vorherigen Runde generierten Referenzbilder optimiert .
🔧 Funktionsmerkmale von Story-Iter
1. Global Reference Cross-Attention-Modul
Plug-and-Play: Kein Training erforderlich, direkte Integration in bestehende Diffusionsmodelle (z. B. Stable Diffusion)
Globale Einbettung: Verwendung globaler Einbettungen zur Modellierung aller Referenzframes, um die semantische Konsistenz über lange Sequenzen hinweg zu gewährleisten
Cross-Attention-Mechanismus: Aggregation des Informationsflusses aller Referenzbilder während des Bildgenerierungsprozesses
2. Iteratives Optimierungsparadigma
Initialisierungsphase: Generierung einer ersten Version jedes Frames basierend auf den Story-Textprompts
Iterative Verfeinerung: Alle in der vorherigen Runde generierten Bilder dienen als Referenz für die nächste Runde, mit schrittweiser Optimierung
Inkrementelle Verbesserung: Durch wiederholte Integration des gesamten visuellen Kontexts und der Textvorgaben wird eine präzise, feinkörnige Interaktionsgenerierung erreicht
3. Unterstützung langer Sequenzen
Unterstützung der Generierung von Story-Bildsequenzen mit bis zu 100 Frames
Hervorragende Leistung in Bezug auf semantische Konsistenz und feinkörnige Interaktionen
🎯 Anwendungsbereiche von Story-Iter
Comic-/Bilderbuch-Generierung: Automatische Erstellung kohärenter Comic-Seiten basierend auf langen Storytexten
Animations-Previsualization: Bereitstellung visueller Vorschauen auf Storyboard-Ebene für die Animationsproduktion
Film-Storyboards: Unterstützung von Regisseuren und Kameraleuten bei der schnellen Erstellung von Shot-Skizzen
Kinderbücher: Erstellung reich illustrierter narrativer Bücher für Bildungsinhalte
Werbung & Kreation: Generierung langer visueller Produktgeschichten
Game-Cinematics: Erstellung fortlaufender visueller Erzählungen für Spielgeschichten
✅ Vor- und Nachteile von Story-Iter
Vorteile
Trainingsfrei: Kein zusätzliches Modelltraining erforderlich, Plug-and-Play
Recheneffizient: Geringere Rechenkosten im Vergleich zu Methoden, die große multimodale Encoder einführen
Konsistenzgarantie: Effektive Aufrechterhaltung der Charakter-, Szenen- und Stil-Konsistenz über lange Sequenzen durch den globalen Referenzmechanismus
Feinkörnige Interaktionen: Fähigkeit zur Generierung hochwertiger Szenen mit komplexen Personeninteraktionen
Skalierbarkeit: Unterstützung von Story-Generierung mit bis zu 100 Frames, weit über traditionelle Methoden hinaus
Nachteile
Iterations-Overhead: Obwohl trainingsfrei, erfordert der Iterationsprozess mehrere Inferenzdurchläufe mit hohem Zeitaufwand
Abhängigkeit vom Basismodell: Die Leistung ist durch die Fähigkeiten des zugrundeliegenden Diffusionsmodells (z. B. SD) begrenzt
Herausforderungen bei langen Geschichten: Trotz Unterstützung von 100 Frames kann es bei extrem langen Geschichten zu Konsistenzdrift kommen
Kein offizieller Code: Das GitHub-Repository ist möglicherweise noch nicht vollständig öffentlich oder befindet sich in einer frühen Phase
🛠️ Nutzungsanleitung für Story-Iter
Umgebungseinrichtung
# Repository klonen (angenommen bereits öffentlich)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# Abhängigkeiten installieren
pip install -r requirements.txt
Grundlegender Arbeitsablauf
Storytext vorbereiten: Zerlegen Sie die Geschichte in fortlaufende Textbeschreibungen (ein Frame pro Beschreibung)
Initialisierungsgenerierung: Führen Sie die erste Generierungsrunde aus, um die initiale Bildsequenz allein auf Basis der Textprompts zu erstellen
Iterative Optimierung:
Verwenden Sie die generierten Bilder als Referenz für die nächste Generierungsrunde
Aktivieren Sie das GRCA-Modul, um globale Referenzinformationen zu aggregieren
Wiederholen Sie die Iteration bis zur Konvergenz oder bis zur vorher festgelegten Iterationsanzahl
Ergebnisse ausgeben: Erhalten Sie die finale, optimierte kohärente Story-Bildsequenz
Wichtige Parameter
--num_iterations: Anzahl der Iterationen (in der Regel 3–5 für deutliche Verbesserungen)
--use_grca: Aktiviert das Global Reference Cross-Attention-Modul
--num_frames: Anzahl der Story-Frames (bis zu 100 unterstützt)
❓ Häufig gestellte Fragen zu Story-Iter
F1: Welche Beziehung besteht zwischen Story-Iter und Story-Adapter?
Laut arXiv-Informationen sind Story-Iter und Story-Adapter unterschiedliche Bezeichnungen für dasselbe Projekt. Die Paper-Referenz lautet Story-Adapter: A Training-free Iterative Framework for Long Story Visualization, während sowohl auf der Projektseite als auch bei der ICLR 2026-Einreichung der Name Story-Iter verwendet wird .
F2: Muss ich ein eigenes Modell trainieren?
Nein. Story-Iter ist ein trainingsfreies Framework (training-free), das direkt auf vortrainierten Stable-Diffusion-Modellen angewendet werden kann .
F3: Welche Basismodelle werden unterstützt?
Hauptsächlich Modelle der Stable-Diffusion-Reihe (z. B. SD 1.5, SDXL), deren Funktionalität durch Einfügen des GRCA-Moduls erweitert wird .
F4: Wie lange dauert die Generierung einer 100-Frame-Story?
Die genaue Dauer hängt von der Hardwarekonfiguration und der Anzahl der Iterationen ab. Aufgrund des iterativen Optimierungsmechanismus gilt: Gesamtzeit = Zeit pro Frame × Anzahl Frames × Anzahl Iterationen. Eine A100-GPU kann die Generierung deutlich beschleunigen.
F5: Wie wird die Charakterkonsistenz sichergestellt?
Durch den globalen Referenzmechanismus des GRCA-Moduls werden in jeder Iteration Informationen aller bereits generierten Frames aggregiert, wodurch Aussehen, Kleidung und Szenenelemente der Charaktere über die gesamte Geschichte hinweg konsistent bleiben .
📚 Verwandte Ressourcen
Projektseite: https://jwmao1.github.io/storyiter/
Paper: https://arxiv.org/abs/2410.06244
GitHub-Repository: https://github.com/UCSC-VLAA/story-iter
Zugehörige Einrichtung: UCSC-VLAA (Vision Language and Artificial Intelligence Lab, University of California, Santa Cruz)














