Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

Scrapeless_云技派,专注ai人工智能!
Scrapeless_云技派,专注ai人工智能!Einführung
Was ist Scrapeless?
Scrapeless ist ein KI-gestütztes Web-Scraping-Tool, das strukturierte Daten effizient von Websites extrahiert. Es unterstützt den Headless-Browser-Modus, umgeht automatisch Captchas und IP-Sperren und bietet hochwertige Proxy-Dienste, die mehr als 195 Länder weltweit abdecken. Seine Scraping-API ist einfach zu bedienen und eignet sich für die großflächige Datenerfassung durch Unternehmen und Entwickler. Die Funktionen zur Datenbereinigung und -umwandlung stellen sicher, dass die Daten genau und nutzbar sind. Scrapeless bietet eine kostenlose Testversion, die eine effiziente Datenerfassung unterstützt.
Kerntools von Scrapeless
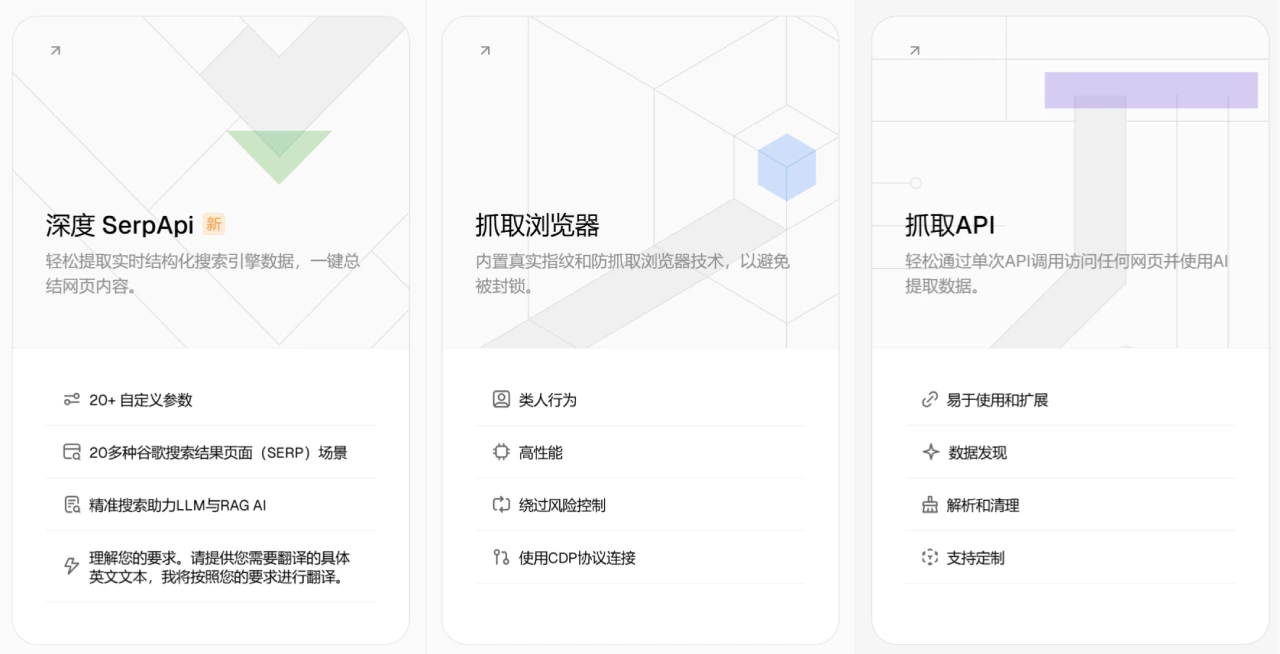
Scraping-API: Ermöglicht das Abrufen strukturierter Daten von jeder Website über einen einzigen API-Aufruf, ideal für die großflächige Datenextraktion.
Scraping-Browser: KI-gesteuert, unterstützt den Headless-Browser-Modus, kann das Verhalten echter Benutzer simulieren und dynamische Inhalte mühelos scrapen.
Web-Unlocker: Umgeht automatisch Captchas, IP-Sperren und Einschränkungen dynamischer Inhalte und gewährleistet eine ununterbrochene Datenerfassung.
Proxy-Dienst: Bietet hochwertige, rotierbare Proxys, die mehr als 195 Länder weltweit abdecken und IP-Sperren vermeiden.
Captcha-Löser: Löst automatisch verschiedene Captchas wie reCAPTCHA und Cloudflare und sorgt für einen reibungslosen Scraping-Ablauf.
Vorteile von Scrapeless
Effiziente Datenextraktion: Extrahiert schnell und genau Daten von komplexen Websites und unterstützt hohe Parallelität sowie leistungsstarkes Scraping.
Flexible Anpassung: Bietet maßgeschneiderte Lösungen je nach Unternehmensanforderungen, um verschiedene Geschäftsszenarien zu erfüllen.
Datenbereinigung und -umwandlung: Verbessert die Genauigkeit und Verwendbarkeit der Daten und wandelt Rohdaten in wertvolle Informationen um.
Sicherheit und Datenschutz: Verwendet fortschrittliche Sicherheitsmaßnahmen, hält Compliance-Standards strikt ein und schützt Benutzerdaten.
Kosteneffizienz: Sie zahlen nur für erfolgreiche Anfragen, mit flexiblen Preisplänen.
Anwendungsszenarien von Scrapeless
Unternehmensweites Web-Scraping: Bietet hochwertige, maßgeschneiderte Web-Scraping-Lösungen für geschäftskritische Projekte.
Echtzeit-Datenbereitstellung: Stellt durch leistungsstarke API-Integration sicher, dass Anwendungen mit den neuesten Informationen synchron bleiben.
Automatisierte Arbeitsabläufe: Vereinfacht die Datenerfassung, reduziert manuelle Eingriffe und steigert die Arbeitseffizienz.
Zielgruppe von Scrapeless
Unternehmen: Organisationen, die eine großflächige und effiziente Datenerfassung benötigen.
Entwickler: Programmierer, die Daten schnell und einfach aus dem Web abrufen möchten.
Datenanalysten: Fachleute, die zuverlässige und effiziente Tools zur Datenextraktion benötigen.
Nutzungsanleitung für Scrapeless
1. Konto registrieren: Besuchen Sie die offizielle Website von Scrapeless und registrieren Sie sich für ein kostenloses Testkonto – während der Testphase ist keine Kreditkarte erforderlich.
2. API-Schlüssel abrufen: Nach der Registrierung und Anmeldung erhalten Sie im Dashboard Ihren API-Schlüssel, der zur Authentifizierung von Anfragen dient.
3. Tool auswählen: Wählen Sie je nach Bedarf zwischen Scraping-Browser, Scraping-API, Web-Unlocker, Captcha-Löser oder Proxy-Dienst.
4. SDK installieren: Installieren Sie das Scrapeless SDK für Ihre Programmiersprache, z. B. Python, Node.js usw.
5. Anfrage senden: Senden Sie Anfragen mit Ihrem API-Schlüssel. Eine Basisanfrage muss die Ziel-URL und die Authentifizierungsdaten enthalten. Ein Beispiel für den Aufruf der Scraping-API mit Python:
import requests
import json
API_KEY = "your_api_key"
host = "api.scrapeless.com"
url = f"https://{host}/api/v1/unlocker/request"
payload = json.dumps({
   "actor": "unlocker.webunlocker",
   "input": {
      "url": "https://httpbin.io/get",
      "redirect": False,
      "method": "GET",
   },
   "proxy":{
       "country": "ANY",
   }
})
headers = {
   'Content-Type': 'application/json',
   'x-api-token': f'{API_KEY}'
}
response = requests.request("POST", url, headers=headers, data=payload)
print(response.text)
6. Antwort verarbeiten: Die im JSON-Format zurückgegebenen Scraping-Daten sind bereits bereinigt und strukturiert und können direkt verwendet werden.
7. Scraping skalieren: Erhöhen Sie bei Bedarf die Anzahl gleichzeitiger Anfragen und das Scraping-Volumen – Scrapeless übernimmt automatisch Anti-Bot-Maßnahmen.
8. Nutzung überwachen: Verfolgen Sie im Dashboard die API-Nutzung, die Erfolgsquote und das verbleibende Guthaben.
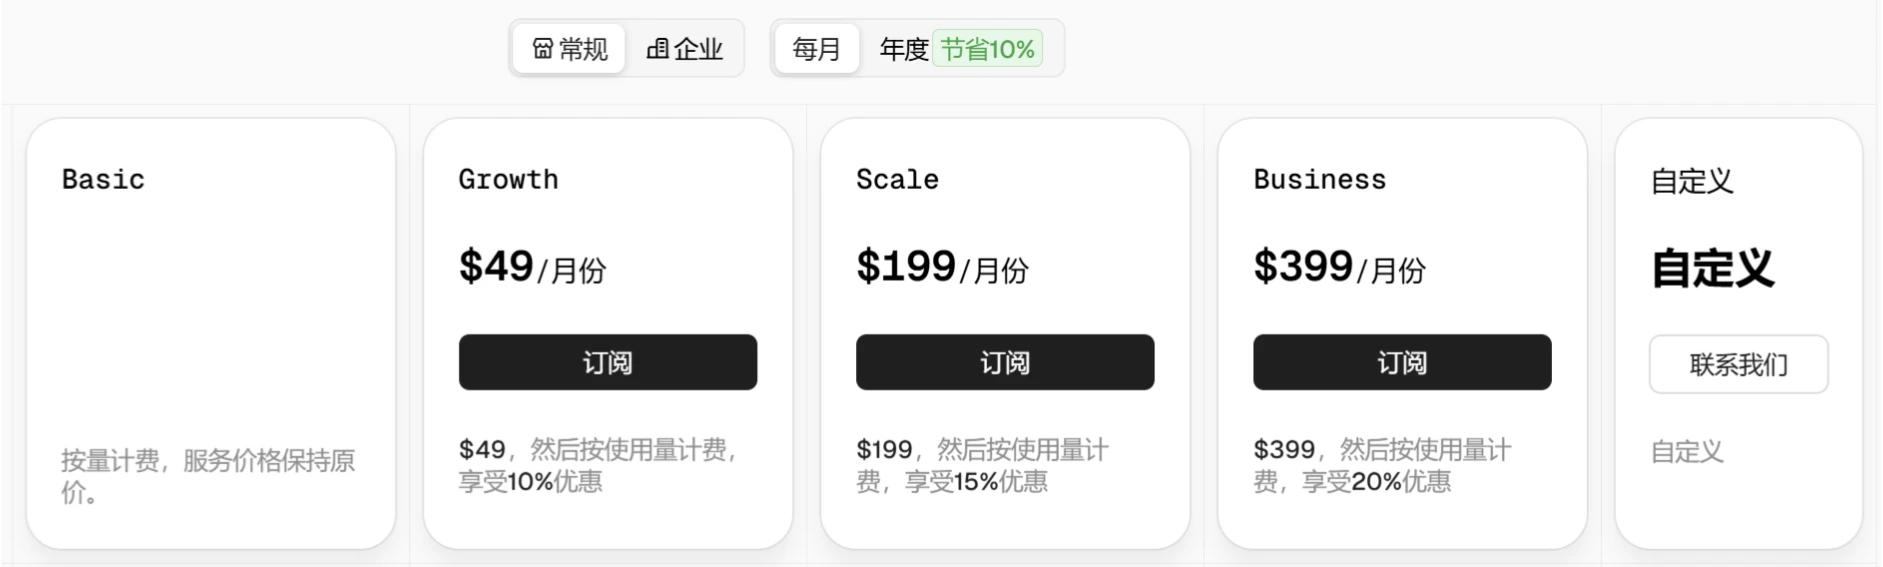
Preise von Scrapeless