
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Spark-TTS: effizientes TTS-System mit Zero-Shot-Stimmklonung und mehrsprachiger Sprachsynthese
Spark-TTS: effizientes TTS-System mit Zero-Shot-Stimmklonung und mehrsprachiger SprachsyntheseEinführung
Was ist Spark-TTS?
Spark-TTS ist ein von dem SparkAudio-Team entwickeltes Text-to-Speech (TTS)-System, das auf Qwen2.5 aufbaut und Tonhöhe, Geschwindigkeit sowie Sprecherstil direkt aus dem Text steuert. Es unterstützt Zero-Shot-Sprachklonung, mehrsprachige Synthese, feinkörnige Sprachsteuerung sowie Sprachgenerierung über eine Web-UI und kann Text schnell in natürliche, hochwertige Sprachinhalte umwandeln. Im Gegensatz zu traditionellen TTS-Systemen rekonstruiert es Audio direkt aus den vom LLM vorhergesagten Kodierungen, was den Sprachgenerierungsprozess vereinfacht und die Effizienz steigert.
Kernfunktionen von Spark-TTS
Zero-Shot-Sprachklonung: Spark-TTS unterstützt Zero-Shot-Sprachklonung und kann die Stimme eines Sprechers auch ohne spezifische Trainingsdaten dieses Sprechers reproduzieren. In Szenarien mit sprachübergreifender Synthese und Code-Switching wechselt es nahtlos zwischen verschiedenen Sprachen und Sprechern.
Mehrsprachige Unterstützung: Das System unterstützt Chinesisch und Englisch und gewährleistet bei sprachübergreifender Synthese eine hohe Natürlichkeit und Genauigkeit. Gibt der Nutzer Text in einer Sprache ein, erhält er die Sprachausgabe in einer anderen Sprache.
Feinkörnige Sprachsteuerung: Nutzer können die Stimme eines virtuellen Sprechers durch Anpassung von Geschlecht, Tonhöhe, Sprechgeschwindigkeit und weiteren Parametern individuell gestalten, um den Anforderungen unterschiedlicher Szenarien wie virtuelle Nachrichtensprecher oder Hörbücher gerecht zu werden.
Effiziente Sprachsynthese: Spark-TTS basiert vollständig auf der Qwen2.5-Architektur, benötigt keine zusätzlichen Generierungsmodelle und rekonstruiert Audio direkt aus den vom LLM vorhergesagten Kodierungen, wodurch der Prozess vereinfacht und die Komplexität reduziert wird.
Erstellung virtueller Sprecher: Nutzer können eigene virtuelle Sprecher erstellen und ihnen durch Anpassung der Parameter einen einzigartigen Sprachstil verleihen.
Technische Architektur von Spark-TTS
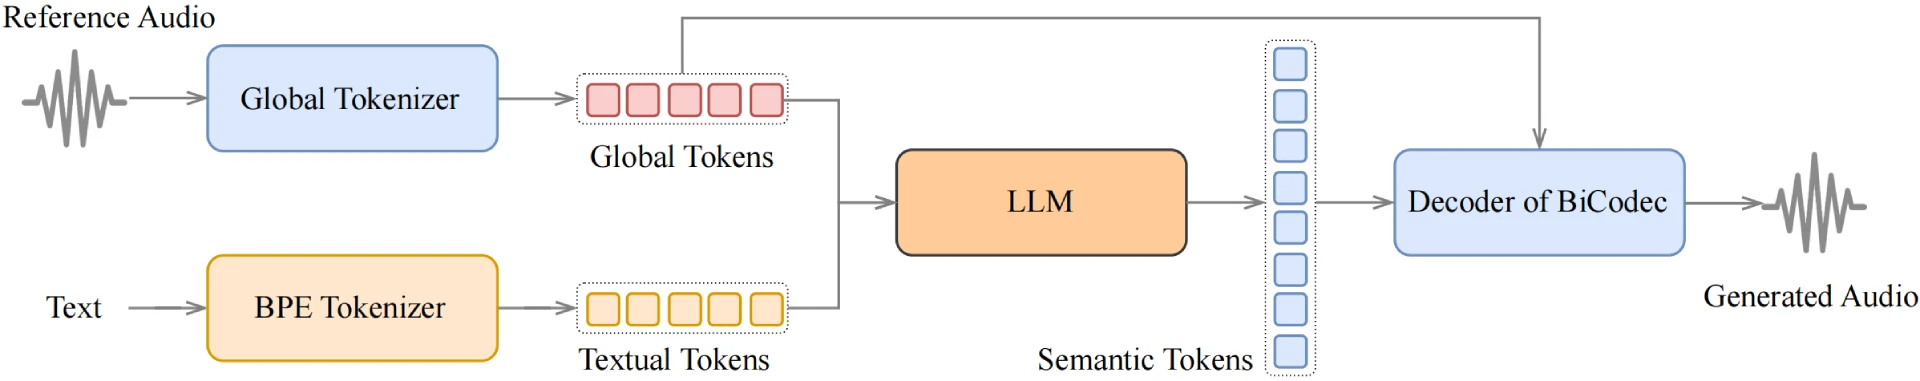
Die technische Grundlage von Spark-TTS ist der BiCodec Single-Stream-Sprachcodec, der Sprache in niedrigbitratige semantische Tokens (für den sprachlichen Inhalt) und globalen Tokens fester Länge (für die Sprechereigenschaften) zerlegt. Diese Trennung erleichtert die flexible Anpassung der Sprachmerkmale. In Kombination mit der Chain-of-Thought-Technologie von Qwen2.5 werden Qualität und Steuerbarkeit der Sprachgenerierung weiter verbessert.
Anwendungsszenarien
Hörbuchproduktion: Die natürliche Sprachqualität eignet sich besonders gut für Hörbücher.
Virtuelle Nachrichtensprecher: Durch Anpassung der Sprachparameter können virtuelle Sprecher erzeugt werden, die spezifischen Anforderungen entsprechen.
Sprachübergreifende Sprachsynthese: Unterstützt mehrere Sprachen und erweitert so die weltweite Einsetzbarkeit.
Installation und Nutzung von Spark-TTS
1. Vorbereitung der Umgebung
Python installieren: Stellen Sie sicher, dass Python 3.12 installiert ist.
Conda installieren: Dient zur Verwaltung virtueller Umgebungen und kann von der offiziellen Miniconda-Website heruntergeladen und installiert werden.
2. Repository klonen
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. Abhängigkeiten installieren
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
Wenn Sie sich in China (Festland) befinden, können Sie den Alibaba-Cloud-Spiegel verwenden:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. Vortrainierte Modelle herunterladen
Laden Sie die vortrainierten Modelle mit dem folgenden Befehl herunter:
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5. Grundlegende Nutzung
Führen Sie den folgenden Befehl aus, um eine Sprachsynthese durchzuführen:
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Nutzung der Web-UI
python webui.py --device 0
GitHub-Repository:https://github.com/SparkAudio/Spark-TTS
HuggingFace-Modellbibliothek: https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
Paper: https://arxiv.org/pdf/2503.01710
Demo: https://sparkaudio.github.io/spark-tts/
Verwandte Beiträge:
llasa 3B TTS: Ein auf der LLaMA-Architektur basierendes Text-to-Speech (TTS)-Modell














