
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Step-Audio: erstes Open-Source-Sprachinteraktionsmodell von Stepfun
Step-Audio: erstes Open-Source-Sprachinteraktionsmodell von StepfunEinführung
Step-Audio, als erstes produktionsreifes Open-Source-Sprachinteraktionsmodell der Branche, verfügt über die Fähigkeit, je nach Szenarioanforderungen vielfältige sprachliche Ausdrucksformen zu erzeugen – einschließlich Emotionen, Dialekten, Sprachen, Gesang sowie personalisiertem Stil – und ermöglicht dabei eine natürlich fließende Interaktion. Bei der HSK六级-Evaluierung (Chinesisch-Niveauprüfung Stufe 6) erzielte Step-Audio herausragende Ergebnisse und gilt als das chinesisch-versierteste Open-Source-Modell. Dieses KI-Modell wurde von StepFun und der Geely Automobile Group gemeinsam entwickelt und am 18. Februar 2025 offiziell als Open Source veröffentlicht.
Funktionsmerkmale von Step-Audio:
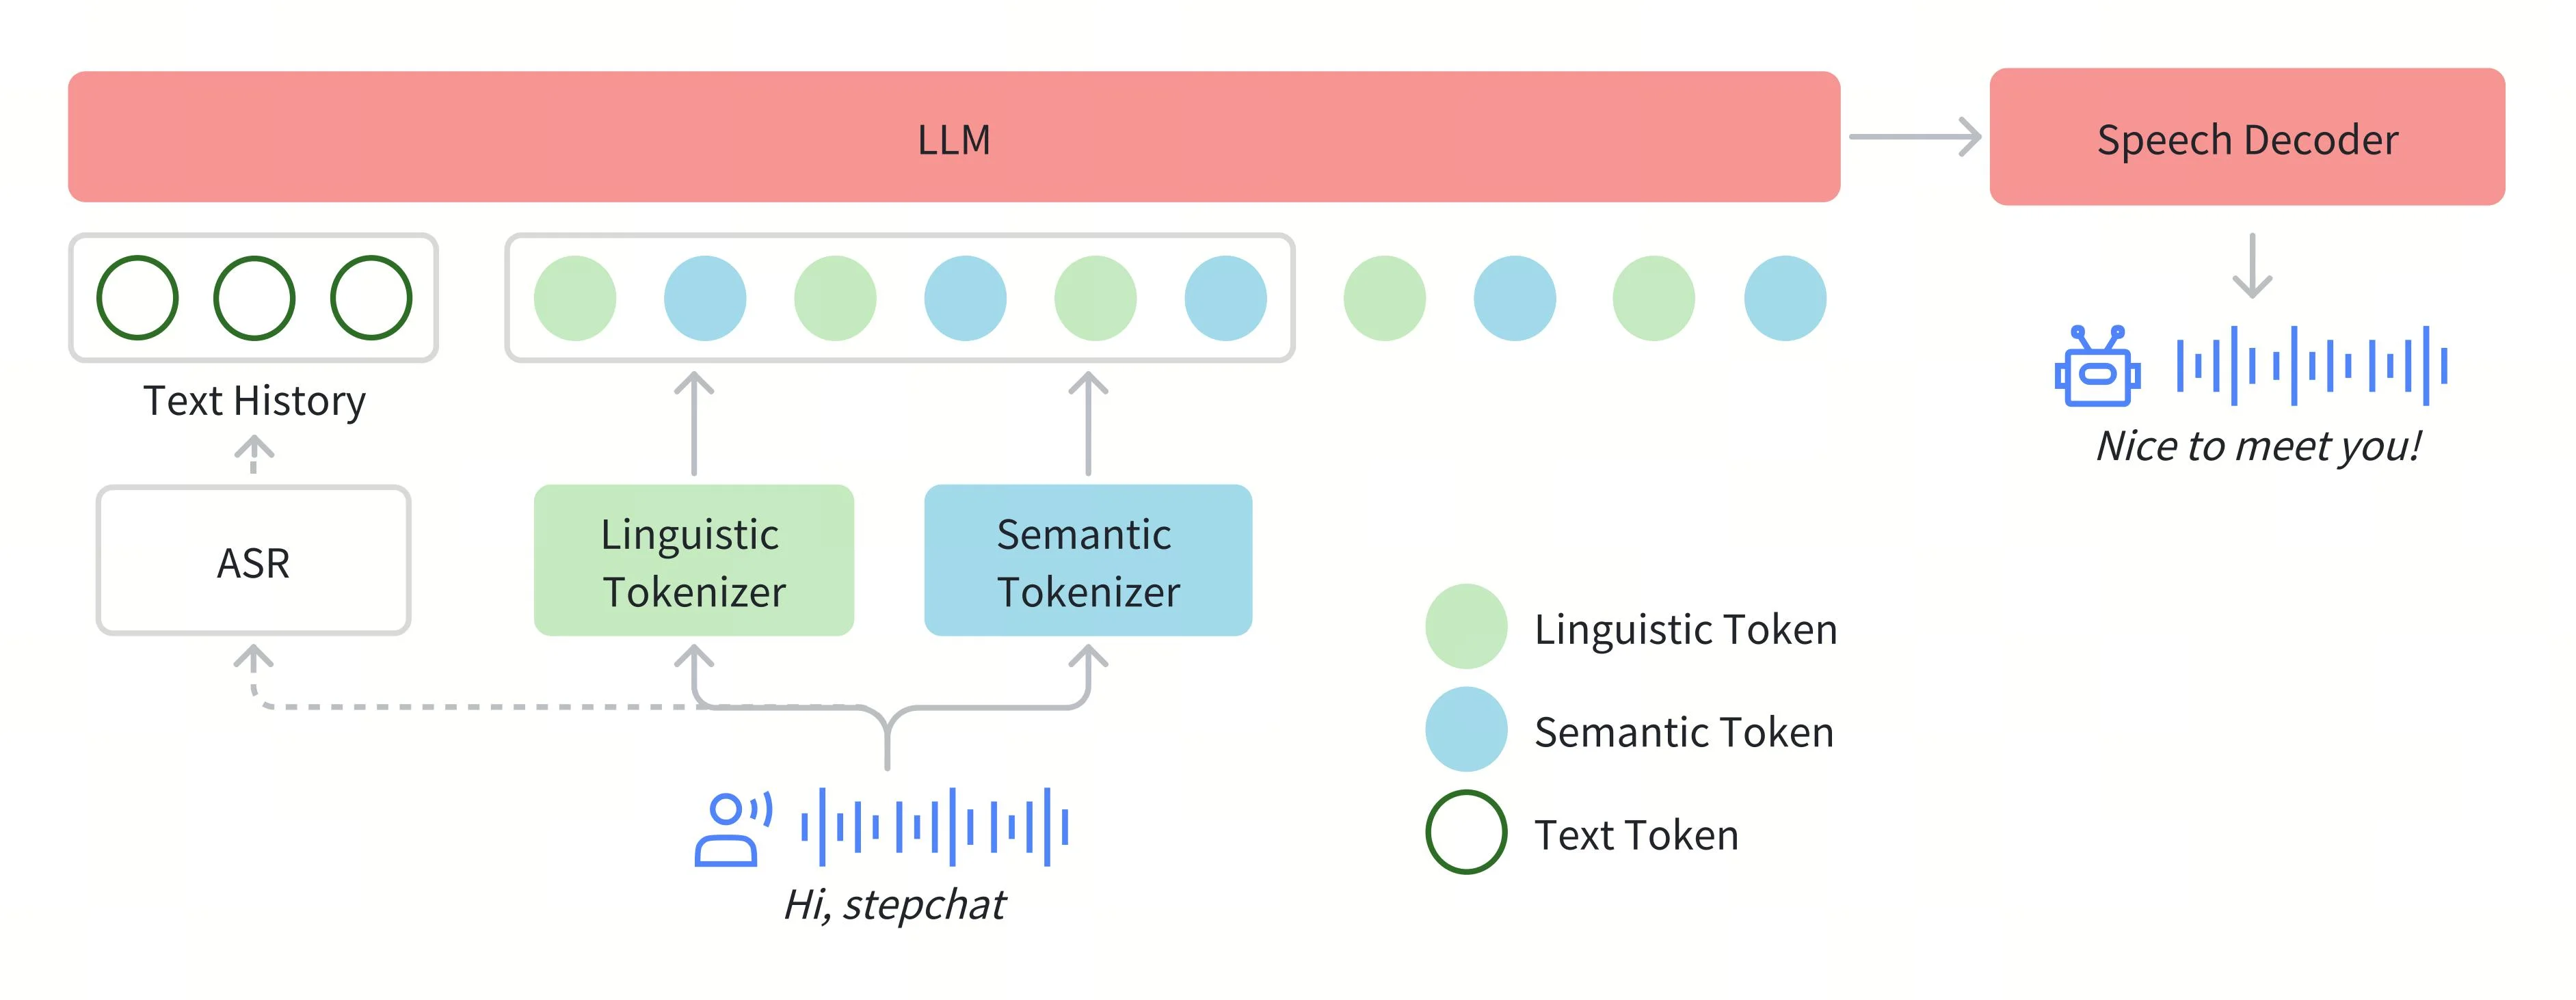
Einheitliches Modell: Basierend auf einem multimodalen Modell mit 13 Milliarden Parametern vereint es Sprachverständnis und -generierung und kann gleichzeitig Spracherkennung, semantisches Verständnis, Dialog, Sprachklonung, Audiobearbeitung und -synthese verarbeiten.
Vielfältige Emotionen und Stile: Erzeugt je nach Bedarf Sprache mit unterschiedlichen Emotionen (wütend/fröhlich/traurig), Dialekten (Kantonesisch/Sichuanesisch usw.), Sprachen, Gesang (RAP/Humming) und personalisierten Stilen – mit präziser Steuerung von Emotionen, Dialekten, Sprachen und Gesang.
Hochwertige Dialoge: Bietet ein natürliches, hochwertiges Dialogerlebnis mit einer Interaktion, die so flüssig wie ein Gespräch mit einem echten Menschen wirkt.
Intelligente Interaktion: Verfügt über fortgeschrittene Interaktionsfähigkeiten wie logisches Schlussfolgern, Kreation, Anweisungssteuerung, Sprache, Rollenspiele und Textspiele.
Anwendungsszenarien von Step-Audio:
Intelligenter Kundenservice: Bietet personalisierte, emotionale Serviceleistungen und verbessert das Nutzererlebnis.
Hörbücher: Erzeugt emotionales Vorlesen und verstärkt das immersive Hörerlebnis.
Audio-Video-Erstellung: Erzeugt automatisch Video-Synchronisation oder Synchronisationen für Animationsfiguren.
Spiele-NPCs: Bietet Spielfiguren eine natürlich fließende Sprachinteraktion.
Besprechungsprotokolle: Wandelt Sprache in Echtzeit in Text um und liefert sprachliche Rückmeldungen.
Bildungsunterstützung: Personalisierte Lehrassistenten, die Unterrichtsstil und Tonfall anpassen.
Technische Merkmale von Step-Audio:
Technologie mit hoher Kompressionsrate: Nutzt hocheffiziente Kompressionstechniken wie Video-VAE zur Optimierung der Datenverarbeitung.
Zweisprachige Verarbeitungsfähigkeit: Verwendet Hunyuan-CLIP und Step-LLM zur Verarbeitung chinesischer und englischer Prompts.
DIT-Architektur und Video-DPO-Algorithmus: Optimiert die Verarbeitung komplexer Video- und Audiodaten.
Training mit umfangreichen Datensätzen: Aufbau großer Datensätze, um Generalisierungsfähigkeit und Detailtreue des Modells sicherzustellen.
Verwendung von Step-Audio:
Modell beziehen: Über die YueWen-App oder Plattformen wie Hugging Face auf die Open-Source-Version von Step-Audio zugreifen.
Technischer Bericht: Technische Berichte auf arxiv.org oder GitHub einsehen, um Details zu erfahren.
API-Schnittstelle: Sprachinteraktion per API-Aufruf realisieren, gemäß der MIT-Open-Source-Lizenz.
Integration und Entwicklung: Gemäß offizieller Dokumentation oder Beispielcode in Anwendungen integrieren.
Individuelles Training: Fortgeschrittene Nutzer können das Modell feinabstimmen, um es an spezifische Szenarien anzupassen oder die Leistung zu verbessern.
Bezugsmöglichkeiten für Step-Audio
GitHub:https://github.com/stepfun-ai/Step-Audio
ModelScope:[Hier klicken]
Technischer Bericht:[Hier klicken]
PAI Model Gallery unterstützt One-Click-Bereitstellung [Hier klicken]














