
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
FireRedASR: Open-Source-Spracherkennungsmodell von Xiaohongshu
FireRedASR: Open-Source-Spracherkennungsmodell von XiaohongshuEinführung
FireRedASR ist ein auf einem großen Modell basierendes Spracherkennungsmodell, das vom FireRed-Team von Xiaohongshu am 9. Februar 2025 veröffentlicht und als Open Source bereitgestellt wurde. Es erzielt einen neuen SOTA-Wert im Bereich der chinesischen Mandarin-Spracherkennung (Zeichenfehlerrate CER 3,05 %) und unterstützt Dialekte, Englisch sowie Liedtexterkennung.
Die Hauptfunktionen von FireRedASR:
Spracherkennung mit hoher Genauigkeit: FireRedASR-LLM (8,3B Parameter) erreicht auf öffentlichen Testdatensätzen eine Zeichenfehlerrate (CER) von 3,05 % und setzt damit einen neuen SOTA. Im Vergleich zum vorherigen SOTA-Modell Seed-ASR (12B+ Parameter) wurde die Fehlerrate um 8,4 % reduziert.
Effiziente Inferenz: FireRedASR-AED (1,1B Parameter) steigert die Inferenzeffizienz deutlich, während die hohe Genauigkeit erhalten bleibt, mit einer CER von 3,18 %.
Anpassung an mehrere Szenarien: FireRedASR zeigt in verschiedenen Alltagsszenarien wie kurzen Videos, Live-Übertragungen, Spracheingabe und intelligenten Assistenten eine hervorragende Leistung. Im Vergleich zu führenden ASR-Dienstanbietern und Paraformer-Large wird die CER relativ um 23,7 % bis 40,0 % reduziert.
Liedtexterkennungsfähigkeit: In Szenarien, die Liedtexterkennung erfordern, erreicht FireRedASR-LLM eine relative CER-Reduktion von 50,2 % bis 66,7 %, was eine äußerst starke Anpassungsfähigkeit zeigt.
Mehrsprachige Unterstützung: FireRedASR unterstützt Mandarin und zeigt hervorragende Leistungen bei der Erkennung chinesischer Dialekte sowie englischer Sprache, wodurch der Anwendungsbereich zusätzlich erweitert wird.
Zwei Kernversionen des FireRedASR-Modells:
FireRedASR-LLM
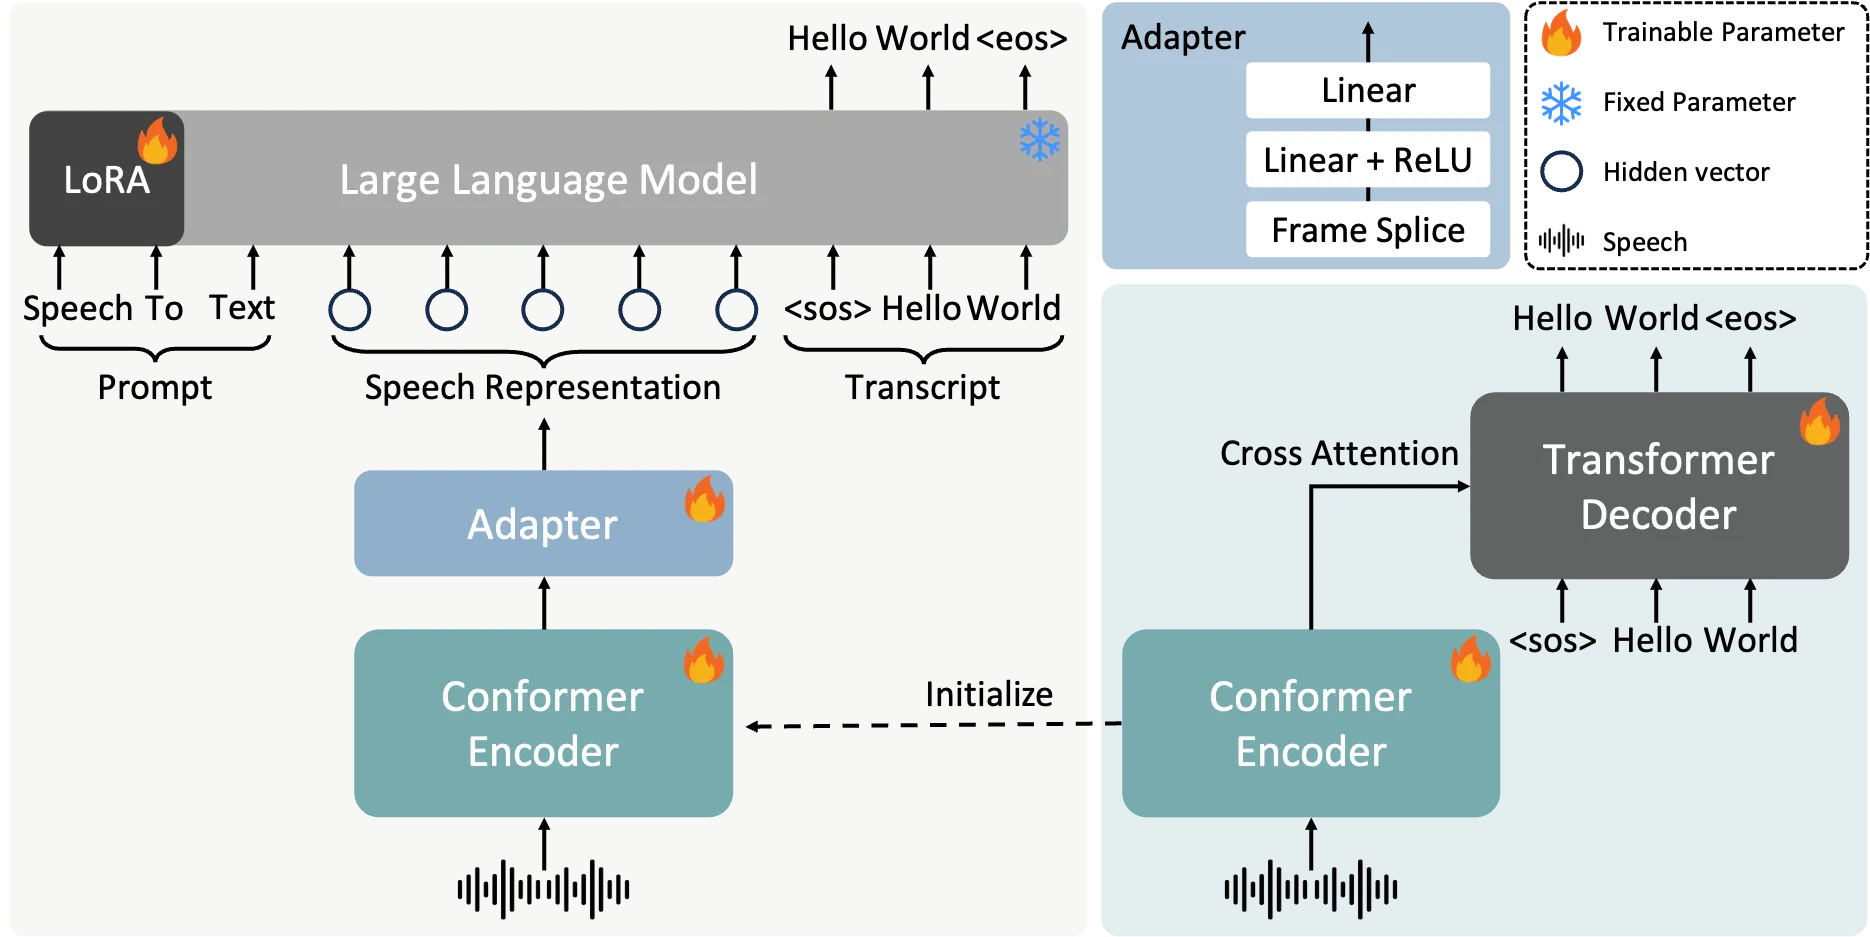
Architektur: Verwendet ein Encoder-Adapter-LLM-Framework, kombiniert mit dem großen Sprachmodell Qwen2-7B-Instruct, und ermöglicht durch LoRA-Feinabstimmung Ende-zu-Ende-Sprachinteraktion.
Leistung: Erreicht im Mandarin-Benchmark eine CER von 3,05 %, was einer Reduktion der Fehlerrate um 8,4 % gegenüber dem vorherigen SOTA-Modell entspricht; in Liedtexterkennungsszenarien wird die CER relativ um 50,2 % bis 66,7 % reduziert.
Merkmale: 8,3B Parameter, fokussiert auf höchste Präzision, geeignet für anspruchsvolle Szenarien wie professionelle Untertitelgenerierung.
FireRedASR-AED
Architektur: Basiert auf einem Aufmerksamkeits-Encoder-Decoder (Conformer-Encoder + Transformer-Decoder) mit 1,1B Parametern.
Leistung: CER von 3,18 %, übertrifft Seed-ASR mit 12B Parametern und bietet eine höhere Inferenzeffizienz.
Merkmale: Gleicht Genauigkeit und Recheneffizienz aus, geeignet für Echtzeitanwendungen wie Live-Untertitel und Sprachassistenten.
Technische Highlights von FireRedASR:
Anpassung an mehrere Szenarien: In Alltagsszenarien wie Kurzvideo und Live-Übertragung wird die CER relativ um 23,7 % bis 40,0 % reduziert; unterstützt chinesische Dialekte und Englisch.
Open-Source-Ökosystem: Modell und Code sind als Open Source verfügbar (GitHub), mit industriellem Design und Unterstützung für Weiterentwicklung durch die Community.
Trainingsstrategie: Die LLM-Version fixiert den Großteil der Parameter und trainiert nur den Encoder und Adapter, wodurch die vortrainierten Fähigkeiten erhalten bleiben.
Anwendungsszenarien von FireRedASR
Intelligente Sprachinteraktion: FireRedASR kann in intelligenten Sprachassistenten, Spracheingabemethoden und ähnlichen Szenarien eingesetzt werden und bietet hochpräzise Spracherkennungsdienste.
Multimedia-Inhaltsverständnis: FireRedASR zeigt hervorragende Leistungen bei Multimedia-Inhaltsverständnisszenarien wie Video-Untertitelgenerierung und Liedtexterkennung.
Anwendungen im Alltag: FireRedASR zeigt in verschiedenen Alltagsszenarien wie Kurzvideo, Live-Übertragung, Spracheingabe und intelligenten Assistenten eine hervorragende Leistung. Im Vergleich zu führenden ASR-Dienstanbietern und Paraformer-Large wird die CER relativ um 23,7 % bis 40,0 % reduziert.
Zugehörige Links zu FireRedASR:
Projektadresse: https://github.com/FireRedTeam/FireRedASR
Paper-Adresse: https://arxiv.org/abs/2501.14350














