
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Tarsier: großes Vision-Sprach-Modell von ByteDance
Tarsier: großes Vision-Sprach-Modell von ByteDanceEinführung
Tarsier ist eine Reihe von Large Vision Language Models (LVLM), die von ByteDance veröffentlicht wurden und sich auf Aufgaben des Video-Verstehens konzentrieren, einschließlich Videobeschreibung, Frage-Antwort-Systemen, Lokalisierung und Halluzinationstests.
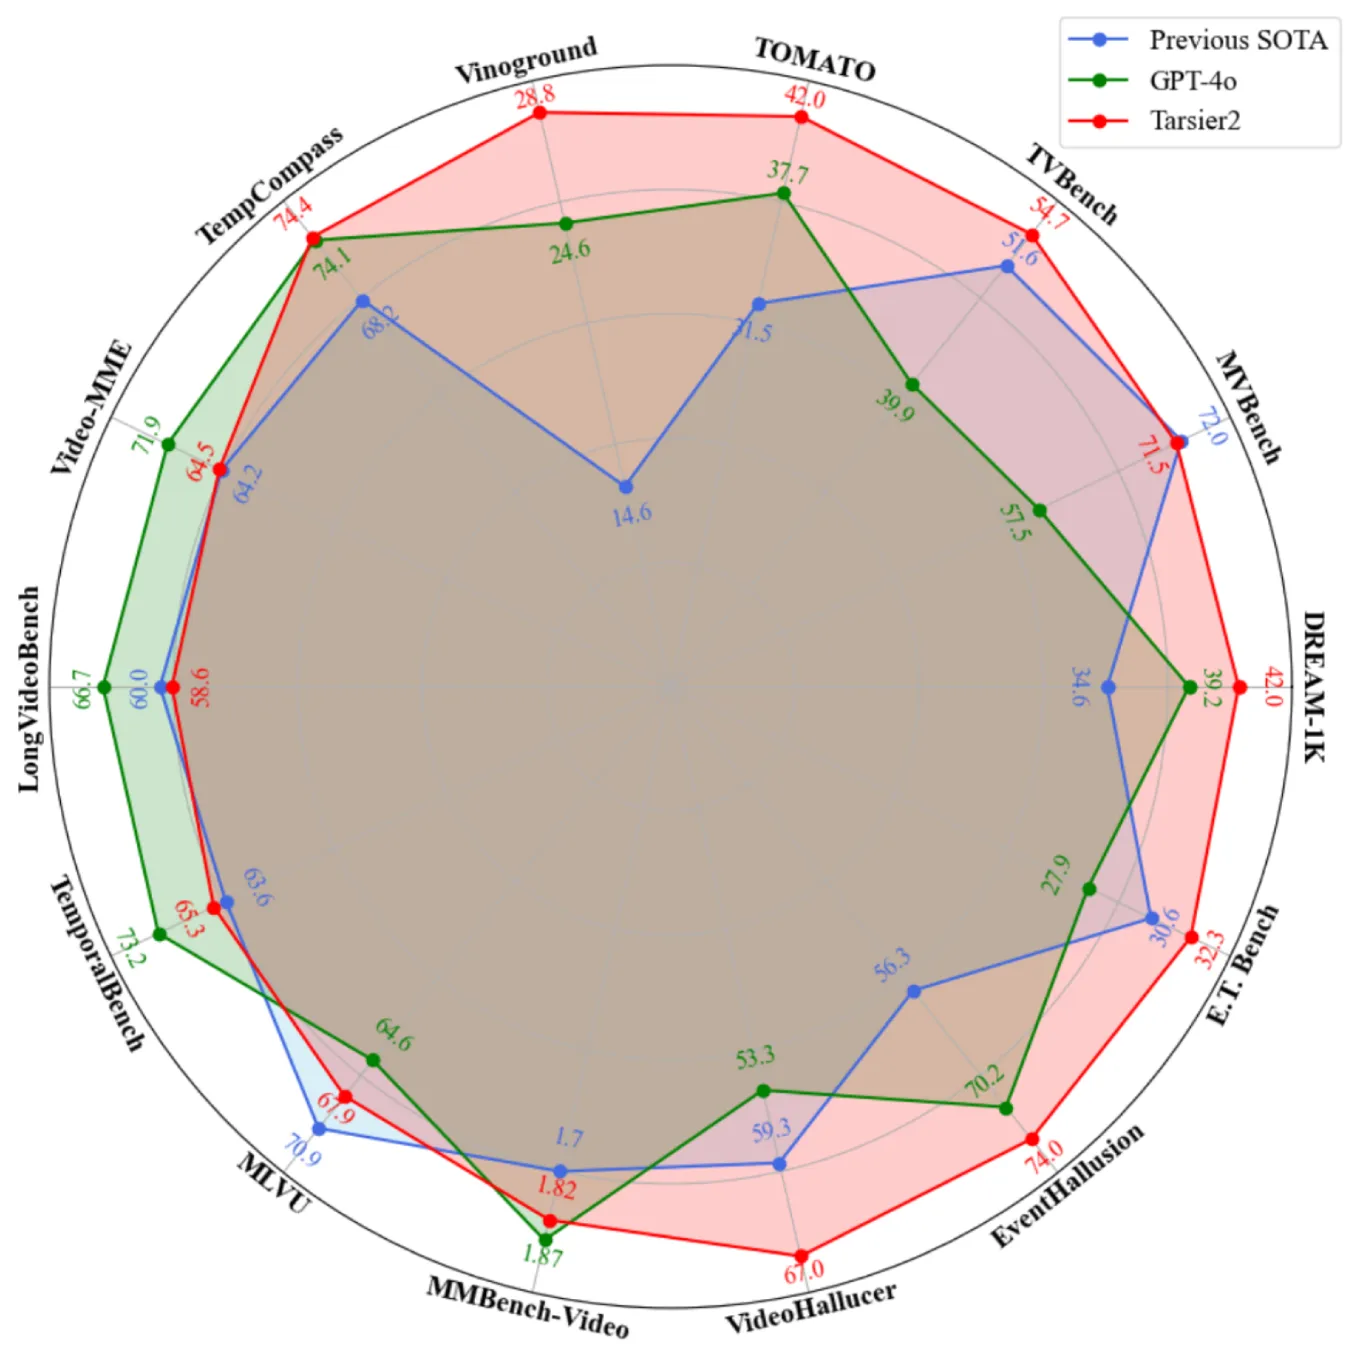
Hauptfunktionen von Tarsier
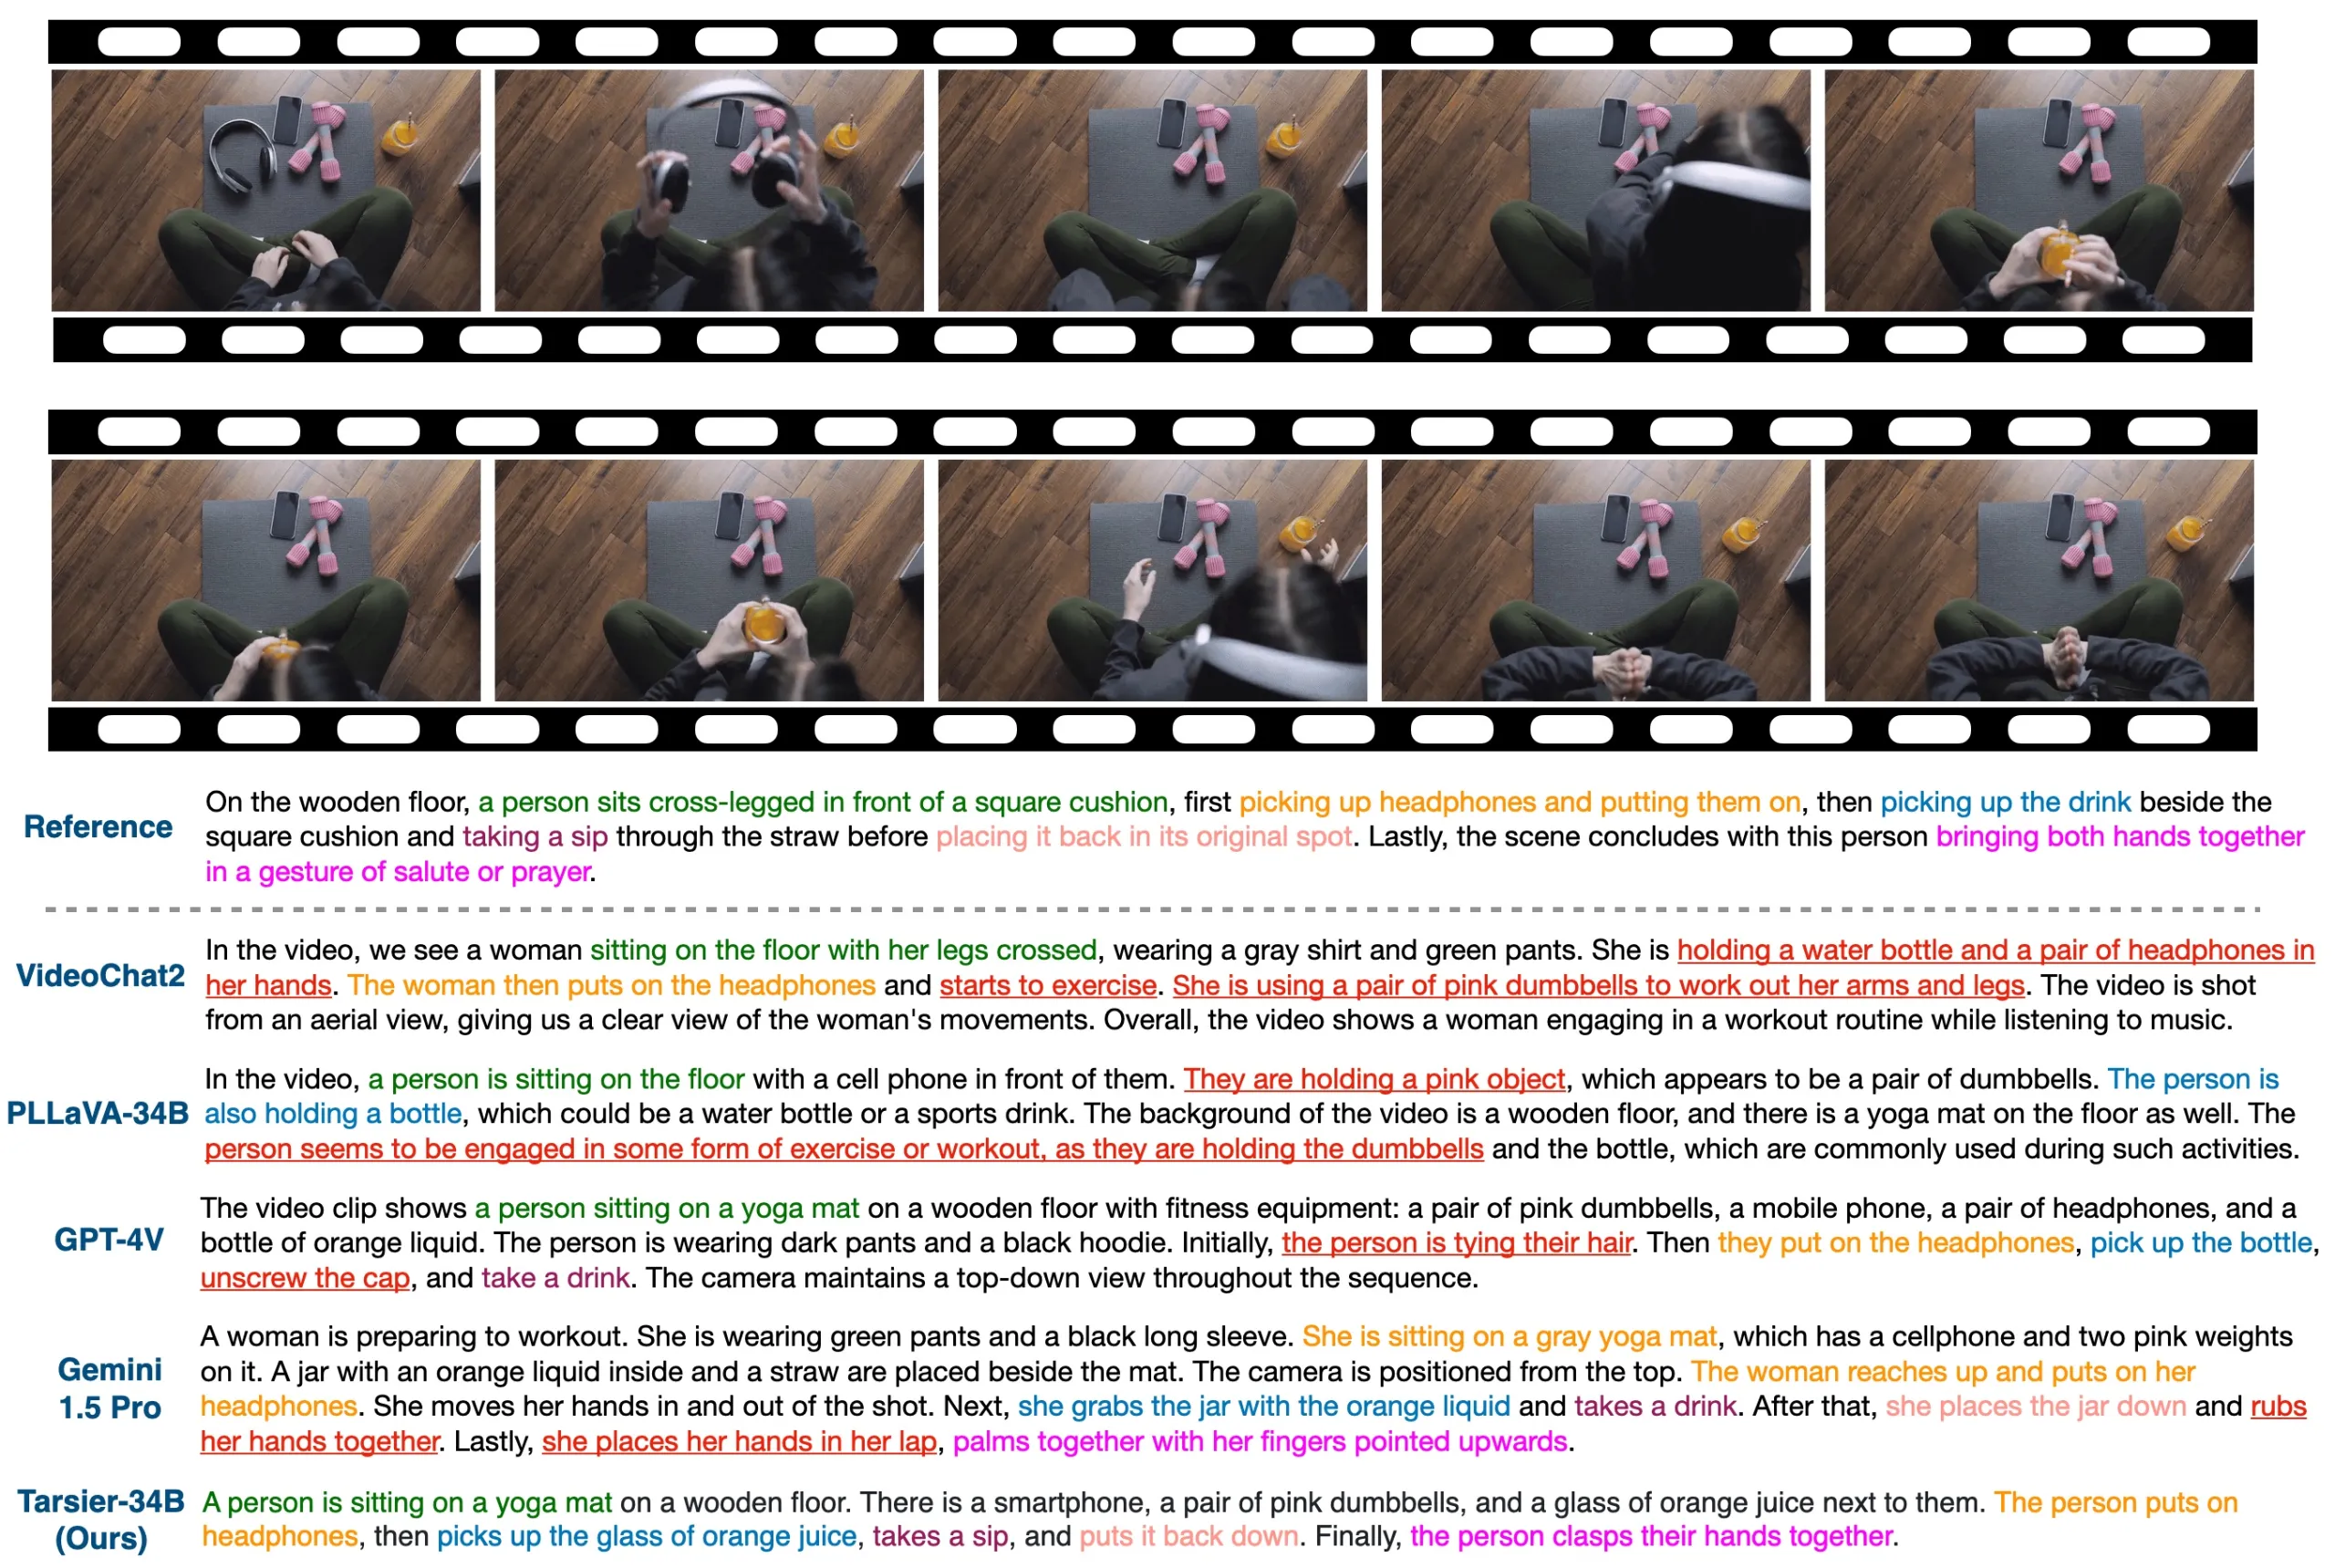
Videobeschreibung-Generierung: Tarsier kann hochwertige Videobeschreibungen erzeugen, die verschiedene Details in Videos abdecken, einschließlich Aktionen, Szenen und Handlungen, um den Benutzern ein besseres Verständnis des Videoinhalts zu ermöglichen.
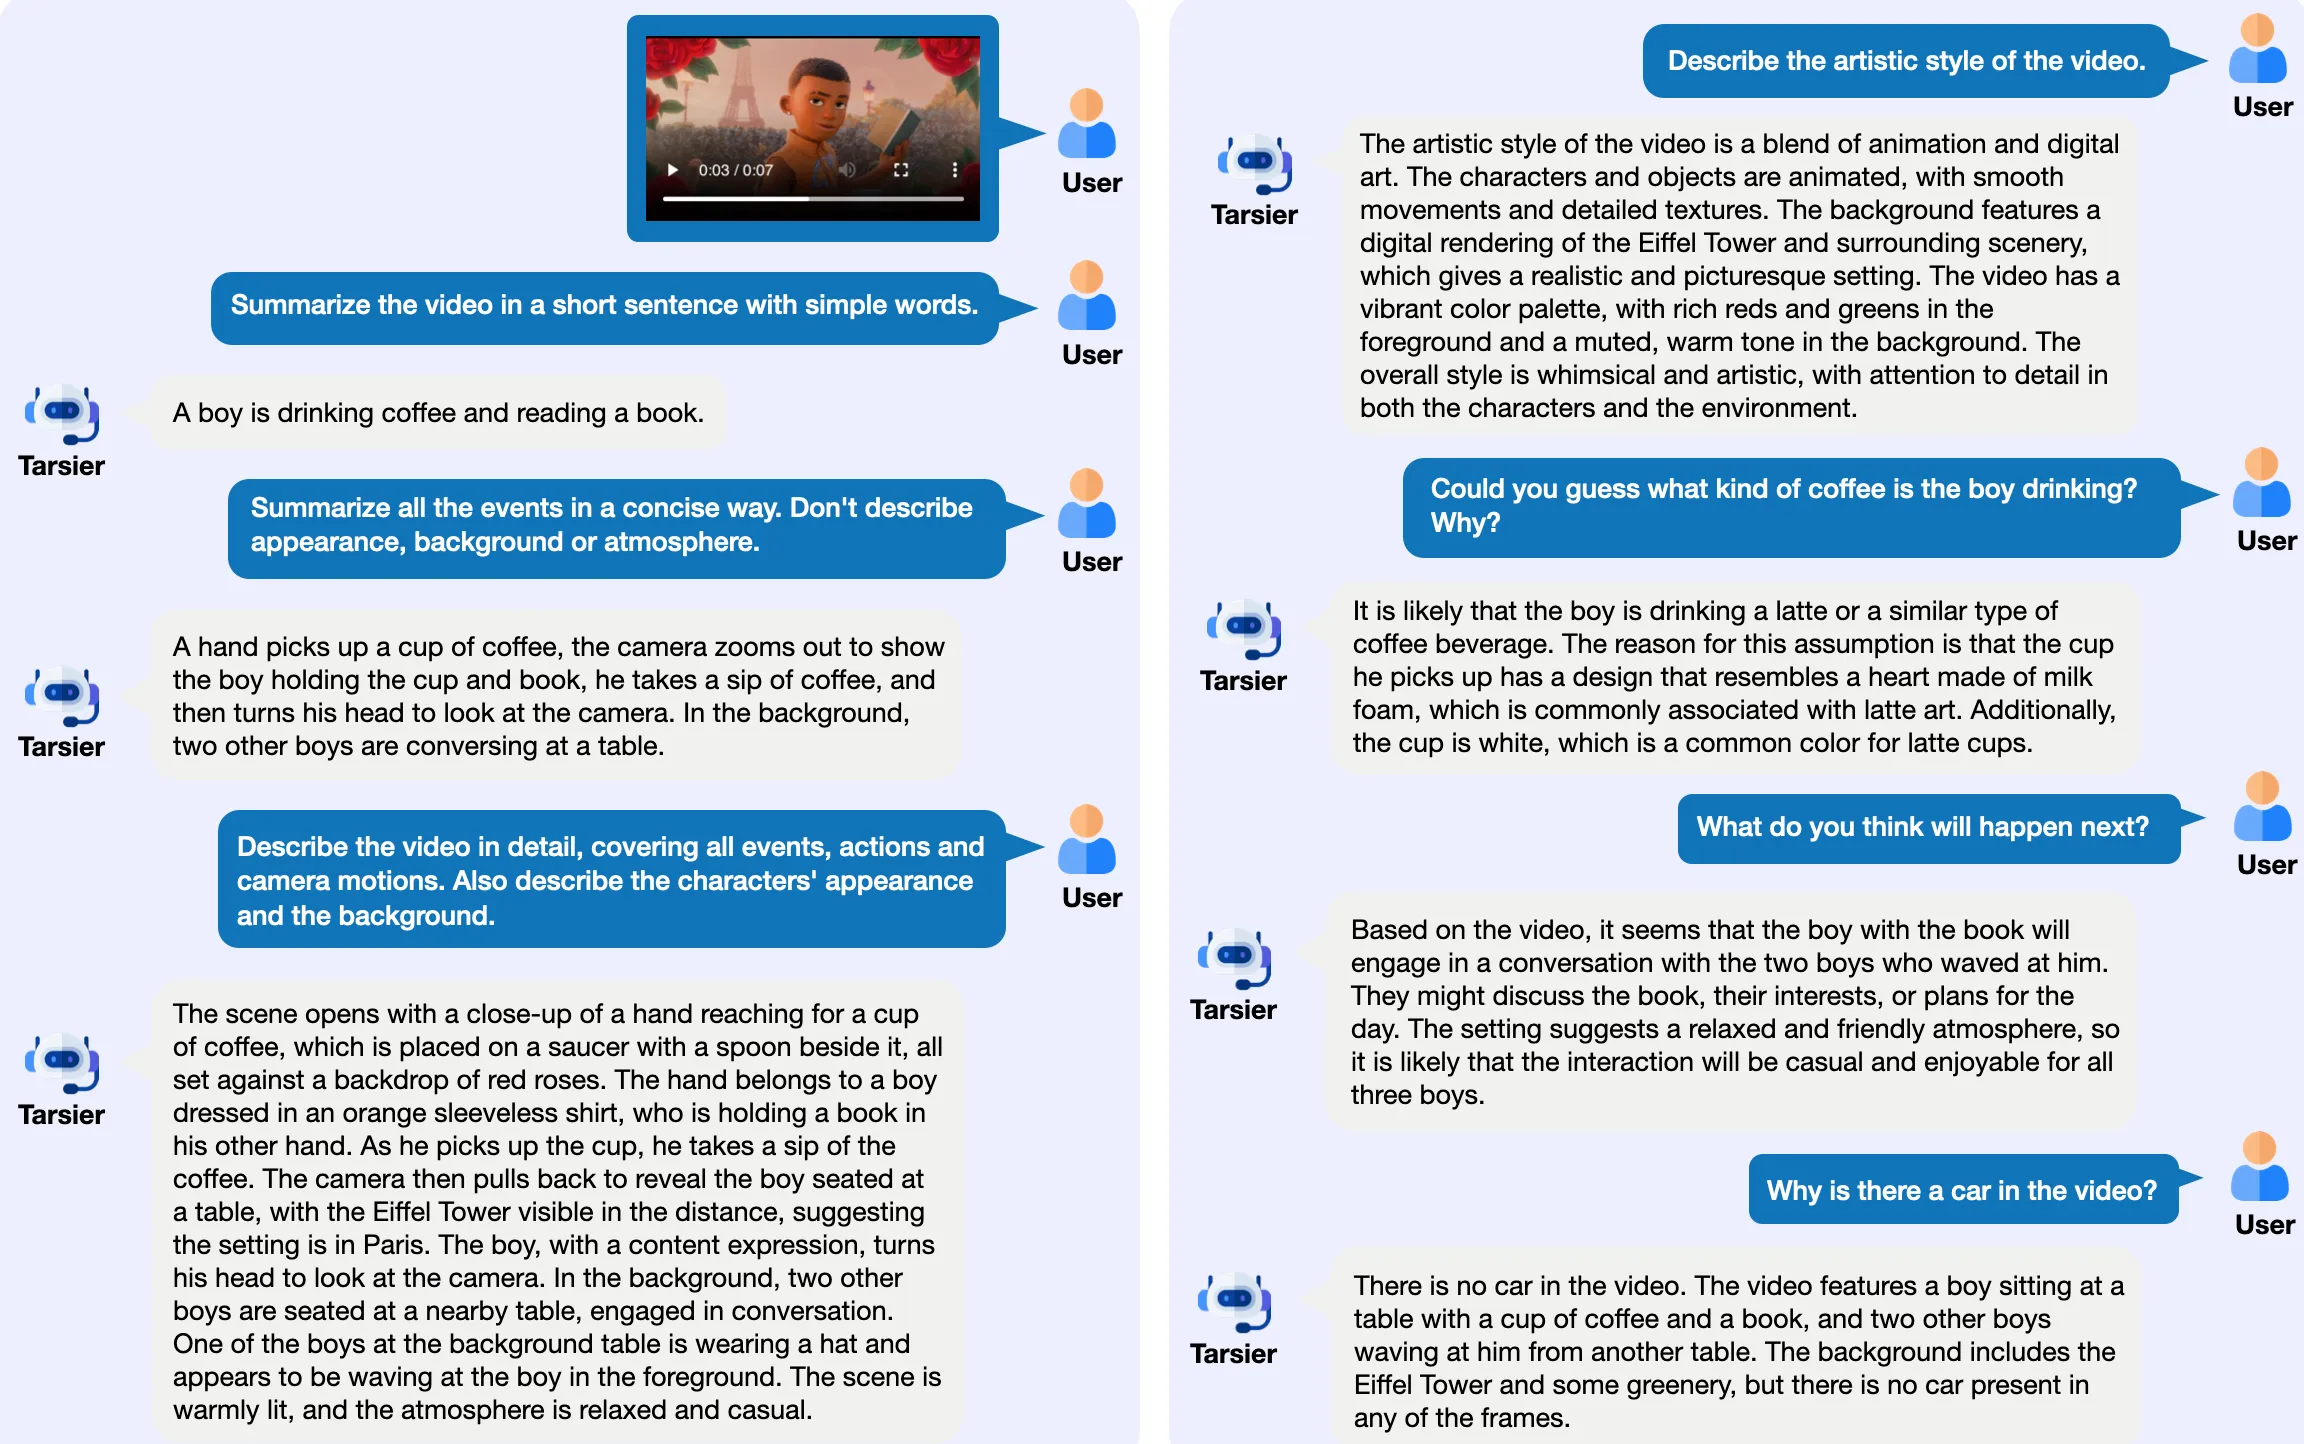
Frage-Antwort-Fähigkeit: Das Tarsier-Modell unterstützt eine Video-Frage-Antwort-Funktion. Benutzer können Fragen zum Videoinhalt stellen, und das Modell liefert entsprechende Antworten.
Lokalisierungsfunktion: Erkennt und lokalisiert den Zeitpunkt, an dem bestimmte Ereignisse im Video auftreten, unterstützt die Lokalisierung mehrerer Videosegmente und kann bestimmte Objekte oder Szenen im Video identifizieren und markieren.
Halluzinationstest: Durch optimierte Trainingsstrategien reduziert Tarsier2 die Wahrscheinlichkeit, dass das Modell falsche Informationen generiert, deutlich.
Mehrsprachigkeit: Unterstützt die Generierung von Videobeschreibungen in mehreren Sprachen.
Tarsier-Anwendungsszenarien:
Content-Erstellung: Tarsier kann Content-Erstellern dabei helfen, Videobeschreibungen zu generieren und so die Zugänglichkeit und Suchmaschinenoptimierung (SEO) von Videos zu verbessern.
Bildungsbereich: In Lehrvideos kann Tarsier detaillierte Inhaltsbeschreibungen liefern, die den Schülern helfen, das Lernmaterial besser zu verstehen.
Soziale Medien: Soziale Plattformen können Tarsier nutzen, um automatische Beschreibungen für Videoinhalte zu generieren und so die Benutzererfahrung zu verbessern.
Videoüberwachung: Im Bereich der Sicherheitsüberwachung kann Tarsier Videostreams analysieren und Echtzeit-Beschreibungen generieren, um Sicherheitspersonal dabei zu unterstützen, potenzielle Bedrohungen schnell zu erkennen.
Roboter: Generiert detaillierte Schritt-für-Schritt-Anweisungen für bestimmte Aufgaben.
Autonomes Fahren: Unterstützt Fahrzeuge dabei, Verkehrssituationen zu erkennen und Entscheidungen zu treffen.
Die neueste Version des Tarsier-Modells, Tarsier2, wurde in mehreren Aspekten erheblich verbessert, insbesondere hinsichtlich der Datenmenge und -vielfalt. Die Vortrainingsdaten wurden von 11 Millionen auf 40 Millionen Video-Text-Paare erweitert, was die Lernfähigkeit des Modells verbessert. Darüber hinaus führt Tarsier2 in der Phase des überwachten Feintunings eine feinkörnige zeitliche Ausrichtung ein, die die Genauigkeit der Videobeschreibung und die Detailerfassung weiter verbessert. Durch Direct Preference Optimization (DPO)-Training kann Tarsier2 Videobeschreibungen erzeugen, die besser den menschlichen Präferenzen entsprechen, und reduziert die Wahrscheinlichkeit von Halluzinationen.
Bei der Leistungsbewertung schneidet Tarsier2 im DREAM-1K-Benchmark hervorragend ab, mit einem F1-Score, der 2,8 % über dem von GPT-4o und 5,8 % über dem von Gemini-1.5-Pro liegt. In 15 öffentlichen Benchmarks erzielt Tarsier2 neue Bestwerte, die Funktionen wie Video-Frage-Antwort, Videolokalisierung, Halluzinationstests und Frage-Antwort abdecken, und demonstriert damit seine Vielseitigkeit als leistungsstarkes allgemeines Vision Language Model.
Neben der Videobeschreibung zeigt es auch starke Leistungen bei Aufgaben wie Frage-Antwort, Grounding und embodied intelligence.
Paper: https://arxiv.org/abs/2501.07888
Code: https://github.com/bytedance/tarsier
Dataset: https://huggingface.co/datasets/omni-research/DREAM-1K
Demo: https://huggingface.co/spaces/omni-research/Tarsier2-7b














