Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Firecrawl Extract: Webdaten mit einfachen Texteingaben abgreifen
Firecrawl Extract: Webdaten mit einfachen Texteingaben abgreifenEinführung
Firecrawl Extract kombiniert die Leistungsfähigkeit von Large Language Models (LLMs), um Daten intelligent aus Webseiteninhalten zu extrahieren und sie in Formate umzuwandeln, die für die Weiterverarbeitung geeignet sind, wie z. B. Markdown oder strukturierte JSON-Daten. Dies ist besonders nützlich in Szenarien, in denen große Mengen an Webseitendaten für das Training von KI-Modellen oder für Datenanalyse benötigt werden.
Hauptmerkmale von Firecrawl Extract:
Intelligente Extraktion: Durch die Definition eines Schemas für die Datenextraktion oder die Verwendung eines JSON-Schemas können Benutzer die benötigte Datenstruktur angeben, und Firecrawl Extract crawlt und analysiert die Daten automatisch gemäß diesen Anweisungen.
Keine Programmierung erforderlich: Benutzer können Datenextraktionen über einfache API-Aufrufe oder eine grafische Oberfläche konfigurieren, ohne komplexen Crawler-Code schreiben zu müssen.
Dynamische Inhaltsverarbeitung: Selbst wenn Websites JavaScript verwenden, um Inhalte dynamisch zu laden, kann Firecrawl diese Daten erfassen und so die Vollständigkeit der Daten sicherstellen.
Großvolumiges Crawlen: Unterstützt das gleichzeitige Crawlen mehrerer URLs, geeignet für Projekte, die große Datenmengen benötigen.
API- und SDK-Integration: Bietet ein Python SDK, Node SDK usw., damit Entwickler die Firecrawl Extract-Funktionalität einfach in ihre eigenen Anwendungen integrieren können.
LLM-Unterstützung: Nutzt LLMs, um den Kontext von Webseiten zu verstehen und Schlüsselinformationen aus unstrukturierten Daten genauer zu identifizieren und zu extrahieren.
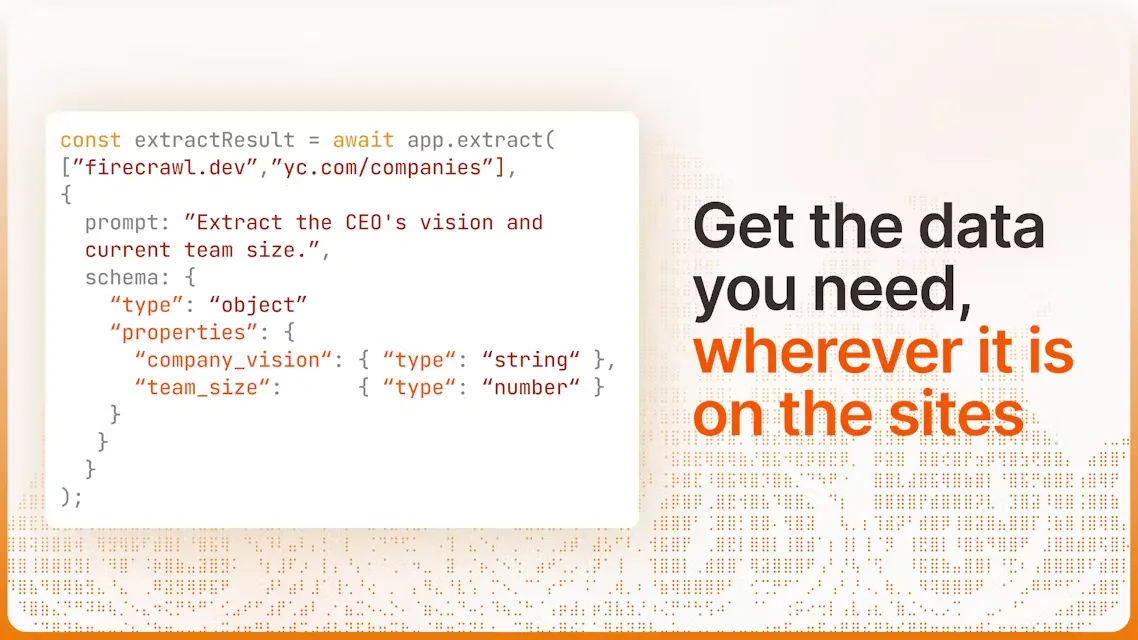
Einfache Bedienung: Der Datenextraktionsprozess kann mit einfachen Befehlen oder Aufrufen gestartet werden, wie z. B. dem API-Aufruf im Beispiel.
Schritte zur Verwendung von Firecrawl Extract:
1. Datenanforderungen definieren: Legen Sie fest, welche Daten Sie aus den Webseiten extrahieren möchten, und bereiten Sie ein entsprechendes Datenschema vor oder verwenden Sie eine vordefinierte Vorlage.
2. API-Aufruf oder SDK-Integration:
Bei Verwendung der API erstellen Sie eine Anfrage, die die Ziel-URL und das Schema für die Datenextraktion angibt.
Wenn Sie das Python SDK verwenden, initialisieren Sie das FirecrawlApp-Objekt und rufen die entsprechende Extraktionsmethode auf, wobei Sie die URL und die Extraktionsanweisungen übergeben.
Beispielcode (Python SDK):
from firecrawl.firecrawl import FirecrawlApp
app = FirecrawlApp(api_key="YOUR_API_KEY")
result = app.extract([ 'Deine Webseiten-URL'], {
prompt: "Bestimmte Daten extrahieren",
schema: { /* Definiere deine Datenstruktur */ }
})
3. Ergebnisse abrufen: Nach Abschluss der Extraktion gibt Firecrawl die verarbeiteten Daten zurück, die direkt für die nachfolgende Datenanalyse oder das Modelltraining verwendet werden können.
Anwendungsfälle von Firecrawl Extract:
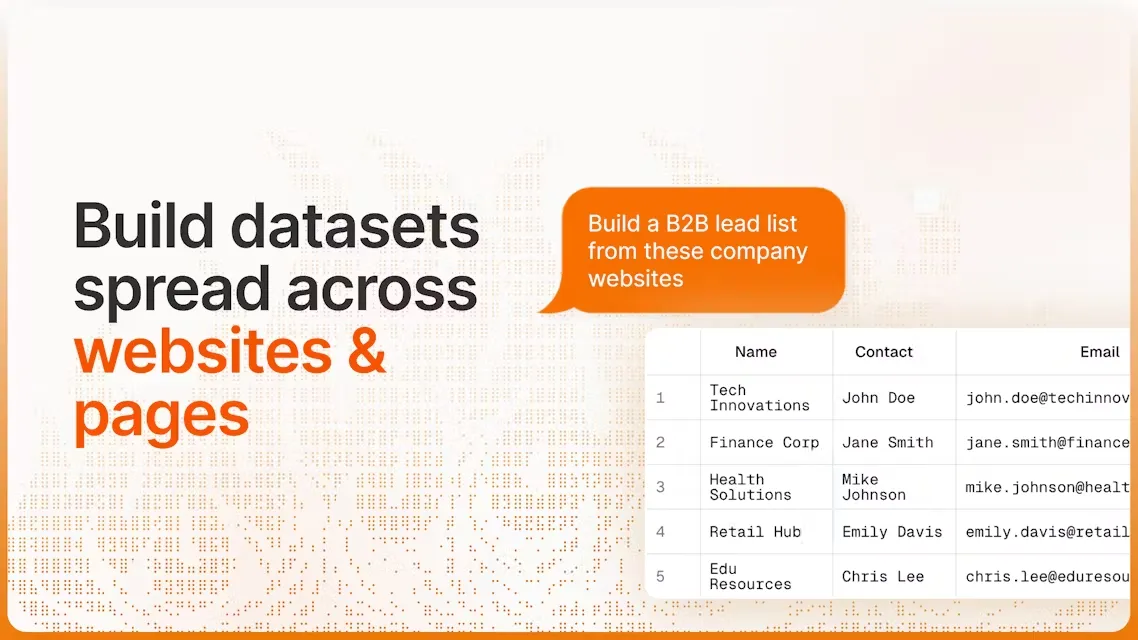
Firecrawl eignet sich für verschiedene Anwendungsfälle, wie z. B. die Anreicherung von Interessentendaten, KYB-Automatisierung und No-Code-Workflows. Die Dienste von Firecrawl machen es einfach und effizient, Webseitendaten in Formate umzuwandeln, die für die Verwendung mit Large Language Models (LLMs) geeignet sind:
KI-Modelltraining: Bietet umfangreiche Trainingsdaten für Large Language Models.
Inhaltsaggregation: Schnelle Erstellung von Inhaltszusammenfassungen oder Nachrichtenaggregationsdiensten.
Marktanalyse: Extraktion von Preis- oder Produktinformationen von Wettbewerber-Websites.
Datenrecherche: Sammlung öffentlich verfügbarer Daten aus dem Internet für akademische oder kommerzielle Forschung.
Der /extract-Endpunkt von Firecrawl ist ein leistungsstarkes Werkzeug, mit dem strukturierte Daten von jeder Website extrahiert werden können. Benutzer können die benötigten Daten über einfache API-Aufrufe abrufen, ohne manuell crawlen zu müssen. Mit der Extract-Funktion von Firecrawl können Benutzer gängige Herausforderungen beim Web-Crawling, wie Stealth-Proxys und Ratenbegrenzungen, problemlos bewältigen und einen reibungslosen Datenextraktionsprozess sicherstellen.