
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
TangoFlux: Text-zu-Audio (TTA) Soundeffekt-Generierungsmodell
TangoFlux: Text-zu-Audio (TTA) Soundeffekt-GenerierungsmodellEinführung
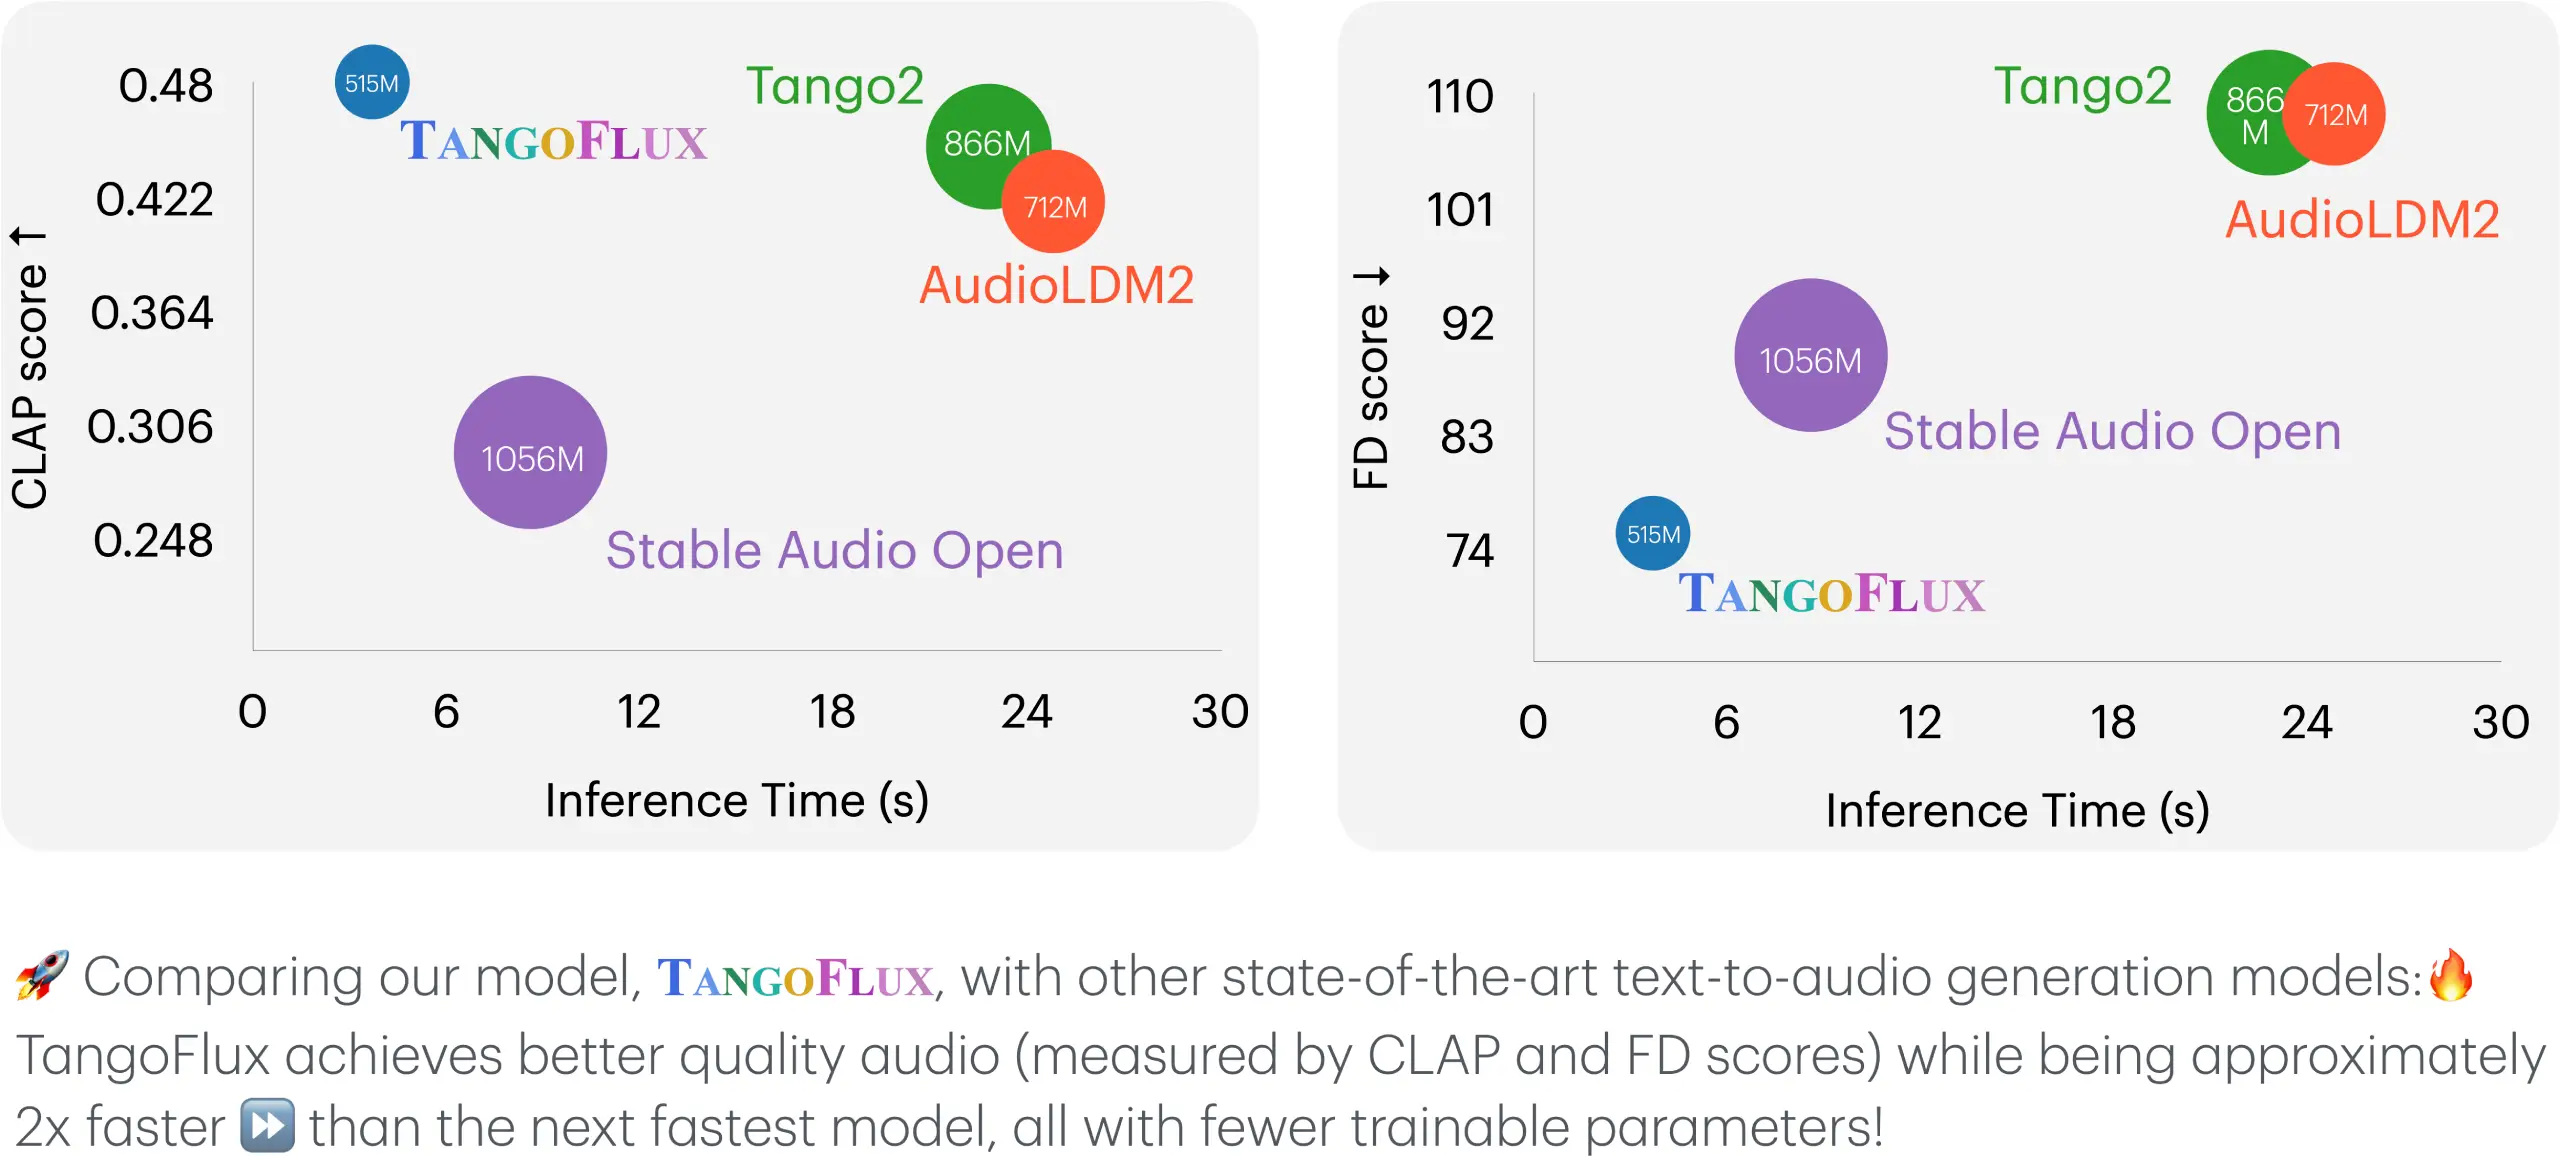
TangoFlux ist ein fortschrittliches Text-zu-Audio-Generierungsmodell (TTA), das vom Singapore University of Technology and Design (SUTD) in Zusammenarbeit mit NVIDIA entwickelt wurde. Es verfügt über ca. 515 Millionen Parameter und kann auf einer einzelnen A40-GPU in nur 3,7 Sekunden bis zu 30 Sekunden Stereo-Audio mit 44,1 kHz erzeugen. TangoFlux kann nicht nur Soundeffekte wie Vogelzwitschern, Pfeifen oder Explosionen erzeugen, sondern auch Musik generieren.
Technische Prinzipien von TangoFlux
Variational Autoencoder: Verwendet einen VAE, um Audio-Wellenformen in eine latente Repräsentation zu kodieren und aus dieser das ursprüngliche Audio zu rekonstruieren.
Text- und Dauer-Embeddings: Basierend auf Text- und Dauer-Encoder wird der Inhalt und die Dauer des generierten Audios gesteuert.
FluxTransformer-Architektur: Kombiniert Diffusion Transformer (DiT) und Multimodal Diffusion Transformer (MMDiT), um Text-Prompts zu verarbeiten und Audio zu generieren.
Flow Matching: Lernt eine Abbildung von einer einfachen Prior-Verteilung auf eine komplexe Zielverteilung, um Samples zu erzeugen.
CLAP-Ranked Preference Optimization: Optimiert die Audio-Abgleichung auf Basis iterativ erzeugter Präferenzdaten.
Hauptfunktionen von TangoFlux
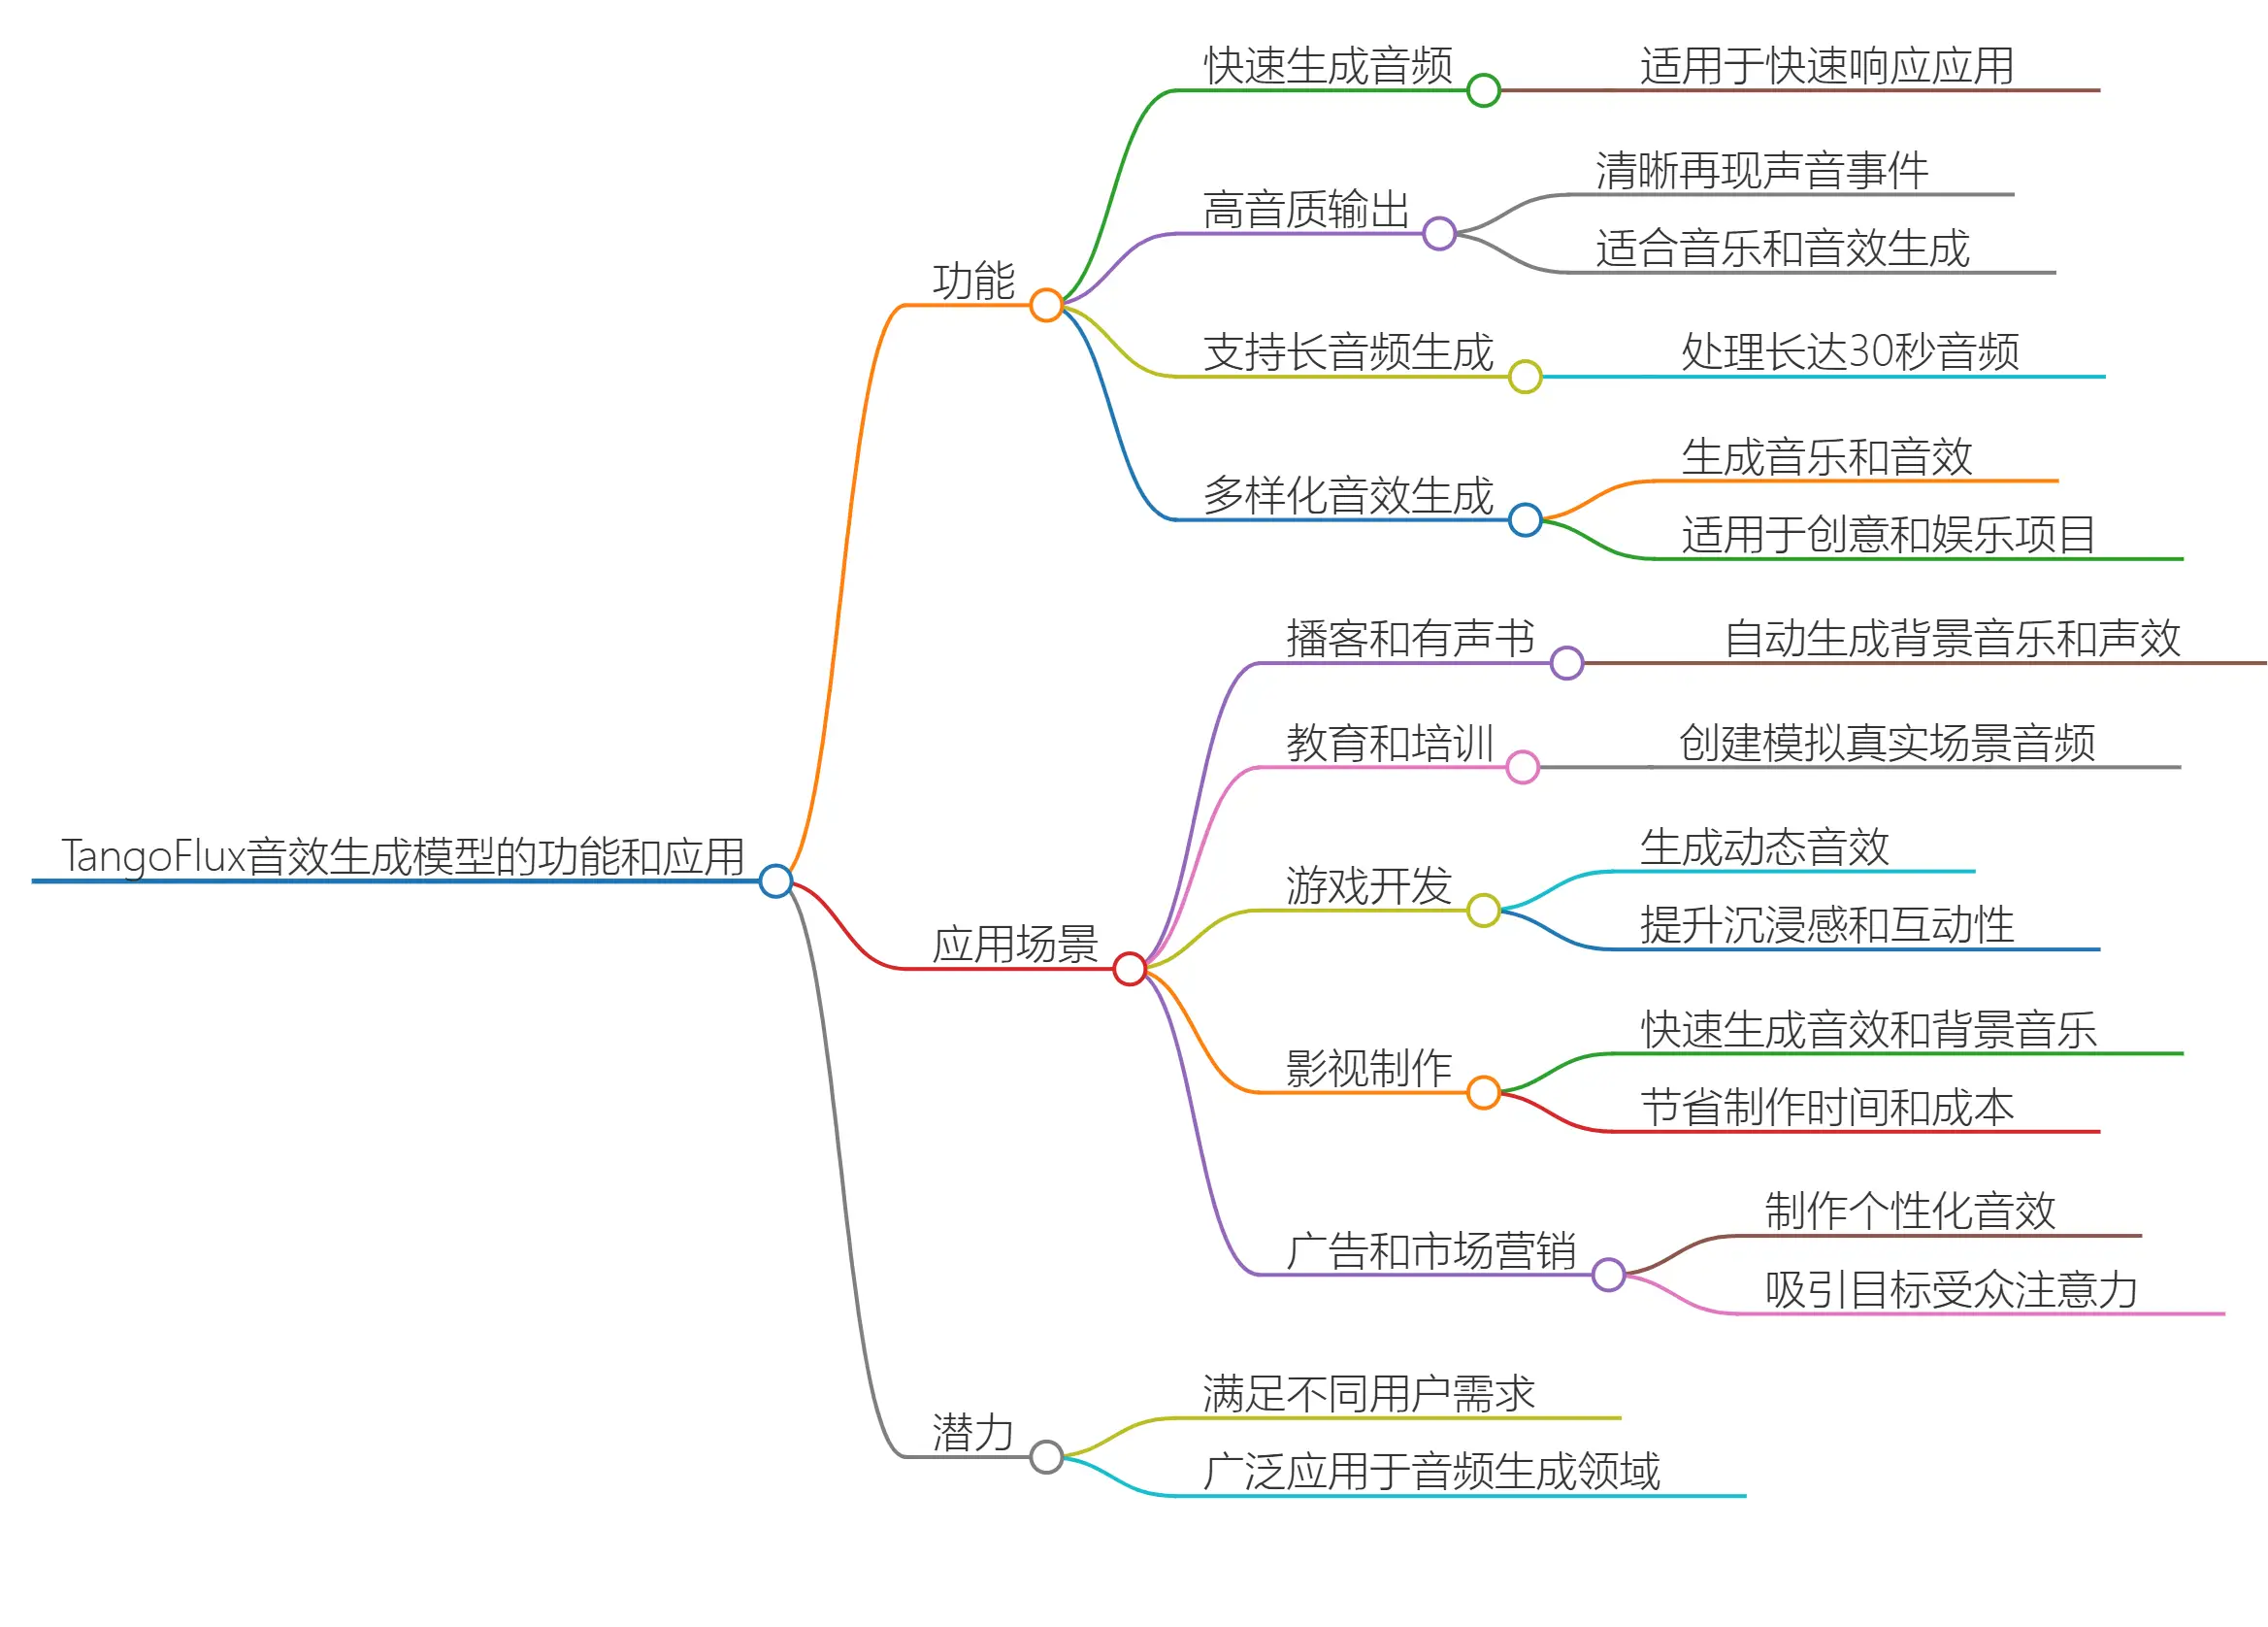
Schnelle Audio-Generierung: TangoFlux kann in extrem kurzer Zeit hochwertige Audioinhalte erzeugen und eignet sich für Anwendungen, die schnelle Reaktionen erfordern.
Hohe Audioqualität: Die erzeugten Audios sind von hoher Qualität und können verschiedene Klangereignisse klar wiedergeben, geeignet für die Generierung unterschiedlichster Audioarten wie Musik und Soundeffekte.
Unterstützung langer Audio-Generierung: Das Modell kann Audio-Generierungsaufgaben von bis zu 30 Sekunden Länge bewältigen und eignet sich somit für die Erstellung längerer Audioinhalte.
Vielfältige Soundeffekt-Generierung: TangoFlux kann nicht nur Musik, sondern auch verschiedene Soundeffekte wie Vogelzwitschern, Pfeifen oder Explosionen erzeugen und ist somit für zahlreiche kreative und Unterhaltungsprojekte geeignet.
Anwendungsszenarien von TangoFlux
Audio-Produktion für Film und Spiele: TangoFlux kann anhand von Drehbüchern oder Szenenbeschreibungen realistische Soundeffekte, Musikbegleitung und Voiceover schnell erzeugen, verkürzt die Produktionszeit, senkt die Kosten, verbessert die Audioqualität des Werks und steigert die Interaktivität sowie Immersion des Spiels.
Inspirationsquelle für die Musikproduktion: Kann nach Vorgaben der Kreativen vielfältige Musikfragmente erzeugen, hilft, kreative Blockaden zu überwinden, fördert musikalische Innovationen und führt zu neuartigen Werken.
Verbesserung von VR- und AR-Erlebnissen: Erzeugt in Echtzeit realistische Audios auf Basis virtueller Umgebungen und Nutzerinteraktionen, steigert die Immersion in VR-Spielen und verstärkt in AR-Anwendungen die Wahrnehmung der Verschmelzung von virtueller und realer Welt.
Audio-Innovationen in Werbung und Marketing: Erzeugt auf Basis von Werbekonzepten und Markenimage einzigartige Audios, die Verbraucher ansprechen, Resonanz wecken und den Bekanntheitsgrad sowie das Ansehen der Marke steigern.
Projektressourcen von TangoFlux
Offizielle Projektwebsite: tangoflux.github.io
arXiv Technisches Paper: https://export.arxiv.org/pdf/2412.21037
TangoFlux verwendet außerdem das Framework CLAP-Ranked Preference Optimization (CRPO), das durch iterative Erzeugung und Optimierung von Präferenzdaten die Audio-Abgleichungsfähigkeit des Modells verbessert. Dieser Ansatz stellt sicher, dass die erzeugten Audios nicht nur qualitativ hochwertig sind, sondern auch besser mit den Präferenzen der Nutzer und der Absicht des Eingabetextes übereinstimmen. Darüber hinaus basiert das Training von TangoFlux auf nicht-proprietären Datensätzen, was das Modell offener und zugänglicher macht und weitere Forschung sowie Anwendungen fördert.
TangoFlux wird hauptsächlich in der Erstellung multimedialer Inhalte eingesetzt, beispielsweise zur Erzeugung von Hintergrundmusik, Soundeffekten und Voiceovers in Film-, Spiel-, Werbe- und Video-Produktionen, wodurch die Produktionseffizienz gesteigert und die Kosten gesenkt werden. Zu den technischen Prinzipien gehören der Variational Autoencoder (VAE), Text- und Dauer-Embeddings sowie die FluxTransformer-Architektur – Technologien, die gemeinsam die effiziente Audio-Generierung ermöglichen.
Verwandte Nachrichten:















