
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

ExtractPDF: Bilder, Text und Schriftarten aus PDF-Dateien extrahieren
ExtractPDF: Bilder, Text und Schriftarten aus PDF-Dateien extrahierenEinführung
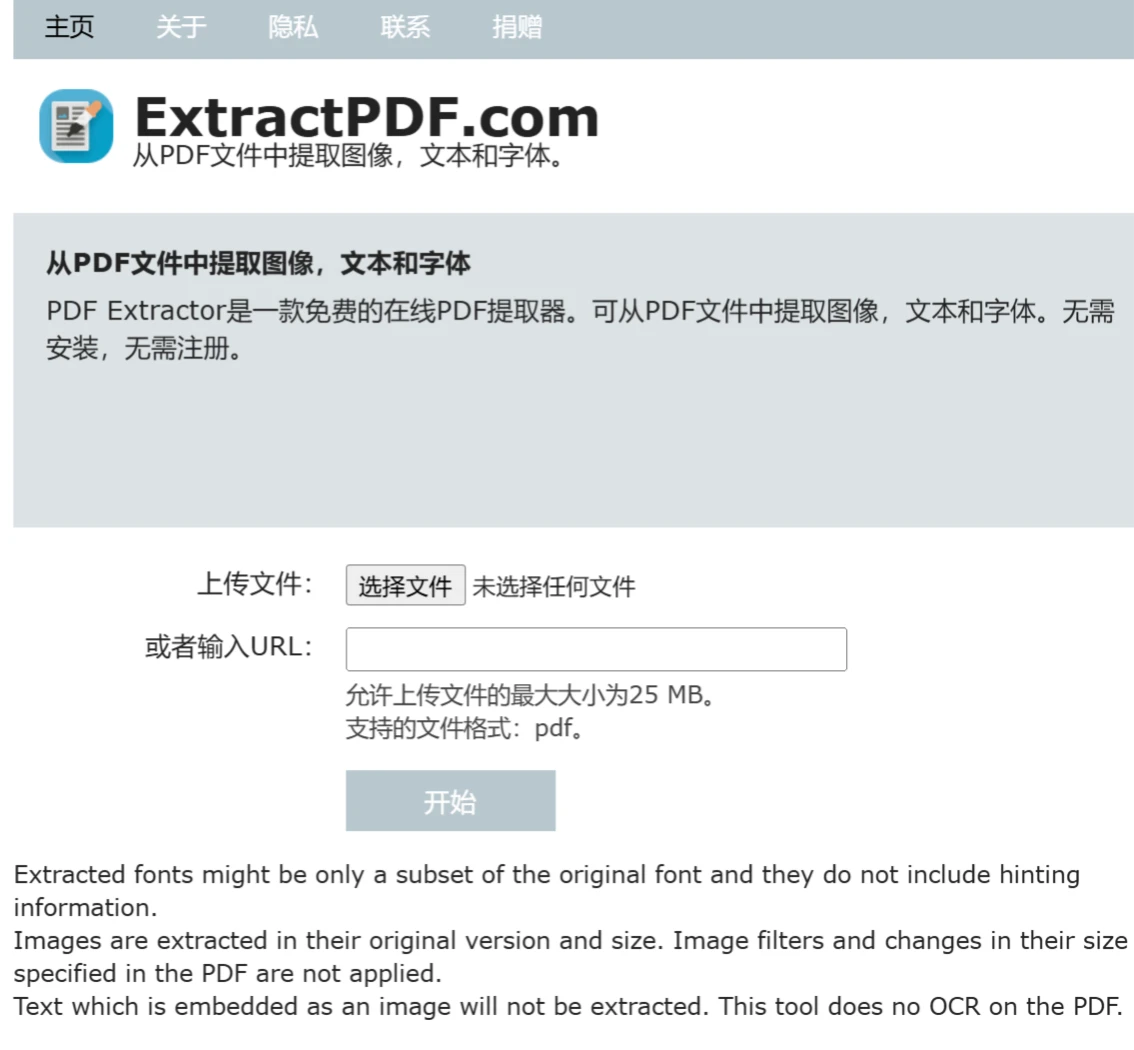
ExtractPDF ist ein Online-Tool, das speziell zum Extrahieren von Text und Bildern aus PDF-Dateien entwickelt wurde. Es ist kein Download von Software oder Plugins erforderlich – die Nutzer können die bereitgestellten Funktionen direkt im Browser verwenden. Die Website bietet eine einfache und benutzerfreundliche Oberfläche, mit der die gewünschten Informationen schnell und effizient extrahiert werden können.
ExtractPDF-Funktionen:
Text extrahieren: Extrahiert reinen Textinhalt aus PDF-Dateien.
Bilder extrahieren: Extrahiert Bilder aus PDF-Dateien. Die Nutzer können einzelne oder mehrere Bilder speichern.
Sprachunterstützung: ExtractPDF unterstützt die Texterkennung in mehreren Sprachen, darunter Englisch, Chinesisch, Japanisch und weitere.
Verwendung von ExtractPDF:
Die Nutzung ist sehr einfach: Laden Sie einfach eine PDF-Datei hoch oder geben Sie die URL einer PDF-Datei ein und senden Sie das Formular ab,
Website aufrufen: Öffnen Sie den Browser und rufen Sie die offizielle Website von ExtractPDF auf.
PDF-Datei hochladen: Laden Sie eine PDF-Datei hoch oder geben Sie die URL einer PDF-Datei ein (ExtractPDF erlaubt das Hochladen von Dateien mit einer maximalen Größe von 25 MB; das unterstützte Dateiformat ist pdf.).
Extraktion starten: Klicken Sie auf die Schaltfläche „Starten", und ExtractPDF beginnt mit der Verarbeitung der Datei und der Extraktion der gewünschten Inhalte.
Ergebnisse herunterladen: Nach Abschluss der Extraktion können die Nutzer den extrahierten Text und die Bilder direkt herunterladen.
Vorteile von ExtractPDF:
Keine Installation erforderlich: Die Nutzer müssen keine Software herunterladen, sondern benötigen lediglich einen Browser.
Mehrsprachige Unterstützung: ExtractPDF unterstützt zahlreiche Sprachen, einschließlich Chinesisch.
Hinweise:
Die extrahierte Schriftart ist möglicherweise nur eine Teilmenge der Originalschriftart und enthält keine Hint-Informationen.
Bilder werden in ihrer Originalversion und -größe extrahiert. In der PDF-Datei angegebene Bildfilter und Größenänderungen werden nicht angewendet.
Als Bilder eingebetteter Text wird nicht extrahiert. Dieses Tool führt keine OCR auf PDFs durch.
Häufig gestellte Fragen zu ExtractPDF:
1. Warum sehen die extrahierten Bilder anders aus als in der PDF-Datei?
Dieses Tool extrahiert die Originalbilder aus der PDF-Datei. In der PDF durchgeführte Bildbearbeitungen wie Zuschneiden, Drehen oder Farbumkehr werden ignoriert.
2. Warum fehlen bei der aus der PDF-Datei extrahierten Schriftart einige Glyphen?
Wenn eine Schriftart in eine PDF-Datei eingebettet ist, enthält die PDF-Datei nur die Glyphen der vorkommenden Zeichen. Wenn Ihre PDF-Datei beispielsweise keinen Buchstaben „P" enthält, enthält die extrahierte Schriftartendatei ebenfalls keinen Buchstaben „P".
3. Warum führt die Verwendung der aus der PDF extrahierten Schriftartendatei zu seltsam aussehendem Textsatz?
PDF-Dateien enthalten in der Regel keine Schriftmaße-Dateien (.pfm- oder .afm-Dateien), da PDF-Reader diese Informationen nicht benötigen. Das Fehlen der Schriftmaße-Dateien führt dazu, dass die extrahierte Schriftartendatei nicht normal verwendet werden kann.
2. Ist das Extrahieren von Schriftartendateien aus einer PDF legal?
Das Extrahieren von Schriftartendateien aus einer PDF ist legal. Wenn Sie die extrahierten Schriftartendateien jedoch verwenden möchten, benötigen Sie die Genehmigung des Schriftartersellers.
Aufgrund der fehlenden Schriftmaße-Daten können die extrahierten Schriftartendateien jedoch in der Regel nicht direkt verwendet werden. Sie dienen hauptsächlich dazu, die in der PDF-Datei verwendeten Schriftarten zu identifizieren.
Wenn Sie dennoch die aus einer PDF-Datei extrahierten Schriftarten verwenden möchten, sollten Sie sich der damit verbundenen rechtlichen Risiken bewusst sein.













