
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ChatTTS-Forge: All-in-One-TTS-Tool
ChatTTS-Forge: All-in-One-TTS-ToolEinführung
ChatTTS-Forge ist ein Projekt, das um TTS-Generierungsmodelle herum entwickelt wurde und den Benutzern flexible TTS-Generierungsfähigkeiten bietet. Es unterstützt mehrere Stimmen, Stilsteuerung, Inferenz für lange Texte und weitere Funktionen. ChatTTS-Forge stellt verschiedene APIs (Anwendungs-Programmierschnittstellen) bereit, mit denen Entwickler Text direkt und einfach in Sprache umwandeln können.
ChatTTS-Forge ist ein Projekt, das um TTS- (Text-zu-Sprache) Generierungsmodelle herum entwickelt wurde. Es bietet den Benutzern flexible TTS-Generierungsfähigkeiten und unterstützt mehrere Stimmen, Stilsteuerung, Inferenz für lange Texte und weitere Funktionen.
ChatTTS-Forge stellt verschiedene APIs (Anwendungsprogrammierschnittstellen) bereit, mit denen Entwickler Text direkt und einfach in Sprache umwandeln können. Darüber hinaus bietet es eine benutzerfreundliche Web-Oberfläche (WebUI), die es Benutzern ermöglicht, Text direkt in Text einzugeben und Sprache zu generieren, ohne programmieren zu müssen.
Die Hauptmerkmale von ChatTTS-Forge:
TTS-Generierung: Unterstützt Inferenz für mehrere TTS-Modelle, einschließlich ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS usw. Benutzer können die Stimmen frei auswählen und wechseln.
Stimmverwaltung: Integrierte mehrere Stimmen mit der Möglichkeit, benutzerdefinierte Stimmen hochzuladen. Benutzer können benutzerdefinierte Klingeltöne durch Hochladen von Audio oder Text erstellen und verwenden.
Stilsteuerung: Bietet mehrere Optionen zur Stilsteuerung, einschließlich der Anpassung von Sprechgeschwindigkeit, Tonhöhe und Lautstärke sowie der Hinzufügung von Sprachverbesserung (Enhancer), um die Ausgabequalität zu verbessern.
Verarbeitung langer Texte: Unterstützt die automatische Segmentierung und Inferenz von sehr langen Texten und kann lange Audioinhalte erzeugen.
SSML-Unterstützung: Verwendet eine XML-ähnliche SSML-Syntax für die erweiterte Steuerung der TTS-Synthese, geeignet für detailliertere Sprachgenerierungsszenarien.
ASR (Automatische Spracherkennung): Integriert das Whisper-Modell und unterstützt die Umwandlung von Sprache in Text.
Die Technologie und Methoden von ChatTTS-Forge:
API-Server: Ein in Python geschriebener API-Server bietet effiziente TTS-Dienste mit Unterstützung für mehrere gleichzeitige Anfragen und benutzerdefinierte Konfigurationen.
WebUI: Eine auf Gradio basierende Benutzeroberfläche, mit der Benutzer TTS-Funktionen über eine einfache Bedienoberfläche erleben können.
Docker-Unterstützung: Bietet Containerisierungs-Bereitstellungsoptionen mit Docker, um den Bereitstellungsprozess lokal und auf Servern zu vereinfachen.
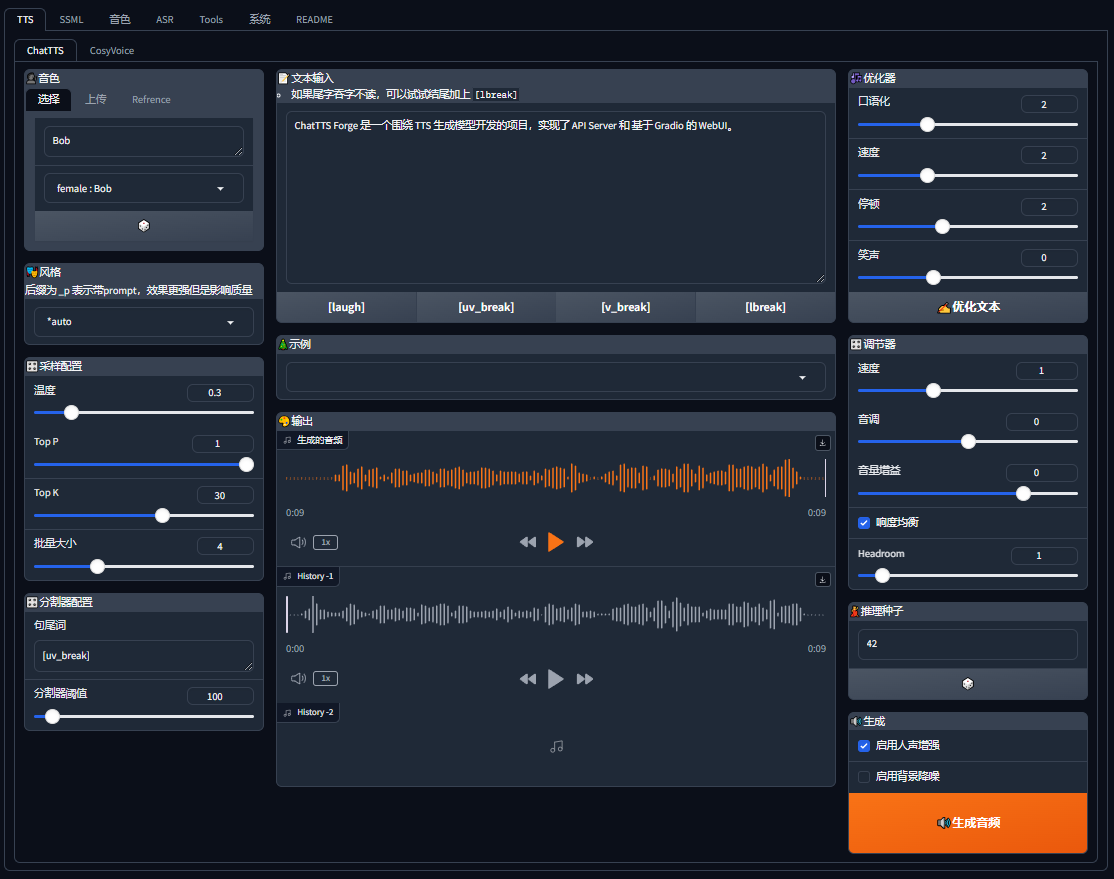
Merkmale der ChatTTS-Forge WebUI:
TTS (Text zu Sprache): Über die WebUI können Benutzer mit verschiedenen TTS-Modellen Text eingeben und Sprache erzeugen.
Stimmwechsel: Unterstützt den Wechsel zwischen mehreren voreingestellten Stimmen. Benutzer können verschiedene Stimmen zur Spracherzeugung auswählen.
Hochladen benutzerdefinierter Stimmen: Benutzer können ihre eigenen Sprachdateien hochladen, um in Echtzeit personalisierte Sprache zu erzeugen.
Stilsteuerung: Sie können den Stil der Sprache anpassen, einschließlich Parametern wie Sprechgeschwindigkeit, Tonhöhe und Lautstärke, um Sprache zu erzeugen, die bestimmte Anforderungen erfüllt.
Verarbeitung langer Texte: Unterstützt die Verarbeitung sehr langer Texte, indem lange Texte automatisch in kleine Abschnitte aufgeteilt und der Reihe nach Sprache erzeugt wird, geeignet zur Erzeugung langer Audioinhalte.
Stapelverarbeitung: Benutzer können die Stapelgröße einstellen, um die Inferenzgeschwindigkeit für lange Texte zu erhöhen.
Refiner: Dieses Werkzeug ermöglicht es Ihnen, Text feinabzustimmen, um die erzeugte Sprache zu optimieren, und ist besonders nützlich für die Verarbeitung von Texten unbegrenzter Länge.
Sprachverbesserung: Integriert Verbesserungsmodelle, um die Qualität der erzeugten Sprache zu erhöhen und sie natürlicher klingen zu lassen.
Generierungshistorie: Speichert die letzten 3 Generierungsergebnisse, damit Benutzer die Spracheffekte unter verschiedenen Einstellungen vergleichen können.
Unterstützung mehrerer Modelle: Die WebUI unterstützt mehrere TTS-Modelle, einschließlich ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS usw. Benutzer können je nach Bedarf das passende Modell auswählen.
SSML-Unterstützung: Verwendet eine XML-ähnliche SSML-Syntax zur Steuerung des Sprachsyntheseprozesses, geeignet für Szenarien, die eine komplexere Steuerung erfordern.
Podcast-Werkzeug: Hilft Benutzern, lange, mehrstimmige Audioinhalte aus Blog-Skripten zu erstellen.
Untertitelgenerierung: Erstellt SSML-Skripte aus Untertiteldateien, um verschiedene Sprachinhalte zu erzeugen.
GitHub: https://github.com/lenML/ChatTTS-Forge
Online-Erlebnis: https://huggingface.co/spaces/lenML/ChatTTS-Forge














