
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
VIMI: Steuerbares Modell zur Generierung von Charaktervideos
VIMI: Steuerbares Modell zur Generierung von CharaktervideosEinführung
VIMI Großmodell, das weltweit erste von SenseTime eingeführte steuerbare Charakter-Videogenerierungs-KIAIGC-Produkt. Das VIMI Großmodell basiert auf der SenseTime Dayuixin Großmodell-Technologie und kann Personenbilder durch verschiedene Steuerungselemente wie Bewegungsvideos, Animationen, Ton und Text steuern. Die Bildqualität verschlechtert sich nicht oder verzerrt nicht mit der Zeit, wodurch Personenvideos erzeugt werden, die mit den Zielbewegungen übereinstimmen. Neben der Steuerbarkeit übertrifft Vimi auch andere Großmodell-KI-Videogenerierungslösungen in Bezug auf die Stabilität der Personendarstellung und die Länge der erzeugten Videos und kann stabil minutenlange Einzelszenen-Personenvideos erzeugen.
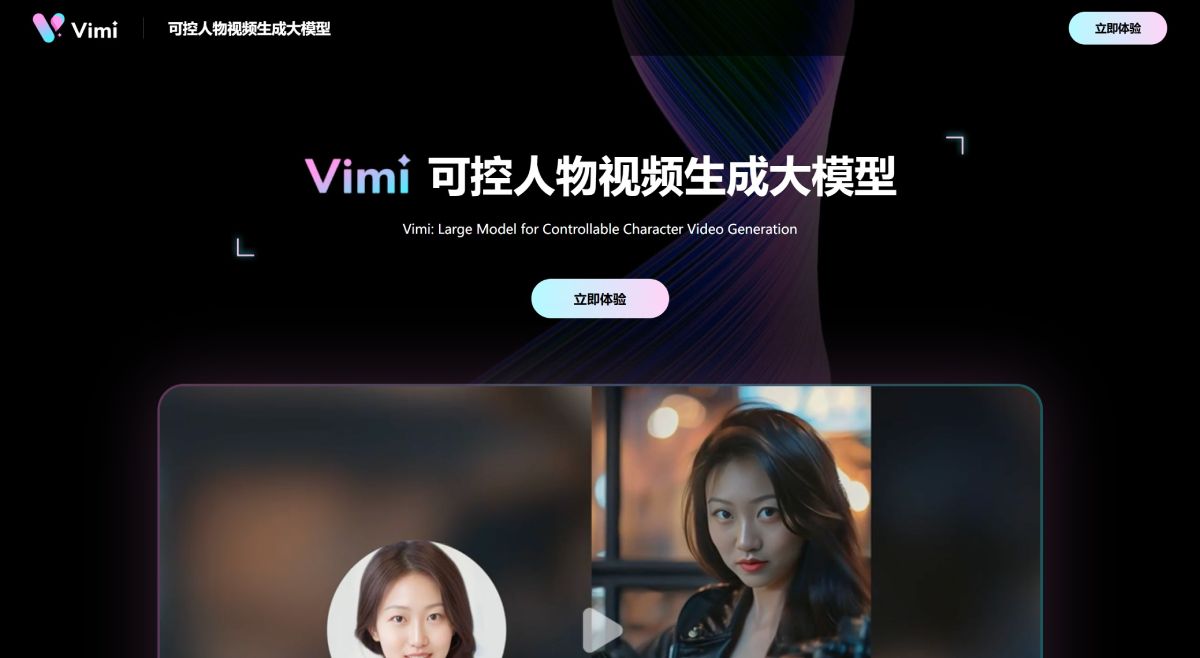
Das VIMI Großmodell kann nicht nur eine präzise Steuerung der Gesichtsausdrücke realisieren, sondern auch die natürlichen Körperbewegungen des Oberkörpers der Person im Foto steuern und automatisch passende Veränderungen von Haaren, Kleidung und Hintergrund erzeugen. Gleichzeitig können auch Licht- und Schattenveränderungen realistisch generiert werden, sodass die Bewegungen und visuellen Effekte der Person fließend und natürlich wirken und das Bild harmonisch und ästhetisch ansprechend ist. Es ist ein stabiles, steuerbares Produkt zur Generierung von Personenvideos.
Funktionsmerkmale des VIMI Großmodells:
Steuerbare Charaktere: VIMI kann die Gesichtsausdrücke und Körperbewegungen von Personen in Videos präzise steuern und Videoinhalte erzeugen, die hochgradig mit den Zielbewegungen übereinstimmen. Sowohl subtile Veränderungen der Gesichtsausdrücke als auch komplexe Ganzkörperaktionen können von VIMI genau erfasst und wiedergegeben werden.
Verschiedene Steuerungsmethoden: VIMI bietet vielfältige Steuereingabemethoden, darunter Personenvideos, Animationsparameter, Sprach- und Texteingaben. Benutzer können die Videogenerierung durch unterschiedliche Eingabemethoden steuern und so reichhaltigere und vielfältigere Videos erstellen.
Minutenlange Einzelszenen: Unterstützt die Erzeugung von minutenlangen Einzelszenen-Personenvideos
Realistische Videoszenengenerierung: VIMI konzentriert sich nicht nur auf die Darstellung der Person selbst, sondern kann auch realistische Videoszenen erzeugen, einschließlich der Vervollständigung von Haaren, Kleidung, Hintergrund und anderer Elemente sowie der Unterstützung von Licht- und Schattenveränderungen. Dadurch wirken die von VIMI erzeugten Videos nicht nur in der Personendarstellung natürlich, sondern auch die gesamte Szene ist harmonisch und einheitlich.
Stabile Generierung langer Videos: VIMI kann bis zu einminütige Einzelszenen-Personenvideos erzeugen, wobei die Bildqualität stabil bleibt und nicht mit der Zeit abnimmt oder verzerrt. Dies ist ein bedeutender Durchbruch.
Anwendungsszenarien des VIMI Großmodells:
VIMI richtet sich hauptsächlich an C-End-Benutzer und ist für verschiedene Unterhaltungs- und Interaktionsszenarien wie Chatten, Singen und Tanzen konzipiert.
Unterhaltsame Kreation: Erfüllt die Unterhaltungs- und Kreationsbedürfnisse einer breiten Benutzerbasis, wie z. B. die Erzeugung digitaler Avatare, Porträtvideos und verschiedener unterhaltsamer Personen-Emoji.
Film- und Fernsehproduktion: Bietet hochwertige Personenvideomaterialien für Film- und Fernsehwerke und reduziert Produktionskosten und -zeit.
Animationsproduktion: Unterstützt Animationsschaffende bei der Verwendung von Skeletten zur Bewegungserzeugung und steigert die Effizienz der Animationsproduktion.
Das Vimi Großmodell wurde auf der World Artificial Intelligence Conference (WAIC) 2024 vorgestellt und mit der höchsten Auszeichnung der Konferenzausstellung, dem „Schatz des Museums", ausgezeichnet. Das Vimi Großmodell kann Einzelszenen-Personenvideos von über einer Minute Länge erzeugen, wobei die Bildqualität nicht mit der Zeit abnimmt oder verzerrt. Darüber hinaus kann es Umgebungsszenen entsprechend den Personenbewegungen anpassen, Veränderungen des Kamerawinkels simulieren und Haarbewegungen darstellen, um realistische visuelle Effekte zu bieten.
Vimi wird vollständig für die breite Benutzerschaft freigegeben. Benutzer müssen lediglich hochauflösende Personenfotos aus verschiedenen Blickwinkeln hochladen, um automatisch digitale Avatare und Porträtkurzfilme in unterschiedlichen Stilen zu erzeugen. Für Selfie-Liebhaber unterstützt Vimi verschiedene Unterhaltungs- und Interaktionsszenarien wie Chatten, Singen und Tanzen.















