
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
CosyVoice: Natürliche, menschenähnliche Stimme
CosyVoice: Natürliche, menschenähnliche StimmeEinführung
CosyVoice ist ein auf Sprachquantisierungscodierung basierendes Großmodell zur Spracherzeugung, eine neuartige Sprachsynthesetechnologie, dieTextverständnis und Spracherzeugung tiefgreifend miteinander verschmilzt.Es diskretisiert die Sprache und nutzt Großmodell-Technologie, um ein natürlich fließendes Spracherzeugungserlebnis zu ermöglichen. Im Vergleich zu herkömmlichen Spracherzeugungstechnologien kann CosyVoiceverschiedenste Textinhalte präzise analysieren und interpretieren und sie in natürlich wirkende Sprache wie von einer echten Person verwandeln.
Sie müssen lediglich 3–10 Sekunden Originalaudio bereitstellen, und CosyVoice kann die simulierte Stimme erzeugen, einschließlich Details wie Prosodie und Emotion, und unterstützt auch mehrsprachige Spracherzeugung.
CosyVoice Projekt-Webseite:https://www.modelscope.cn/studios/iic/CosyVoice-300M
CosyVoice Quellcode-Adresse:https://github.com/FunAudioLLM/CosyVoice
CosyVoice API-Adresse:https://help.aliyun.com/zh/model-studio/developer-reference/cosvoice-large-model-for-speech-synthesis/?spm=a2c4g.11186623.0.0.56f01751Ke29mh
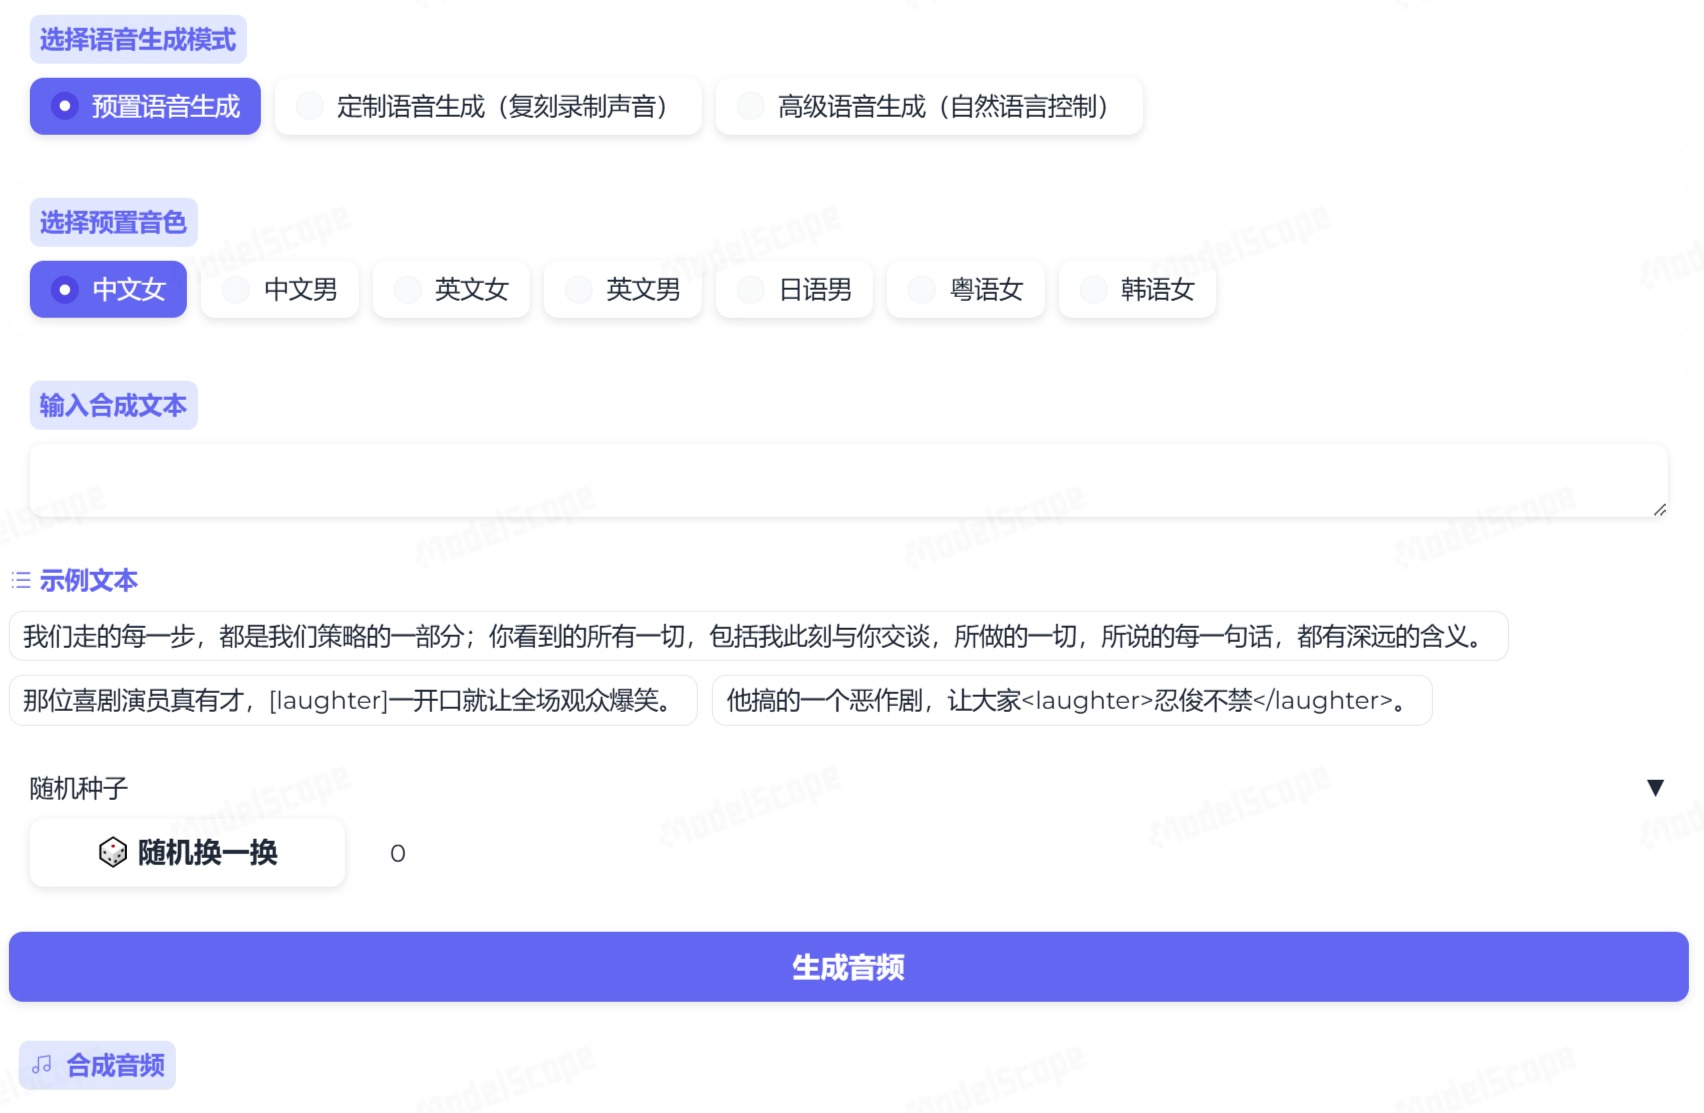
CosyVoice Funktionen und Merkmale:
Hohe Menschlichkeit: Verwendet das von Alibabas Tongyi Speech Lab selbst entwickelte generative neuronale Netzwerk-Großmodell CosyVoice, sodass die erzeugte Sprache in Intonation, Prosodie und emotionalem Ausdruck ein übermenschliches Maß erreicht.
Mehrsprachig: CosyVoice unterstützt die Erzeugung in 5 Sprachen – Chinesisch, Englisch, Japanisch, Kantonesisch und Koreanisch – und konzentriert sich auf natürliche Spracherzeugung mit Unterstützung für Mehrsprachigkeit, Stimmklang- und Emotionssteuerung, mit deutlich besseren Ergebnissen als herkömmliche Spracherzeugungsmodelle.
Vielfältige Stimmenauswahl: Bietet eine riesige Auswahl an hochwertigen Stimmbibliotheken, einschließlich verschiedener Geschlechter, Altersgruppen, Dialekte und zahlreicher besonderer Stimmen, um die individuellen Anforderungen der Nutzer in unterschiedlichen Szenarien zu erfüllen. Ob der ernste Ton von Nachrichtensendungen oder der emotionale Ausdruck beim Geschichtenerzählen – alles wird mühelos gemeistert.
Echtzeit- und effiziente Synthese: Das System verfügt über eine hervorragende Reaktionsgeschwindigkeit und Streaming-Sprachsynthesefähigkeit. Sowohl bei langen Dokumenten als auch bei kurzen Befehlen ermöglicht es eine schnelle und präzise Echtzeit-Sprachsynthese.
Emotions- und Prosodiekontrolle: CosyVoice unterstützt die Erzeugung hochgradig menschenähnlicher Sprache mit reichhaltigen sprachlichen Soundeffekten und mehreren Emotionen, wie z. B. Lachen, Füllwörter und verschiedene emotionale Ausdrucksformen.
Stimmklonung: Sie müssen lediglich 3–10 Sekunden Originalaudio bereitstellen, und CosyVoice kann die simulierte Stimme klonen, einschließlich Details wie Prosodie und Emotion, und unterstützt auch mehrsprachige Spracherzeugung.
CosyVoice Anwendungen:
CosyVoice eignet sich für eine Vielzahl von Anwendungsszenarien, wie z. B. intelligente Kundendienste, Hörbücher, Fahrzeugnavigation, Bildungsbetreuung usw.
Sprachinhalte für die Ansage durch intelligente Geräte/Roboter, wie z. B. intelligente Kundendienstroboter, smarte Lautsprecher, digitale Avatare und Sprachassistenten.
Szenarien in der Audio-Video-Produktion, in denen Text in Sprache umgewandelt werden muss, wie z. B. Vorlesen von Romanen, Nachrichtensendungen, Filmkommentare und Skript-Synchronisation.
CosyVoice erweitert die Möglichkeiten der Sprachinteraktion erheblich, verbessert das Nutzererlebnis und bietet gleichzeitig eine starke Unterstützung für die intelligente Transformation von Unternehmen.
Im Vergleich zum kürzlich sehr populär gewordenen ChatTTS zeigt sich, dass die synthetisierten Audiodateien von CosyVoice eine höhere Inhaltskonsistenz aufweisen. CosyVoice ermöglicht eine feinkörnige Steuerung von Emotion und Prosodie der erzeugten Sprache, was die emotionale Ausdruckskraft deutlich verbessert, und es treten kaum Halluzinationen mit zusätzlichen ungewollten Wörtern auf. CosyVoice modelliert die semantischen Informationen im zu synthetisierenden Text sehr gut und übertrifft in Bezug auf Inhaltskonsistenz und Sprecherähnlichkeit den Menschen.














