
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ToucanTTS: großes mehrsprachiges Modell mit über 7.000 Sprachen
ToucanTTS: großes mehrsprachiges Modell mit über 7.000 SprachenEinführung
ToucanTTS, ein Toolkit für modernste Sprachsynthese, ein umfassendes Text-to-Speech-Modell (TTS), entwickelt vom Institut für Maschinelle Sprachverarbeitung (IMS) der Universität Stuttgart. ToucanTTS ist ein umfangreiches mehrsprachiges Modell, das über 7.000 Sprachen abdeckt.
ToucanTTS unterstützt nicht nur mehrere Sprachen, sondern bietet auch eine Multi-Sprecher-Sprachsynthese, die den Rhythmus, die Betonung und die Intonation verschiedener Sprecher imitieren kann.
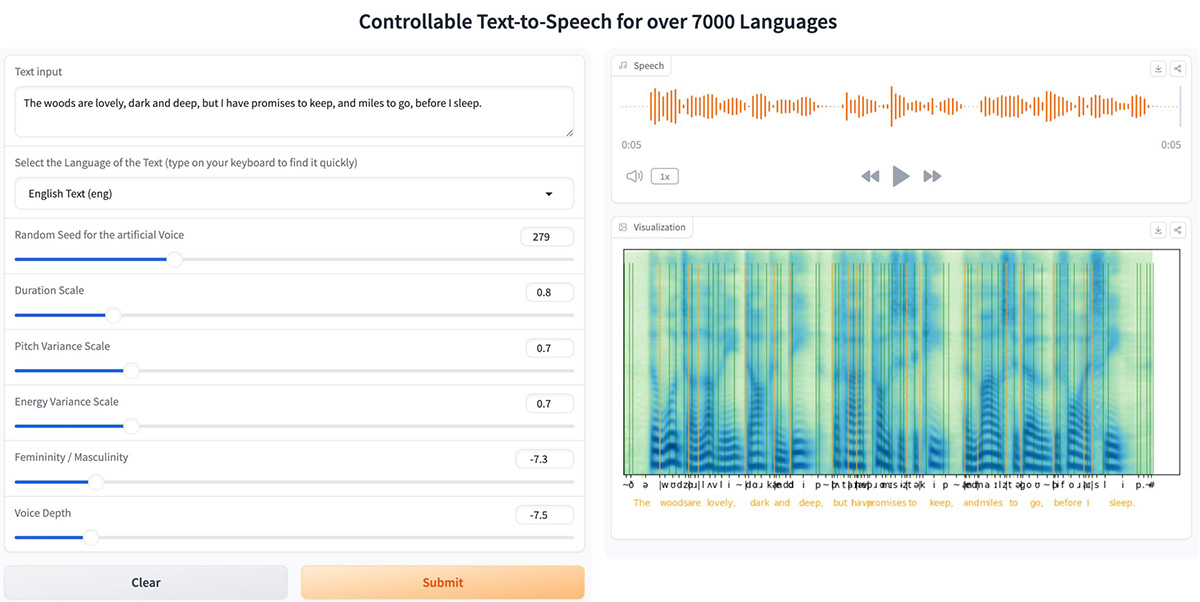
Darüber hinaus bietet es interaktive Demonstrationen für verschiedene Anwendungen, darunter Sprachgestaltung, Stilklonierung, mehrsprachige Sprachsynthese und manuell bearbeitetes Vorlesen von Gedichten, die seine Vielseitigkeit und starke Leistungsfähigkeit zeigen.
Funktionen von ToucanTTS:
Mehrsprachige Unterstützung: ToucanTTS kann Sprache in über 7.000 Sprachen synthetisieren und ist damit das TTS-Modell mit der größten verfügbaren Sprachvielfalt. Diese umfassende Sprachunterstützung spricht ein breites internationales Publikum an.
Multi-Sprecher-Sprachsynthese: ToucanTTS ermöglicht wahrscheinlich die Sprachsynthese mehrerer Sprecher, sodass Benutzer den Rhythmus, die Betonung und die Intonation verschiedener Sprecher imitieren können. Dies ist besonders nützlich für Anwendungen, die stilistische Vielfalt und Sprachanpassung erfordern.
Human-in-the-Loop-Bearbeitung: ToucanTTS ermöglicht es Benutzern, die synthetisierte Sprache an bestimmte Anforderungen anzupassen, was besonders für Literaturstudien und Gedichtvortragsaufgaben hilfreich ist.
Architektur: ToucanTTS basiert auf der FastSpeech-2-Architektur und wurde durch PortaSpeech inspiriert verbessert. Es umfasst ein PostNet auf Basis von Normalisierungsflüssen sowie einen unabhängigen Aligner, der mittels Connectionist Temporal Classification (CTC) und Spektrogramm-Rekonstruktion trainiert wurde, und ermöglicht eine hochwertige, natürlich klingende Sprachsynthese.
Artikulatorische Repräsentation: Eine einzigartige Funktion von ToucanTTS ist die Verwendung artikulatorischer Repräsentationen von Phonemen als Eingabe. Durch die Nutzung mehrsprachiger Daten werden Qualität und Verfügbarkeit der Sprachsynthese für ressourcenarme Sprachen verbessert.
Interaktive Demonstrationen: ToucanTTS bietet interaktive Demonstrationen für verschiedene Anwendungen, wie z. B. Sprachgestaltung, Stilklonierung, mehrsprachige Sprachsynthese und manuell bearbeitetes Vorlesen von Gedichten. Diese Demonstrationen zeigen die Vielseitigkeit und Robustheit des Toolkits.
Training und Inferenz: Das Toolkit stellt umfassende Anweisungen zur Installation von Abhängigkeiten, Speicherkonfiguration, zum Herunterladen vortrainierter Modelle und zum Ausführen der Trainingspipeline bereit. Es unterstützt sowohl das Feintuning vortrainierter Modelle als auch das Training von Grund auf.
Eigenschaften von ToucanTTS:
Mehrsprachige und Multi-Sprecher-Unterstützung:Durch umfangreiche mehrsprachige vortrainierte Modelle wird die mehrsprachige Sprachsynthese mit über 7.000 Sprachen unterstützt. Es ermöglicht Multi-Sprecher-Sprachsynthese und klonen sprecherübergreifend Prosodie wie Rhythmus, Betonung und Intonation.
Human-in-the-Loop-Bearbeitung:Ermöglicht die Human-in-the-Loop-Bearbeitung synthetisierter Sprache, z. B. für Gedichtrezitation und Literaturstudien.
Interaktive Demonstrationen:Bietet interaktive Demonstrationen für umfangreiche mehrsprachige Sprachsynthese, sprecherübergreifende Stilklonierung, Sprachgestaltung und manuell bearbeitete Gedichtrezitation.
Architektur und Komponenten:Basiert hauptsächlich auf der FastSpeech-2-Architektur mit einigen Änderungen, wie z. B. einem von PortaSpeech inspirierten PostNet auf Basis von Normalisierungsflüssen. Enthält einen eigenständigen, mit CTC trainierten Aligner und Spektrogramm-Rekonstruktion für verschiedene Anwendungen. Stellt vortrainierte Modelle für mehrsprachige Modelle, Aligner, Embedding-Funktionen, Vocoder und Embedding-GAN bereit.
Benutzerfreundlichkeit:Vollständig in Python und PyTorch implementiert, auf Einfachheit und Anfängerfreundlichkeit ausgelegt und gleichzeitig leistungsstark.
Artikulatorische Repräsentation:Das IMS-Toucan-System verwendet artikulatorische Repräsentationen von Phonemen als Eingabe, sodass mehrsprachige Daten ressourcenarmen Sprachen zugutekommen.
Anwendungen von ToucanTTS:
Sprachsynthese für mehrsprachige Anwendungen: ToucanTTS unterstützt über 7.000 Sprachen und eignet sich hervorragend für die Erstellung mehrsprachiger Anwendungen, wie z. B. globale Kundenservice-Plattformen, Bildungswerkzeuge und Barrierefreiheitsfunktionen für Nichtmuttersprachler.
Sprachgestaltung und -anpassung: Die Multi-Sprecher-Sprachsynthese ermöglicht die Erstellung individueller Stimmen, die in verschiedenen Anwendungen eingesetzt werden können, z. B. für virtuelle Assistenten, Hörbücher und personalisierte Marketingbotschaften.
Human-in-the-Loop-Bearbeitung: Diese Funktion ist besonders nützlich in der Literaturforschung und bei Aufgaben zum Gedichtvortrag, bei denen eine präzise Steuerung der Sprachausgabe erforderlich ist, um bestimmte stilistische Anforderungen zu erfüllen.
Wie verwendet man ToucanTTS?
Mit nur wenigen einfachen Schritten können Sie ToucanTTS verwenden.
1. Von GitHub herunterladen
Laden Sie den Code von GitHub herunter. git clone https://github.com/2noise/ToucanTTS lädt ToucanTTS herunter.
2. Abhängigkeiten installieren
Stellen Sie vor Beginn sicher, dass die erforderlichen Pakete installiert sind. Sie benötigen torch und ToucanTTS. Falls noch nicht installiert, können Sie dies mit pip tun:
3. Erforderliche Bibliotheken importieren
Importieren Sie die erforderlichen Bibliotheken für Ihr Skript. Sie benötigen torch, ToucanTTS und Audio aus IPython.display.
4. ToucanTTS initialisieren: Erstellen Sie eine Instanz der Klasse ToucanTTS und laden Sie das vortrainierte Modell.
5. Text vorbereiten: Definieren Sie den Text, der in Sprache umgewandelt werden soll. Ersetzen Sie <YOUR TEXT HERE> durch Ihren gewünschten Text.
6. Sprache erzeugen: Verwenden Sie die infer-Methode, um aus dem Text Sprache zu erzeugen. Setzen Sie use_decoder=True, um den Decoder zu aktivieren.
7. Audio abspielen
Verwenden Sie die Audio-Klasse aus IPython.display, um die erzeugte Audioausgabe abzuspielen. Stellen Sie die Abtastrate auf 24.000 Hz ein und aktivieren Sie die automatische Wiedergabe.
8. Skript abschließen
GitHub-Link von ToucanTTS: https://github.com/DigitalPhonetics/IMS-Toucan
Online-Demo-Link: https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
Datensatz-Link: https://huggingface.co/datasets/Flux9665/BibleMMS














