
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Etna: Text-zu-Video-AIGC-Modell
Etna: Text-zu-Video-AIGC-ModellEinführung
Das Etna-Modell ist eine fortschrittliche Text-zu-Video-Modellsoftware, die von Seven Volcanoes Technology entwickelt wurde. Es verfügt über fundierte Forschung und Anwendung in den Bereichen Verarbeitung natürlicher Sprache, generative kontradiktorische Netzwerke und Computer-Vision-Technologie.
Das Etna-Modell verwendet die neueste neuronale Netzwerkarchitektur und kombiniert auf clevere Weise die semantischen Verständnisfähigkeiten des Transformer-Modells mit der Inhaltsgenerierungsstrategie des Diffusionsmodells, um eine effiziente Umwandlung von Text zu Video zu realisieren. Dieses Modell unterstützt die Generierung von Videos mit einer Länge von 8-15 Sekunden, und die Videoflüssigkeit ist extrem hoch, mit bis zu 60 Bildern pro Sekunde.
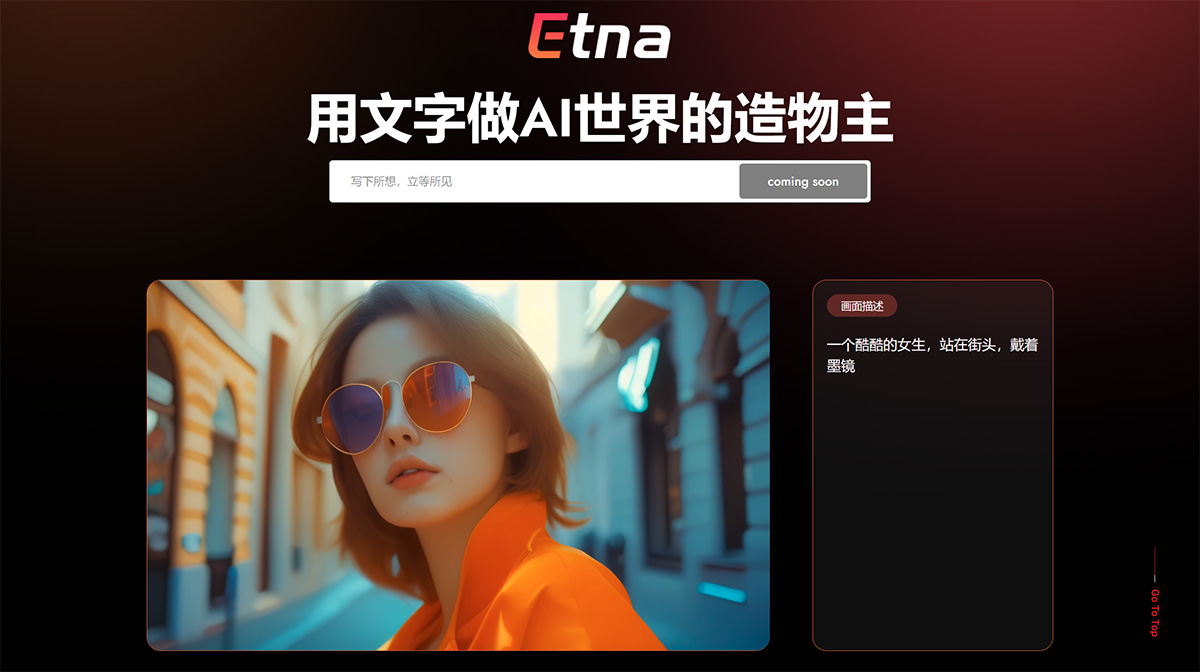
Technische Merkmale des Etna-Modells:
Verwendung der neuesten neuronalen Netzwerkarchitektur
Kombination der semantischen Verständnisfähigkeiten des Transformer-Modells mit der Inhaltsgenerierungsstrategie des Diffusionsmodells
Unterstützung der effizienten Umwandlung von Text zu Video
Anwendungsszenarien des Etna-Modells:
Die Anwendungsszenarien des Etna-Modells sind sehr umfangreich und umfassen unter anderem die Bereiche Video-Inhaltserstellung, Spieleentwicklung, Kunst und Unterhaltung sowie Bildung und Training.
Video-Inhaltserstellung: Filme, Animationen, Werbung und Social-Media-Plattformen
Spieleentwicklung: Erstellung von In-Game-Animationen und Szenen
Kunst und Unterhaltung: Schaffung einzigartiger visueller Kunstwerke
Bildung und Training: Erstellung von Lehrvideos zur Steigerung des Lerninteresses und der Lerneffektivität
Diese Anwendungsszenarien zeigen das breite Anwendungspotenzial und die Innovationsfähigkeit des Etna-Modells in verschiedenen Bereichen.
FAQs zum Etna-Modell:
Was kann Etna?
Das Etna-Modell von Seven Volcanoes Technology ist ein Text-zu-Video-KIGC-Modell, das in der Lage ist, basierend auf kurzen Textbeschreibungen entsprechende Videoinhalte zu generieren.
Welche technische Architektur verwendet Etna?
Das Backbone-Netzwerk des Etna-Modells verwendet derzeit die Diffusionsarchitektur. Gleichzeitig wird auf einem größeren Datensatz mit einer Sora-ähnlichen Diffusion+Transformer-Architektur experimentiert und diese angepasst.
Was ist das technische Prinzip von Etna?
Das Etna-Modell fügt in Sprach- und Bildmodellen räumlich-zeitliche Faltungs- und Aufmerksamkeitsschichten ein, die Videodaten verarbeiten können, also die zeitliche Kontinuität in Bildsequenzen berücksichtigen. Dies bedeutet, dass Etna über ein gewisses räumlich-zeitliches Verständnis verfügt und in der Lage ist, Videoinhalte mit zeitlicher Dimension zu verstehen und zu generieren.
Wie trainiert Etna das Modell?
Das Etna-Modell wird umfassend auf einem großen Videodatensatz trainiert. Der Prozess verwendet fortschrittliche Deep-Learning-Technikstrategien, einschließlich groß angelegtem LDS-Training, komplexer HPO-Hyperparameteroptimierung und DPO-Feintuning, um die starke Leistung und Generierungsfähigkeit des Modells sicherzustellen.
Als wichtige innovative Errungenschaft von Seven Volcanoes Technology im Bereich der KI-Videotechnologie realisiert das Etna-Modell durch die Kombination der neuesten neuronalen Netzwerkarchitektur und Technikstrategien eine effiziente Umwandlung von Text zu hochwertigen Videos und zeigt umfangreiche Anwendungsszenarien sowie kommerzielles Potenzial.












