
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
CogVideo: Videos aus Textbeschreibungen generieren
CogVideo: Videos aus Textbeschreibungen generierenEinführung
CogVideo ist derzeit das größte vortrainierte Text-zu-Video-Generierungsmodell im allgemeinen Bereich und verfügt über 9,4 Milliarden Parameter. CogVideo nutzt das vortrainierte Text-zu-Bild-Generierungsmodell (CogView2) effektiv für ein Text-zu-Video-Generierungsmodell und verwendet eine mehrstufige Trainingsstrategie mit unterschiedlichen Bildraten.
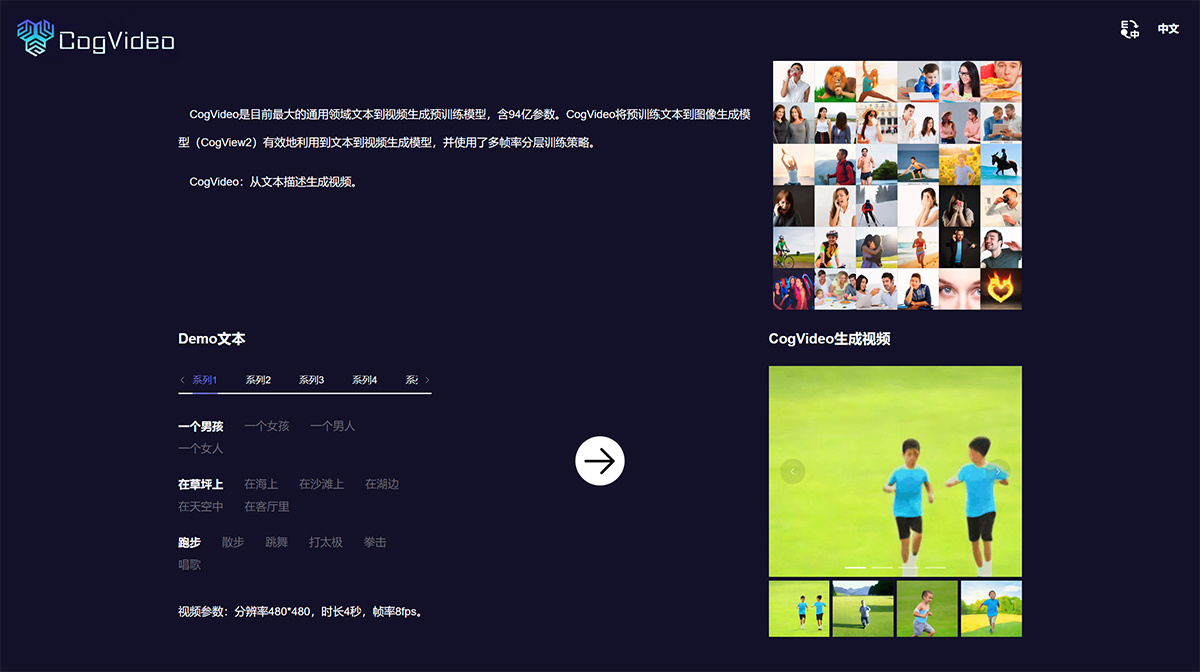
CogVideo ist ein von der Tsinghua-Universität und dem BAai-Team um Tang Jie vorgestelltes Open-Source-Vortrainingsmodell zur Text-zu-Video-Generierung, das auf GitHub große Aufmerksamkeit erregt hat. Die Kerntechnologie dieses Modells basiert auf Deep-Learning-Algorithmen und einer Modellarchitektur, die in der Lage ist, Textbeschreibungen in lebendige und realistische Videoinhalte umzuwandeln.
CogVideo verwendet eine mehrstufige Trainingsstrategie mit unterschiedlichen Bildraten und erreicht durch die Übernahme des vortrainierten Text-Bild-Generierungsmodells CogView eine effiziente Umwandlung von Text zu Video. Darüber hinaus verfügt CogVideo über eine fortschrittliche Funktion zur Erzeugung dynamischer Szenen und kann auf Basis detaillierter Textbeschreibungen der Nutzer 3D-Umgebungen und Animationen generieren. Gleichzeitig ermöglicht CogVideo eine effiziente Feinabstimmung des vortrainierten Text-zu-Bild-Modells für die Text-zu-Video-Generierung und vermeidet so das kostspielige vollständige Vortraining von Grund auf.
Das Training von CogVideo basiert hauptsächlich auf einem mehrstufigen Bildraten-Generierungsrahmen: Zunächst werden auf Grundlage von CogView2 durch Eingabetext mehrere Bilder erzeugt, und anschließend wird durch Zwischenbild-Interpolation die Bildrate erhöht, um die Gesamtheit der Videosequenz zu erstellen. Diese Trainingsstrategie verleiht CogVideo die Fähigkeit, die Intensität der Veränderungen im Generierungsprozess zu steuern, und trägt zu einer besseren Abstimmung von Text- und Videosemantik bei. Das Modell verwendet 9,4 Milliarden Parameter und gehört damit zu den derzeit größten vortrainierten Text-zu-Video-Generierungsmodellen im allgemeinen Bereich.
CogVideo unterstützt nicht nur chinesische Eingaben, sondern bietet auch ausführliche Dokumentationen und Tutorials, die Forschenden und Entwicklern die Nutzung und Anpassung erleichtern. Seine Open-Source-Natur und einfache Handhabung verleihen ihm einen wichtigen Anwendungswert im Bereich des multimodalen Videoverstehens. Darüber hinaus markiert das Erscheinen von CogVideo einen bedeutenden Fortschritt der KI-Technologie im Bereich der Videogenerierung und eröffnet disruptive Vorstellungsmöglichkeiten für künftige kreative Arbeiten.
Insgesamt ist CogVideo als leistungsstarkes Text-zu-Video-Generierungsmodell in der Lage, vortrainierte Modelle effektiv zu nutzen und qualitativ hochwertige Videos zu erzeugen. Allerdings bestehen im Generierungsprozess noch einige Herausforderungen, wie beispielsweise die Knappheit und schwache Korrelation von Text-Video-Datensätzen, die das Verständnis des Modells für komplexe Bewegungssemantik behindern. Diese Aspekte erfordern weitere Forschung und Verbesserungen.















