
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DiffusionGPT: LLM-gesteuertes Text-zu-Bild-Generierungssystem
DiffusionGPT: LLM-gesteuertes Text-zu-Bild-GenerierungssystemEinführung
DiffusionGPT, ein von ByteDance entwickeltes All-in-One-System zur Text-zu-Bild-Generierung, das von einem LLM angetrieben wird und speziell dafür konzipiert ist, hochwertige Bilder für verschiedene Eingabeaufforderungen zu erzeugen. Sein Hauptziel ist es, die Eingabeaufforderungen zu analysieren und das Generierungsmodell zu ermitteln, das die optimalsten Ergebnisse liefert – ein Modell, das sich durch hohe Generalisierung, hohe Effizienz und Benutzerfreundlichkeit auszeichnet.
Das Besondere an DiffusionGPT ist, dass es Experten-Bildgenerierungsmodelle aus verschiedenen Bereichen integriert. Anschließend wird ein LLM eingesetzt, um diese Bildgenerierungsmodelle anzubinden, sodass das LLM die verschiedenen Textaufforderungen verarbeiten und verstehen kann. Schließlich wird auf Basis der verstandenen Informationen das am besten geeignete Bildmodell zur Bilderzeugung ausgewählt. So funktioniert es ähnlich wie GPT-4: durch Chatten Bilder zeichnen ...
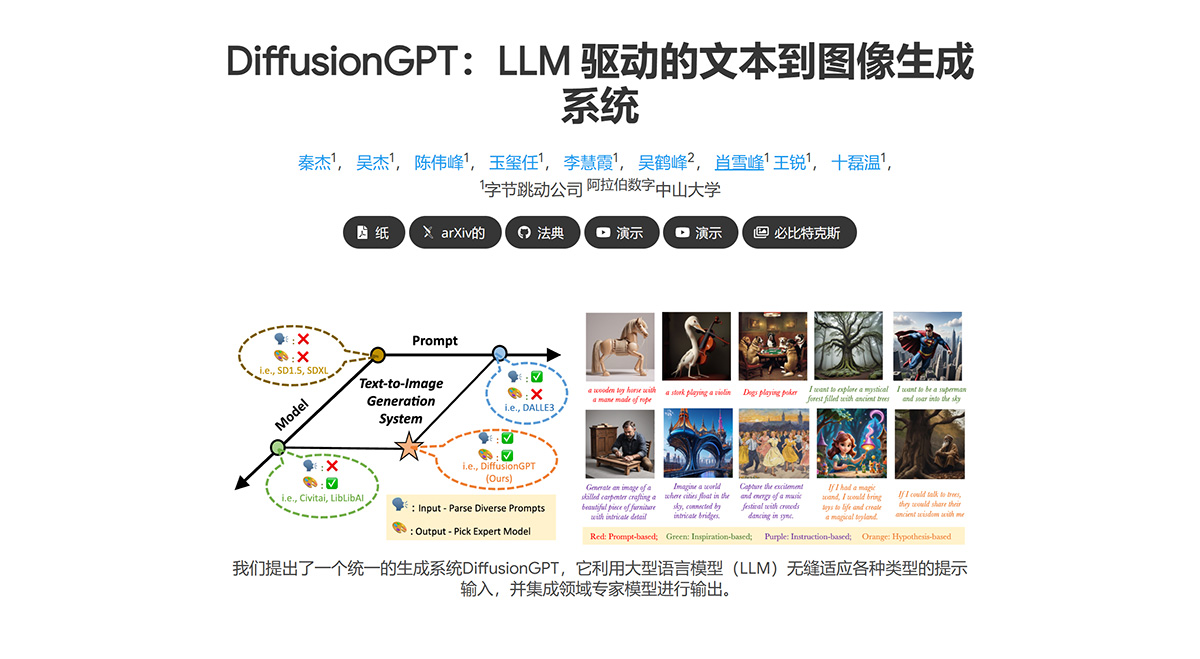
Hauptmerkmale von DiffusionGPT:
1. Vielfältige Verarbeitung von Textaufforderungen: DiffusionGPT kann verschiedene Arten von Textaufforderungen verstehen und verarbeiten, einschließlich konkreter Anweisungen, abstrakter Inspirationen und komplexer Hypothesen.
2. Integration mehrerer Expertenmodelle aus verschiedenen Bereichen: Das System integriert Bilddiffusionsmodelle aus vielen Bereichen, wobei jedes Modell in seinem spezifischen Bereich über professionelle Bildgenerierungsfähigkeiten verfügt. Solche Modelle sind auf die Bildgenerierung in bestimmten Bereichen spezialisiert, beispielsweise Naturlandschaften, Porträts oder Kunstwerke.
Dies bedeutet, dass das System nicht nur gewöhnliche Bilder erzeugen kann, sondern auch spezifischere und komplexere Bildgenerierungsaufgaben bewältigt, wie etwa Bilder in einem bestimmten Stil oder Typ. So lassen sich etwa der Stil eines bestimmten Künstlers, ein Comic-Stil oder fotografische Techniken imitieren.
3. LLM-gesteuert: DiffusionGPT nutzt ein Large Language Model (LLM), um die vom Benutzer eingegebenen Textaufforderungen zu analysieren und zu verstehen. Dieser Prozess ähnelt der Art und Weise, wie andere LLM-basierte Systeme (wie GPT-4) Text verarbeiten, ist jedoch speziell auf das Verständnis von Anweisungen und Beschreibungen für die Bildgenerierung zugeschnitten.
4. Intelligente Auswahl des geeigneten Bildmodells: Basierend auf dem Verständnis der Textaufforderungen kann DiffusionGPT intelligent das am besten geeignete Bildgenerierungsmodell zur Bilderzeugung auswählen. Dies umfasst nicht nur die Auswahl des richtigen Modells, sondern auch die Anpassung der Generierungsparameter, um den Anforderungen des Benutzers bestmöglich gerecht zu werden.
5. Ausgabe hochwertiger Bilder: Durch die präzise Abstimmung der Textaufforderungen auf das beste Generierungsmodell kann DiffusionGPT hochwertige Bilder erzeugen, die eng mit den Benutzeranforderungen übereinstimmen.
6. Benutzerfeedback und Vorteilsdatenbank: In Kombination mit Benutzerfeedback und einer Vorteilsdatenbank kann das System die Modellauswahl entsprechend den Benutzerpräferenzen anpassen und so die Relevanz und Qualität der Bildgenerierung verbessern.
Beispiel: In der frühen Nutzungsphase des Systems könnten Benutzer Feedback zu den erzeugten Bildern geben, etwa „Die Farben dieses Bildes sind zu dunkel". DiffusionGPT nutzt dieses Feedback, um seine Modellauswahl anzupassen, sodass zukünftige Bildgenerierungen besser den Vorlieben der Benutzer entsprechen.
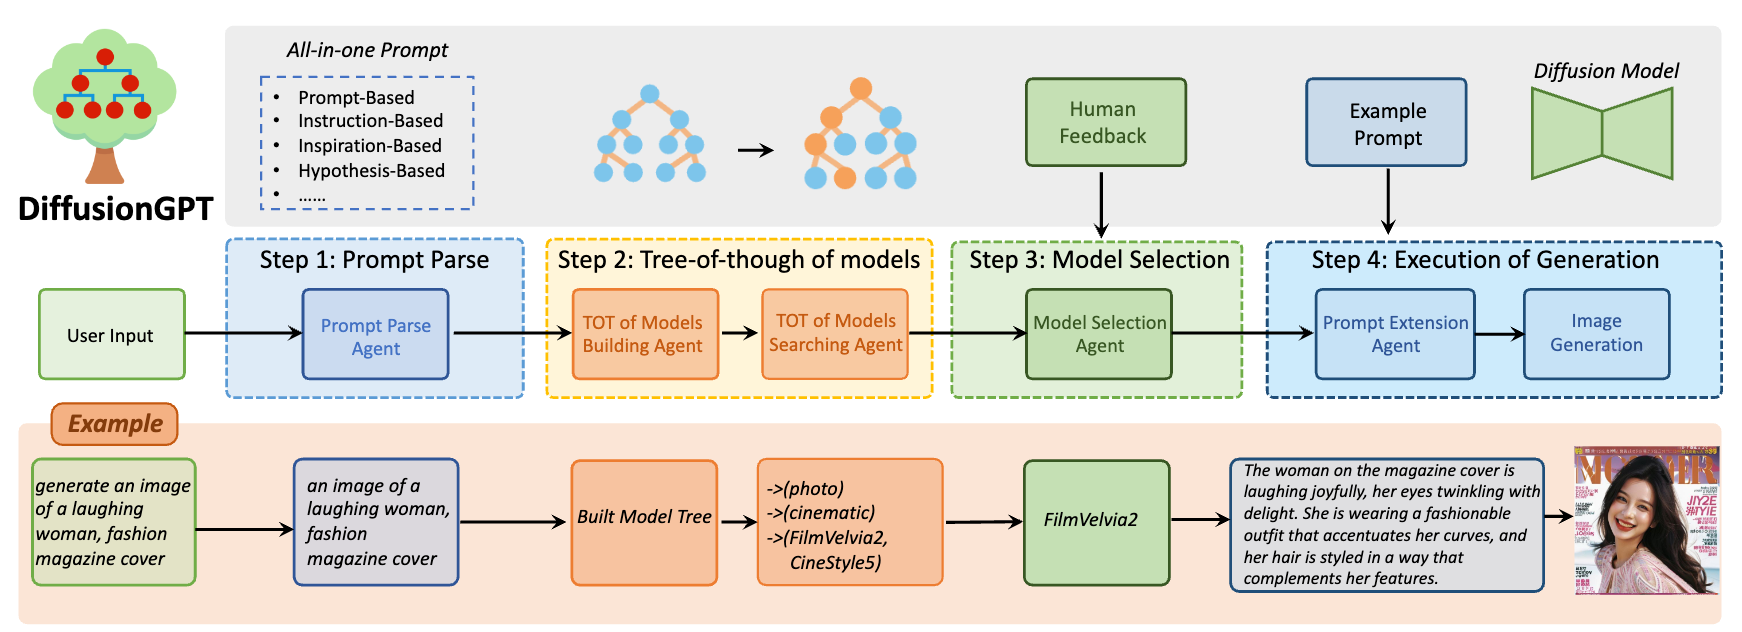
Hauptarbeitsprinzip von DiffusionGPT:
1. Eingabeanalyse: Der Benutzer gibt eine Textaufforderung ein, etwa eine Beschreibung, eine Anweisung oder eine Inspiration.
Das Large Language Model (LLM) ist dafür zuständig, diese Textaufforderungen zu analysieren und deren Bedeutung und Anforderungen zu verstehen.
2. Aufbau eines Tree-of-Thought: Je nach Bildgenerierungsaufgabe konstruiert das System einen „Tree-of-Thought" – eine Struktur zur Organisation verschiedener Bildgenerierungsmodelle.
Dieser Tree-of-Thought basiert auf Vorwissen und menschlichem Feedback und umfasst Expertenmodelle aus vielen Bereichen.
3. Modellauswahl: Basierend auf den Ergebnissen der LLM-Analyse bestimmt das System über den Tree-of-Thought das für die aktuelle Textaufforderung am besten geeignete Bildgenerierungsmodell. Bei der Auswahl können auch Benutzerpräferenzen und historisches Feedback berücksichtigt werden, die in der Vorteilsdatenbank gespeichert sind.
4. Bildgenerierung: Sobald das geeignete Modell ausgewählt wurde, wird es zur Bilderzeugung eingesetzt. Die erzeugten Bilder stehen in engem Zusammenhang mit der eingegebenen Textaufforderung und spiegeln die Absicht und Vorlieben des Benutzers wider.
5. Ergebnisausgabe: Die endgültig erzeugten Bilder werden dem Benutzer präsentiert.
Diese Bilder können vielfältig sein und umfassen unter anderem konkret beschriebene Szenen, konzeptionelle Kunstwerke oder Bilder, die einem bestimmten Stil entsprechen.
6. Optimierungsprozess durch Benutzerfeedback:
Das Feedback der Benutzer zu den erzeugten Bildern wird verwendet, um die Vorteilsdatenbank anzureichern, wodurch das System die Benutzerpräferenzen besser versteht und die anschließende Modellauswahl sowie Bildgenerierung optimiert.
DiffusionGPT zeigt eine hohe Realitätstreue und Detailgenauigkeit bei der Erzeugung von Bildern in Kategorien wie Menschen und Szenen.Im Vergleich zu Basismodellen (wie SD1.5) weisen die von DiffusionGPT erzeugten Bilder deutliche Verbesserungen bei visueller Wiedergabetreue und Detailerfassung auf.DiffusionGPT schneidet in Bezug auf Bildbelohnung und ästhetische Bewertung besser ab als herkömmliche Stable-Diffusion-Modelle.Bei der quantitativen Bewertung der Bildgenerierungsqualität erzielt DiffusionGPT hohe Werte, was darauf hindeutet, dass die erzeugten Bilder hinsichtlich Qualität und Ästhetik bevorzugt werden.














