
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DreamTalk: Open-Source-Framework, das Personenfotos zum Sprechen bringt
DreamTalk: Open-Source-Framework, das Personenfotos zum Sprechen bringtEinführung
DreamTalk ist ein Framework, das gemeinsam von der Tsinghua-Universität, Alibaba und der Huazhong University of Science and Technology entwickelt wurde. Es basiert auf einem Diffusionsmodell und kann Personenfotos zum Sprechen bringen. Es unterstützt verschiedene Audioeingaben wie Lieder, mehrsprachige Sprache und verrauschte Audios, um Portraitbilder sprechen zu lassen.
DreamTalk Demo-Adresse:https://dreamtalk-project.github.io
DreamTalk Projekt-Adresse:https://dreamtalk-project.github.io/
DreamTalk Paper-Adresse:https://arxiv.org/abs/2312.09767
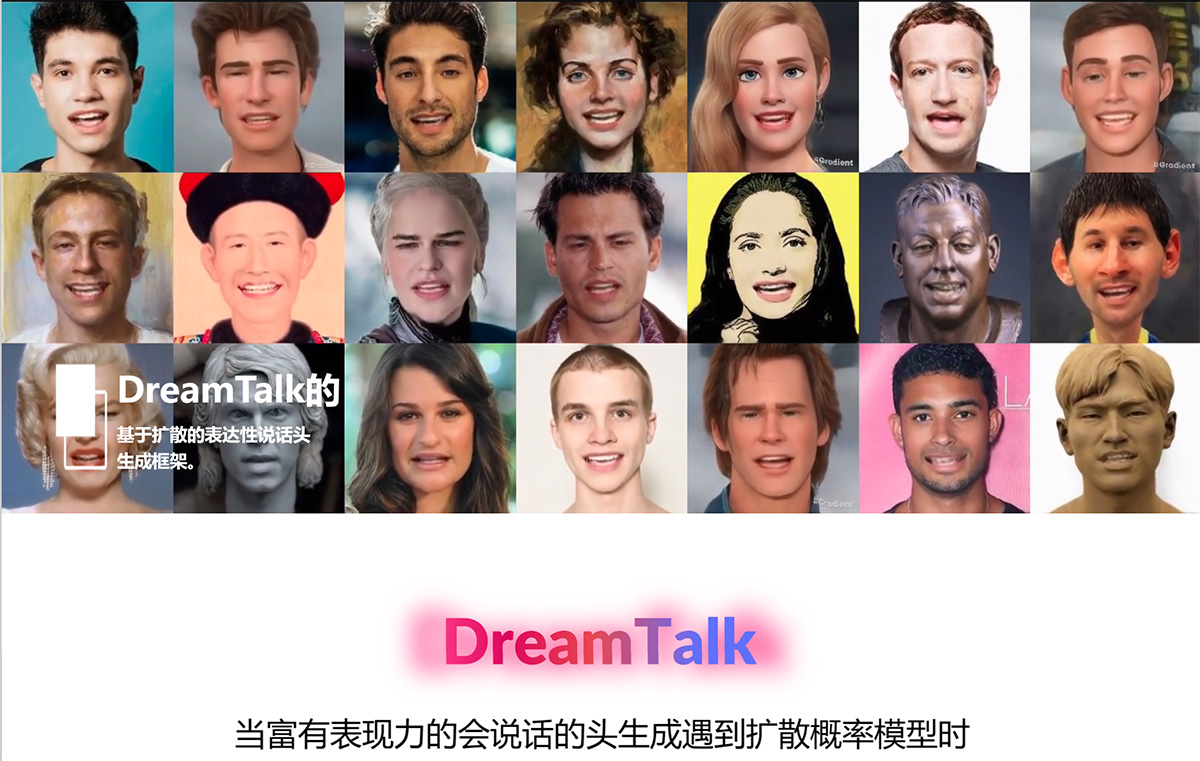
Anwendungsszenarien von DreamTalk:
Mit DreamTalk sprechende Gesichter in verschiedenen Sprachen und mit unterschiedlichen Ausdrucksstilen erzeugen
DreamTalk in der Film- und Fernsehproduktion einsetzen, um realistische virtuelle Charaktere mit Ausdruck und Bewegung zu realisieren
DreamTalk in Mensch-Maschine-Interaktionsszenarien verwenden, um natürliche Gesichtsausdrücke und Lippenbewegungen zu erzielen
Funktionen von DreamTalk:
Im Einzelnen besteht DreamTalk aus drei Schlüsselkomponenten: einem Entrauschungsnetzwerk, einem stilbewussten Lippenexperten und einem Stilprädiktor. Das diffusionsbasierte Entrauschungsnetzwerk kann konsistent hochwertige, audio-gesteuerte Gesichtsbewegungen mit unterschiedlichen Ausdrücken synthetisieren. Um die Ausdruckskraft und Genauigkeit der Lippenbewegungen zu verbessern, führen wir einen stilbewussten Lippenexperten ein, der die Lippensynchronisation steuert und gleichzeitig den Sprechstil berücksichtigt. Um den Bedarf an Ausdrucksreferenz-Videos oder Text zu eliminieren, wird ein zusätzlicher diffusionsbasierter Stilprädiktor verwendet, um den Zielsprechstil direkt aus dem Audio vorherzusagen.
1. Entrauschungsnetzwerk: Dies ist eine der Kernkomponenten und ist für die Erzeugung audio-gesteuerter Gesichtsbewegungen verantwortlich. Das Entrauschungsnetzwerk verwendet ein Diffusionsmodell, um schrittweise Rauschen zu entfernen und so klare, hochwertige Gesichtsausdrücke zu erzeugen. Dieser Prozess umfasst die schrittweise Wiederherstellung klarer Gesichtsbewegungen aus verrauschten Daten.
2. Stilbewusster Lippenexperte: Diese Komponente konzentriert sich darauf, die Ausdruckskraft und Genauigkeit der Lippenbewegungen zu verbessern. Sie analysiert den Sprechstil, um die Lippensynchronisation zu steuern, und stellt sicher, dass die erzeugte Animation sowohl natürlich als auch dem Stil des Sprechers entsprechend ist.
3. Stilprädiktor: Um die Abhängigkeit von Ausdrucksreferenzvideos oder Text zu beseitigen, führt DreamTalk einen diffusionsbasierten Stilprädiktor ein. Dieser Prädiktor kann den Zielsprechstil direkt aus dem Audio vorhersagen, ohne dass zusätzliche Ausdrucksreferenzvideos oder Text erforderlich sind.
4. Audio- und Videoverarbeitung: Verarbeitet Audioeingaben, extrahiert die wichtigsten Audiomerkmale und verwendet diese Merkmale zur Steuerung der Gesichtsanimation. Gleichzeitig kann es Videoeingaben verarbeiten, um bestimmte Ausdrücke und Stile zu extrahieren und nachzuahmen.
5. Daten- und Modelltraining: Um diese Funktionen zu realisieren, benötigt DreamTalk große Datenmengen zum Training seiner Modelle, einschließlich Gesichtsanimationdaten mit verschiedenen Ausdrücken und Sprechstilen. Anhand dieser Daten lernt das Modell, wie es genau die zum Eingangsaudio passenden Gesichtsbewegungen erzeugen kann.
DreamTalk kann das leistungsstarke Diffusionsmodell nutzen, um effektiv ausdrucksstarke Gesichter zu erzeugen und die Abhängigkeit von teuren Stilreferenzen zu reduzieren. Die experimentellen Ergebnisse zeigen, dass DreamTalk realistische sprechende Gesichter mit unterschiedlichen Sprechstilen und präzise Lippenbewegungen erzeugen kann und damit die derzeit besten vergleichbaren Produkte übertrifft.
DreamTalk kann nicht nur die während des Trainings gesehenen Gesichtstypen und Ausdrücke verarbeiten und erzeugen, sondern auch effektiv Gesichtstypen und Ausdrücke verarbeiten und erzeugen, die es zuvor nicht gesehen hat und die aus verschiedenen Datensätzen stammen.
Darunter Porträts von Personen unterschiedlicher Ethnien, Altersgruppen und Geschlechter sowie eine Vielzahl unterschiedlicher Ausdrücke und Emotionen.














