
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
PIA: personalisierter Bild-Animator
PIA: personalisierter Bild-AnimatorEinführung
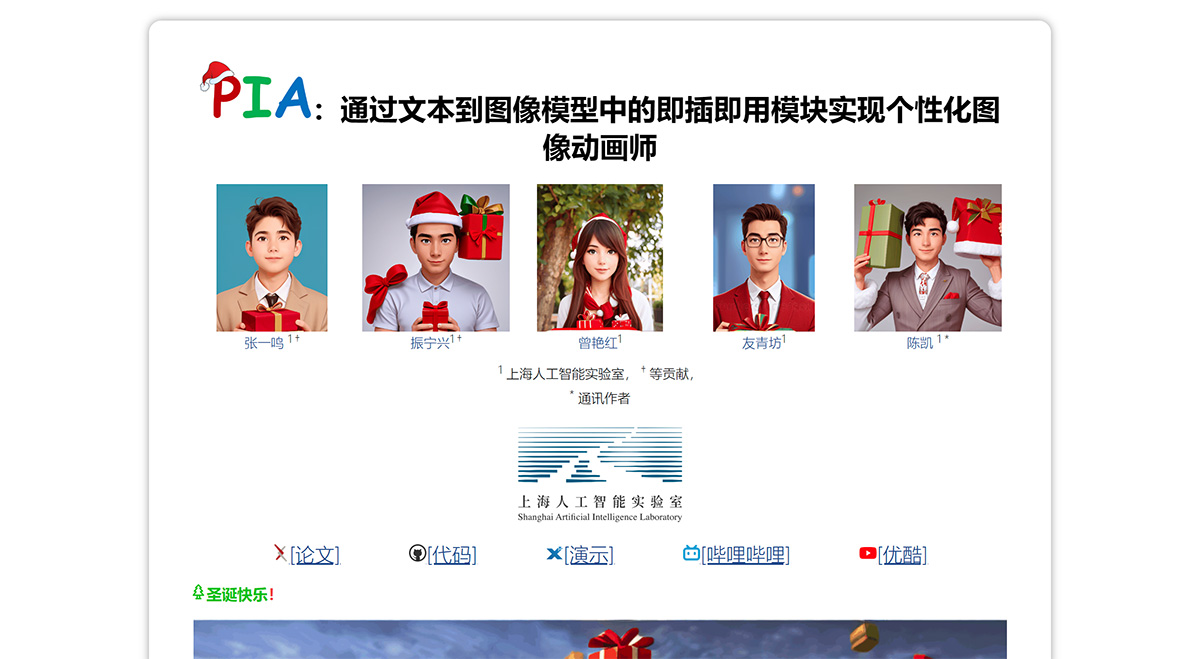
PIA ist eine personalisierte Bildanimationsmethode, die durch ein Plug-and-Play-Modul in Text-zu-Bild-Modellen einen personalisierten Bildanimator ermöglicht. Sie kann Videos mit hoher Bewegungssteuerbarkeit sowie starker Text- und Bildausrichtung erzeugen und ist mit verschiedenen personalisierten T2I-Modellen kompatibel, ohne dass spezielle Anpassungen erforderlich sind.
Der vorgeschlagene PIA animiert personalisierte Bilder entsprechend unterschiedlicher Textaufforderungen mit realistischen Bewegungen und bewahrt gleichzeitig den einzigartigen Stil sowie hochauflösende Details. Dadurch wird eine perfekte Balance zwischen Erscheinungsbild und Bewegung erreicht, erscheinungsbezogene Bildausrichtungsherausforderungen werden reduziert und der Fokus auf die bewegungsbezogene Ausrichtung der Steuerung gelegt.
PIA-Projektadresse: https://pi-animator.github.io/
Die jüngsten Fortschritte bei personalisierten Text-zu-Bild- (T2I) Modellen haben die Inhaltserstellung revolutioniert und ermöglichen es auch Laien, beeindruckende Bilder mit einzigartigen Stilen zu erzeugen. Obwohl vielversprechend, bringt das Hinzufügen realistischer Bewegungen zu diesen personalisierten Bildern per Text erhebliche Herausforderungen mit sich, nämlich den einzigartigen Stil und hochauflösende Details zu bewahren und gleichzeitig die Bewegung durch Text steuerbar zu machen.
In diesem Artikel stellen wir PIA vor, einen personalisierten Bildanimator, der sich durch bedingungsbasierte Bildausrichtung, Bewegungssteuerbarkeit per Text sowie Kompatibilität mit verschiedenen personalisierten T2I-Modellen ohne spezielle Anpassungen auszeichnet. Um diese Ziele zu erreichen, baut PIA auf einem Basist2I-Modell mit trainierten Zeitausrichtungsschichten auf, das die nahtlose Umwandlung jedes personalisierten T2I-Modells in ein Bildanimationsmodell ermöglicht.
Eine Schlüsselkomponente von PIA ist die Einführung eines Bedingungsmoduls, das Bedingungsframes und Frame-zu-Frame-Variationsbeziehungen nutzt, um unter Anleitung von Variationshinweisen Erscheinungsinformationen im latenten Raum für die Einzel-Frame-Synthese zu übertragen. Dieses Design reduziert die internen erscheinungsbezogenen Bildausrichtungsherausforderungen und ermöglicht eine stärkere Fokussierung auf die bewegungsbezogene Ausrichtung der Steuerung.
Implementierung von PIA:
Basist2I-Modell mit Zeitausrichtungsschichten: trainiert, um personalisierte T2I-Modelle in Bildanimationsmodelle umzuwandeln.
Bedingungsmodul: nutzt Bedingungsframes und Frame-zu-Frame-Variationsbeziehungen, um über Variationshinweise Erscheinungsinformationen im latenten Raum zu übertragen und die Frame-Synthese zu steuern.
Eigenschaften von PIA:
Plug-and-Play, ermöglicht Animation basierend auf Textaufforderungen.
Bewahrt den ursprünglichen Stil, hochauflösende Details bleiben unverfälscht.
PIA wurde vom Shanghai AI Laboratory beigetragen.














