
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

PixWeaver_云技派,专注ai人工智能!
PixWeaver_云技派,专注ai人工智能!Einführung
PixWeaver ist eine auf künstlicher Intelligenz basierende Plattform zur Bilderstellung. Sie ermöglicht es Nutzern, ohne das Erlernen komplexer Designsoftware durch Sprach- oder Textbeschreibungen das gewünschte Bild zu erzeugen.
Die Nutzer müssen nur einige wenige Sätze als Beschreibung eingeben, und das leistungsstarke KI-Modell von PixWeaver erstellt automatisch hochwertige Bilder. Die Nutzer können ihrer grenzenlosen Kreativität freien Lauf lassen und die vollständige Befreiung der Bildgestaltung erleben.
PixWeaver macht das Erstellen einfach und macht Spaß, die Einstiegshürde ist sehr niedrig. Die Nutzer müssen sich lediglich anmelden, um loszulegen. Die Nutzung erfolgt wie folgt:
1. Auf der Erstellungsseite können die Nutzer auf „Erstellen" oder in der Menüleiste auf die Option „KI-Malerei" klicken,
2. Im Bereich für die Bildbeschreibung die gewünschte Szene eingeben oder alternativ „Zufällige Beschreibung" auswählen, um diese zu erzeugen.
3. Im Bereich „Nicht benötigte Elemente" können die Nutzer Inhalte eingeben, die im Bild nicht erscheinen sollen.
4. Auf „Erstellen" klicken.
Die Generierungsgeschwindigkeit von PixWeaver ist sehr hoch, im Durchschnitt werden nur 3 Sekunden pro Bild benötigt, sodass die Nutzer nicht warten müssen. PixWeaver bietet zudem Funktionen zur Bildbearbeitung, Retusche und weitere Nachbearbeitungsfunktionen.
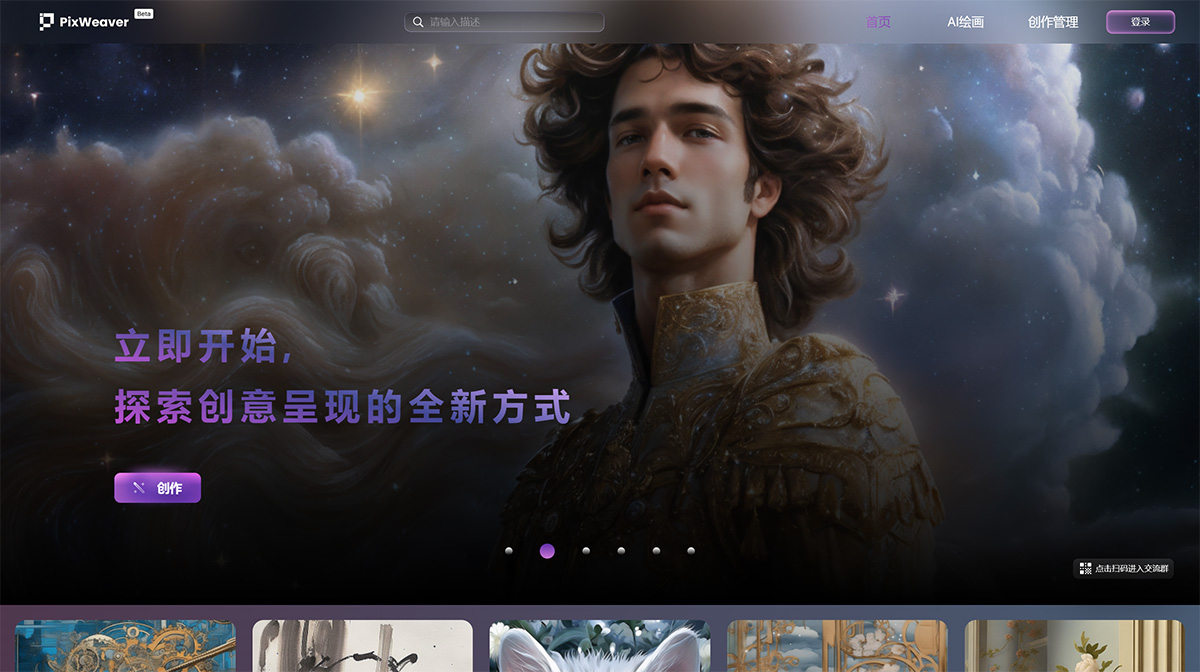
Produktfunktionen von PixWeaver:
Bilderzeugung durch Sprach- oder Textbeschreibung
Bereitstellung leistungsstarker KI-Kreativmodelle
Bildbearbeitungs- und Retuschefunktionen
Kreativverwaltungsfunktionen
PixWeaver von Shengshu Technology ist eine personalisierte Plattform für visuelles kreatives Design mit hochwertiger Text-zu-Bild-Funktion, vielfältigen Stilen, künstlerischem Niveau, erweiterter Kreativität und effizienter Erstellung. Shengshu Technology ist ein Entwickler von multimodalen Großmodellen für den industriellen Einsatz, der sich auf die Entwicklung multimodaler generativer Großmodelle und Anwendungslösungen konzentriert. Das Unternehmen hat das auf Transformer basierende multimodale Diffusionsgroßmodell Unidiffuser als Open Source veröffentlicht und mit der U-ViT-Transformer-Architektur erstmals bei einem Diffusionsmodell Multimodalität erreicht. Dadurch wird es möglich, mit einem einzigen zugrundeliegenden Modell hochwertige Aufgaben wie Text-zu-Bild, Bild-zu-Text, gemeinsame Bild- und Textgenerierung sowie Bild- und Textumformulierung durchzuführen.















