
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DeepSeek-V4 mit explosionsartiger Leistung: 1M Kontext und Huawei-Ascend-Support
小编 ·

DeepSeek-V4 mit explosionsartiger Leistung: 1M Kontext und Huawei-Ascend-Support
DeepSeek-V4 ist eine offiziell veröffentlichte und gleichzeitig als Open-Source bereitgestellte Familie großer Sprachmodelle, die am 24. April 2026 erschienen ist. Sie umfasst die beiden Versionen DeepSeek-V4-Pro und DeepSeek-V4-Flash. Die Reihe setzt auf einen Kontext von einer Million Tokens (1M) als Standard und erreicht in den Bereichen Agent-Fähigkeit, Weltwissen und Inferenzleistung ein führendes Niveau im Inland sowie im Open-Source-Bereich. Das Modell wurde bereits tiefgreifend auf die Huawei-Ascend-Chips angepasst.
🚀 Kern-Highlights
Kontext von einer Million Tokens als Standard: Beide Versionen unterstützen einen ultralangen Kontext von 1 Million Tokens, der in den offiziellen Diensten als Standardkonfiguration dient. Dies wird durch einen neuartigen Aufmerksamkeitsmechanismus (hybride Aufmerksamkeit CSA+HCA) ermöglicht, der den Bedarf an Rechenleistung und Videospeicher reduziert.
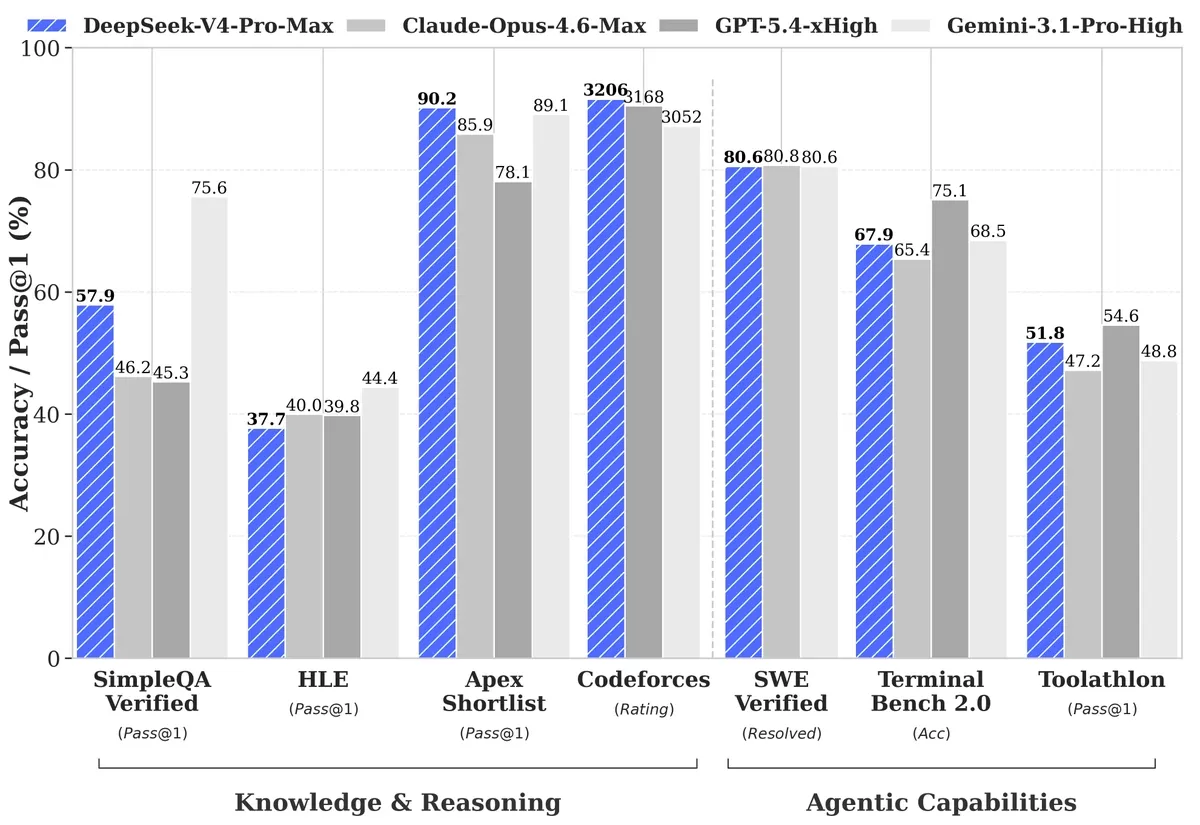
Hervorragende Inferenz- und Wissensleistung: DeepSeek-V4-Pro übertrifft in Bewertungen in Mathematik, MINT und wettbewerbsorientiertem Coding alle öffentlich bewerteten Open-Source-Modelle und liegt mit seiner Leistung nahe an den weltweit führenden Closed-Source-Modellen. Auch sein Weltwissen ist anderen Open-Source-Modellen deutlich voraus.
Verbesserte Agent-Fähigkeit: Die Agent-Fähigkeit von V4-Pro erreicht in Agentic-Coding-Bewertungen das beste Niveau unter den Open-Source-Modellen. Das Nutzungserlebnis ist besser als bei Sonnet 4.5, und die Lieferqualität liegt nahe am Nicht-Denk-Modus von Opus 4.6. Das Modell wurde zudem gezielt für gängige Agent-Produkte wie Claude Code und OpenClaw optimiert.
Angepasst an inländische Rechenleistung: DeepSeek-V4 läuft auf Huaweis neuesten Ascend-Chips. Die Ingenieure haben die Migration von der zugrunde liegenden Architektur von NVIDIA CUDA zu Huaweis CANN abgeschlossen. Auch Cambricon hat die Anpassung an die V4-Serie abgeschlossen.
🤔 Wie wählt man zwischen den beiden Versionen?
Die DeepSeek-V4-Serie bietet zwei Versionen für unterschiedliche Einsatzszenarien:
DeepSeek-V4-Pro - Expertenmodus
Positionierung: Strebt nach Höchstleistung und ist auf die führenden Closed-Source-Modelle ausgerichtet.
Merkmale: Umfangreicheres Weltwissen, stärkere Inferenzfähigkeit, geeignet für komplexes Reasoning, Codegenerierung und Agent-Aufgaben.
Parameter: Gesamtparameter 1,6T, aktive Parameter 49B.
DeepSeek-V4-Flash - Schnellmodus
Positionierung: Eine schnellere und wirtschaftlichere Wahl
Merkmale: Die Inferenzfähigkeit liegt nahe an der Pro-Version, mit kleineren Gesamt- und aktiven Parametern, günstigerem API-Preis und schnellerer Antwortzeit. Bei einfachen Agent-Aufgaben ist die Leistung vergleichbar mit Pro.
Parameter: Gesamtparameter 284B, aktive Parameter 13B.
💻 Wie erhält man Zugang und wie nutzt man es?
Open-Source-Gewichte: Bereits auf den Plattformen Hugging Face und ModelScope synchron als Open Source veröffentlicht.
API-Aufruf: Der API-Dienst wird synchron aktualisiert. Entwickler müssen lediglich den model-Parameter auf deepseek-v4-pro oder deepseek-v4-flash ändern, um die API aufzurufen.
Direkte Nutzung: Auf der DeepSeek-Website oder in der offiziellen App anmelden, um direkt zu chatten.
API-Preise
Die folgenden Preise gelten pro einer Million Tokens:
| Modellversion | Eingabe (Cache-Treffer)¥/MTok | Eingabe (Cache-Fehlschlag)¥/MTok | Ausgabe¥/MTok |
|---|---|---|---|
| DeepSeek-V4-Flash | 0,2 Yuan | 1 Yuan | 2 Yuan |
| DeepSeek-V4-Pro | 1 Yuan | 12 Yuan | 24 Yuan |









