
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Qwen-Image: Open-Source-Modell zur Bild- und Poster-Generierung von Alibaba Tongyi
小编 ·

Qwen-Image: Open-Source-Modell zur Bild- und Poster-Generierung von Alibaba Tongyi
Qwen-Image ist ein am 5. August 2025 vom Alibaba Tongyi Qianwen-Team als Open-Source veröffentlichtes Bildgenerierungs-Basismodell mit einer Parametergröße von 20 Milliarden und MMDiT-Architektur. Es zeichnet sich durch komplexes Text-Rendering und präzise Bildbearbeitung aus, ist besonders gut in der Generierung großer Mengen präzisen chinesischen Texts, unterstützt auch chinesische Prompts und liegt in chinesischen Spezialtests wie LongText-Bench und ChineseWord weit vorne.
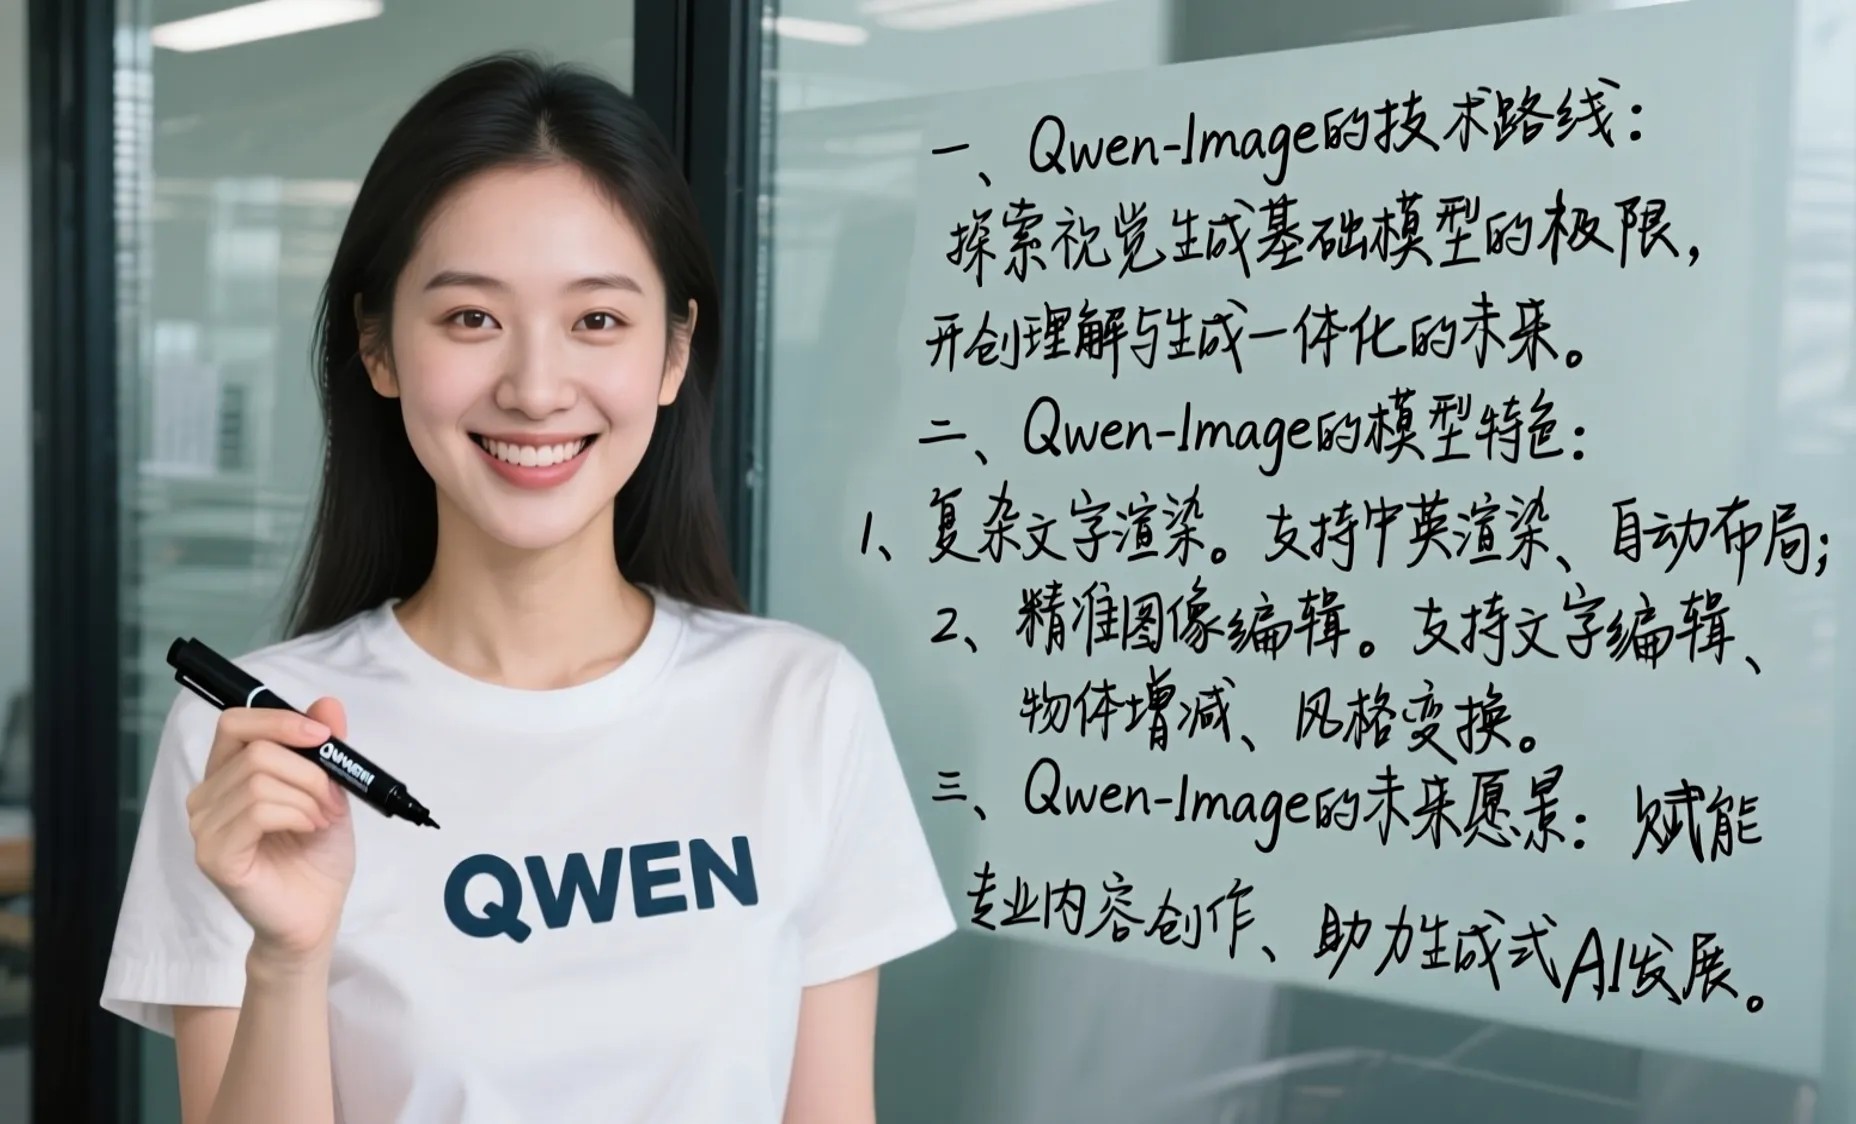
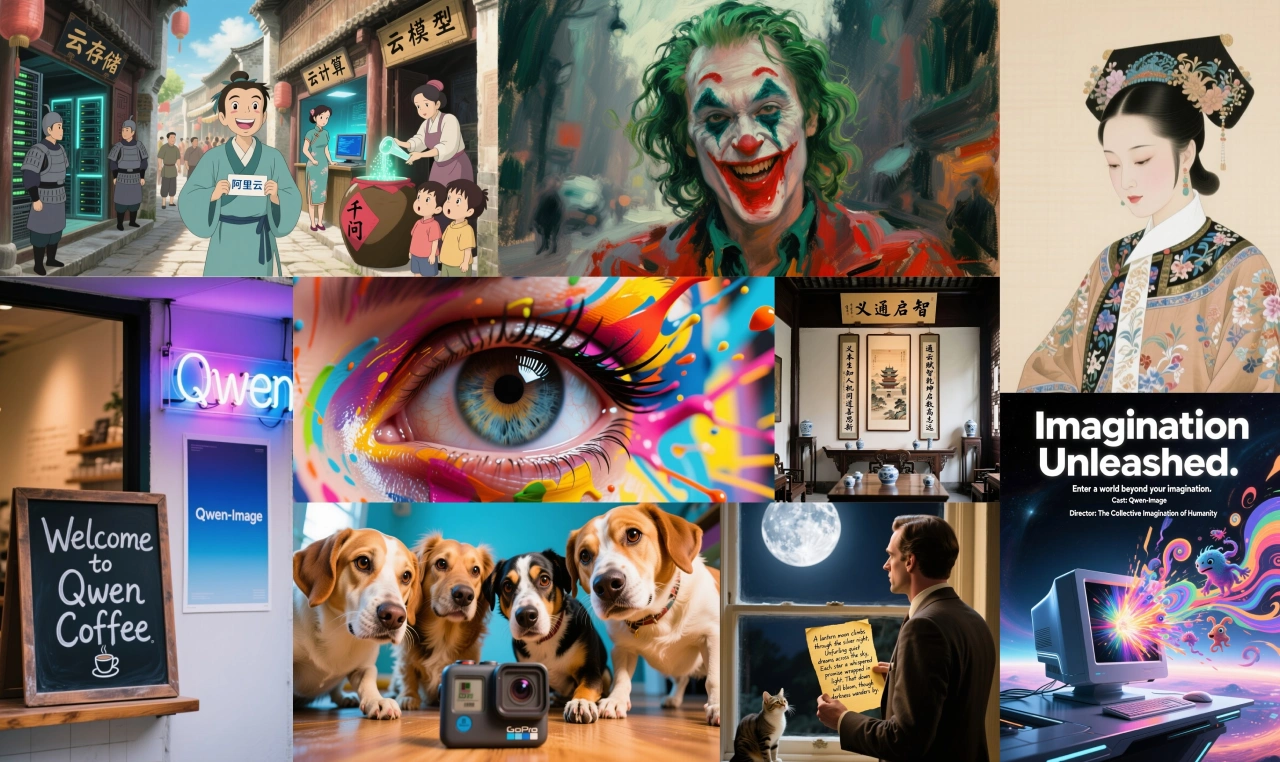
Dieses Modell unterstützt Chinesisch und Englisch, kann verschiedene Schriftarten, sehr lange Absätze und komplexe Bild-Text-Layouts verarbeiten, kann Bilder für verschiedene Szenarien wie Poster und PPT erzeugen und ermöglicht auch Bildbearbeitung wie Stiltransfer, Hinzufügen/Entfernen von Objekten und Anpassen von Posen. Es kann in vielen Branchen wie Werbedesign, Filmproduktion, Spieleentwicklung und Bildung eingesetzt werden. Benutzer können in QwenChat (chat.qwen.ai) die Bildgenerierungsfunktion auswählen, um es auszuprobieren. Es können Poster, PPT-Seiten, Produktwerbebilder usw. erstellt sowie verschiedene Bildbearbeitungen durchgeführt werden, was Designern ein leistungsstarkes Werkzeug bietet.
Hauptmerkmale
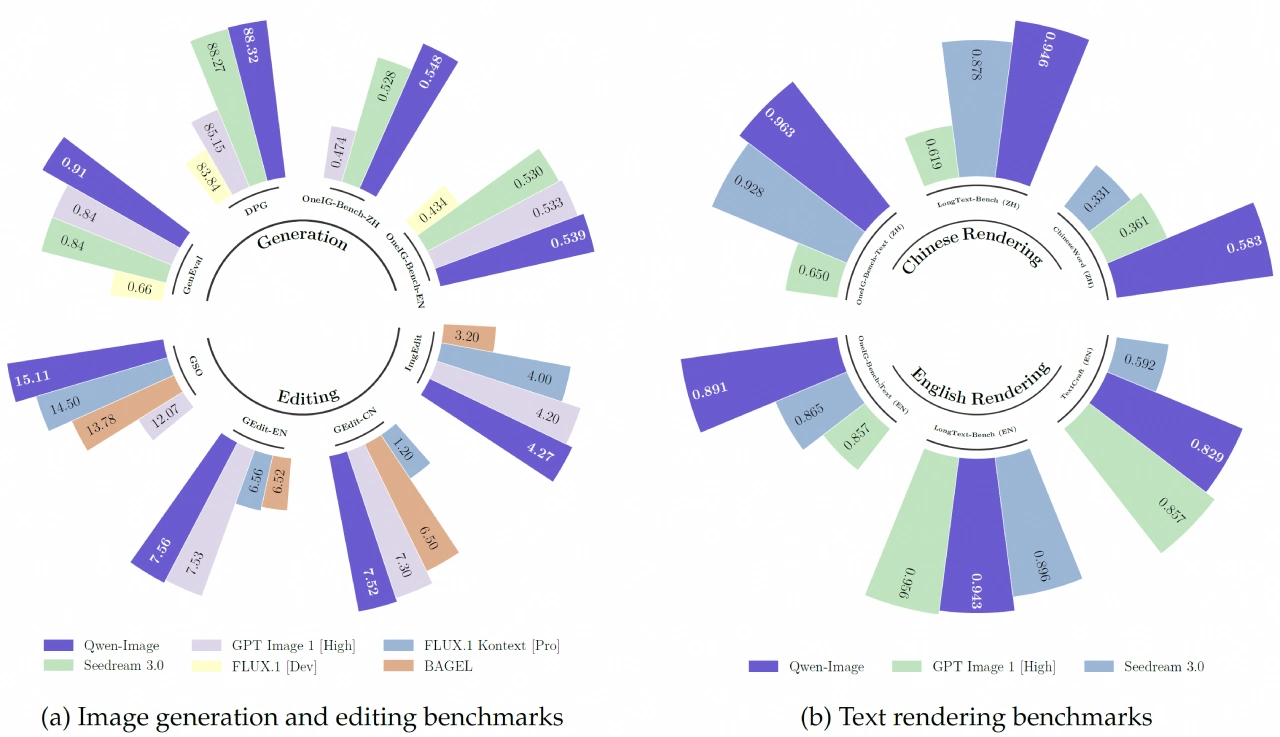
Starke Text-Rendering-Fähigkeit: Unterstützt mehrzeilige Layouts, absatzweise Textgenerierung und Detaildarstellung, Chinesisch und Englisch können hochauflösend ausgegeben werden. In Tests wie LongText-Bench, ChineseWord und TextCraft schneidet es sehr gut ab, das chinesische Text-Rendering ist deutlich besser als bei bestehenden fortschrittlichen Modellen. Es kann Texte in verschiedenen Sprachen und Stilen erzeugen, kalligrafisch schreiben oder direkt PPT-Seiten mit Text und Bildern generieren.
Gute Konsistenz bei der Bildbearbeitung: Durch verstärktes Multi-Task-Training bleibt die Bearbeitung visuell und semantisch kohärent und unterstützt Stiltransfer, Hinzufügen/Löschen/Ändern, Detailverbesserung, Textbearbeitung, Anpassung von Personenposen usw.
Gute Performance über verschiedene Benchmarks hinweg: In mehreren öffentlichen Tests wie GenEval, DPG und OneIG-Bench für allgemeine Bildgenerierung sowie GEdit, ImgEdit und GSO für Bildbearbeitung erzielt es Spitzenleistungen.
Kernkomponenten
Qwen2.5-VL multimodales großes Sprachmodell: Dient als Bedingungs-Encoder, extrahiert Merkmale aus Text, beschreibt anhand von System-Prompts detailliert Farbe, Menge, Text usw. von Objekten und Hintergründen und liefert die Grundlage für die Bildgenerierung, sodass die erzeugten Inhalte feiner werden.
Variational Autoencoder (VAE) des Wan-2.1 Video-Generierungsmodells: Fungiert als Bild-Tokenizer, komprimiert eingegebene Bilder in kompakte latente Darstellungen und dekodiert sie bei der Inferenz wieder. Das Team hat den Encoder eingefroren und nur den Decoder feinjustiert, damit Bilddetails besser hervortreten.
Multimodal Diffusion Transformer (MMDiT): Als Backbone-Diffusionsmodell verarbeitet es unter Textführung die Beziehung zwischen Rauschen und Bildlatenten, integriert eine multimodale skalierbare RoPE-Methode, die hilft, Bild- und Textinformationen zu unterscheiden, sodass sowohl hochauflösende Bilder als auch präziser Text erzeugt werden können.
Qwen-Image Technische Architektur
MMDiT-Architektur: Verwendet einen multimodalen Diffusion Transformer, um eine tiefe Integration von Text und Bild zu erreichen.
VAE mit einem Encoder und zwei Decodern: Komprimiert Bilder in kompakte latente Darstellungen und dekodiert sie nach der Generierung wieder in Pixel. Durch Anpassung des Gleichgewichts zwischen Rekonstruktions- und Wahrnehmungsverlust können Bilddetails realistisch wiederhergestellt werden.
Multimodale skalierbare Rotary-Positions-Encodierung (MSRoPE): Codiert Textinformationen auf der „Diagonale" des Bildrasters, wodurch die Textunabhängigkeit erhalten bleibt und gleichzeitig die Vorteile der Skalierung der Bildauflösung genutzt werden.
Trainingsstrategie
Mehrstufiges, progressives Pre-Training: Von niedriger zu hoher Auflösung, von allgemeinen zu spezialisierten Inhalten, von riesigen Datenmengen zu kuratierten Daten schrittweise trainiert.
Überwachtes Feintuning (SFT) und Reinforcement Learning (RL) in der späteren Trainingsphase: Feintuning mit von Menschen handverlesenen hochwertigen Daten und zusätzlich Techniken wie DPO, damit das Modell menschliche Präferenzen erlernt.
Anwendungsszenarien
Werbedesign: Erzeugt schnell hochwertige Bilder passend zum Markenstil, unterstützt Stilwechsel und Detailoptimierung, hilft Designern, schnell verschiedene Effekte auszuprobieren und Kundenanforderungen zu erfüllen.
Filmproduktion: Für frühe Konzeptbilder, Szenenvoreinstellungen und Charakterdesign, verkürzt die Produktionszyklen und senkt die Kosten.
E-Commerce-Visualisierung: Händler können schnell Produktpräsentationsbilder, virtuelle Anprobebilder und Marketingmaterialien erzeugen, um das Nutzererlebnis und die Kaufquote zu steigern.
Postererstellung: Erzeugt wirkungsvolle, künstlerische Poster (z. B. Film- und Veranstaltungsplakate) entsprechend Text- und Designanforderungen, anpassbar an verschiedene Stile und Themen.
PPT-Erstellung: Erzeugt Business-Level-PPT-Seiten mit Sternenhimmel-Blau als Hauptfarbe, kombiniert mit fließenden Tech-Linien und subtilen Partikeleffekten, professionell und modern, unterstützt verschiedene Stile und Layouts.
Leistung
Allgemeine Bildgenerierung: Hervorragende Leistung in Tests wie GenEval, DPG und OneIG-Bench.
Bildbearbeitung: Spitzenleistung in professionellen Tests wie GEdit, ImgEdit und GSO.
Text-Rendering: Herausragende Fähigkeiten in Tests wie LongText-Bench, ChineseWord und TextCraft, das chinesische Text-Rendering übertrifft bestehende Spitzenmodelle bei Weitem.
Vorteile von Qwen-Image
Besserer Chinesisch-Support: Chinesisch speziell optimiert, Rendering-Effekt viel besser als bei DALL-E.
Vollständig kostenlos: Keine kostenpflichtige Abonnement erforderlich, kann auch lokal eingesetzt werden.
Open Source und transparent: Code öffentlich, kann nach Belieben angepasst werden.
Stärkere Bearbeitungsfunktionen: Unterstützt vielfältigere Bildbearbeitungsoperationen.
Keine Nutzungsbeschränkungen: Nicht durch API-Aufrufkontingente eingeschränkt.
Verwendung von Qwen-Image
Umgebungsvorbereitung: Installieren Sie die neueste Version von diffusers.
Basiscode:
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB Grafikspeicher) erforderlich. Der CPU-Modus ist langsamer bei der Generierung, kann aber ebenfalls verwendet werden.
✅Qwen-Image offizielle Vorstellung: https://qwenlm.github.io/zh/blog/qwen-image/
✅Qwen-Image Modell: https://huggingface.co/Qwen/Qwen-Image
✅Online nutzen: https://chat.qwen.ai/ (Bildgenerierung unterhalb des Eingabefelds auswählen)









