
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
MOSS-TTSD: Open-Source-Sprachsynthesemodell für zweisprachige Dialoge
小编 ·

MOSS-TTSD: Open-Source-Sprachsynthesemodell für zweisprachige Dialoge
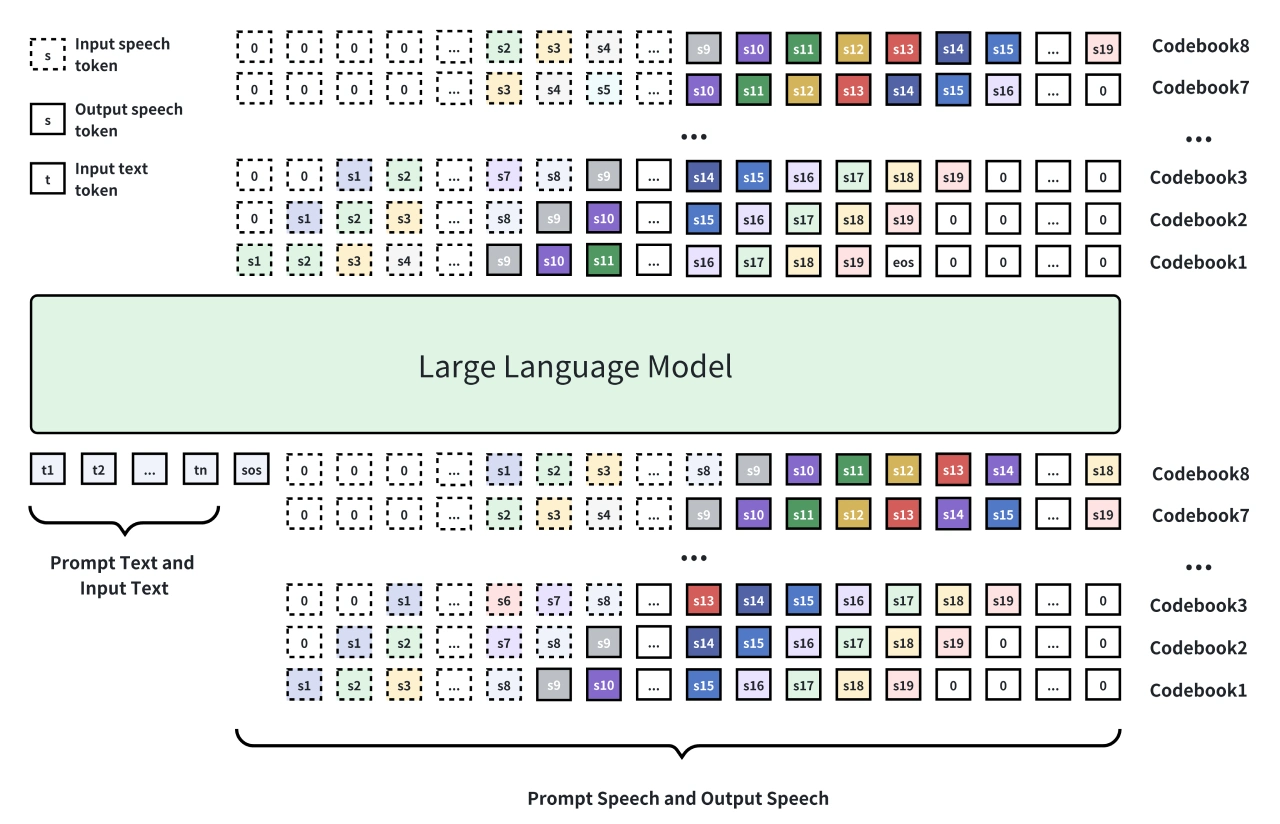
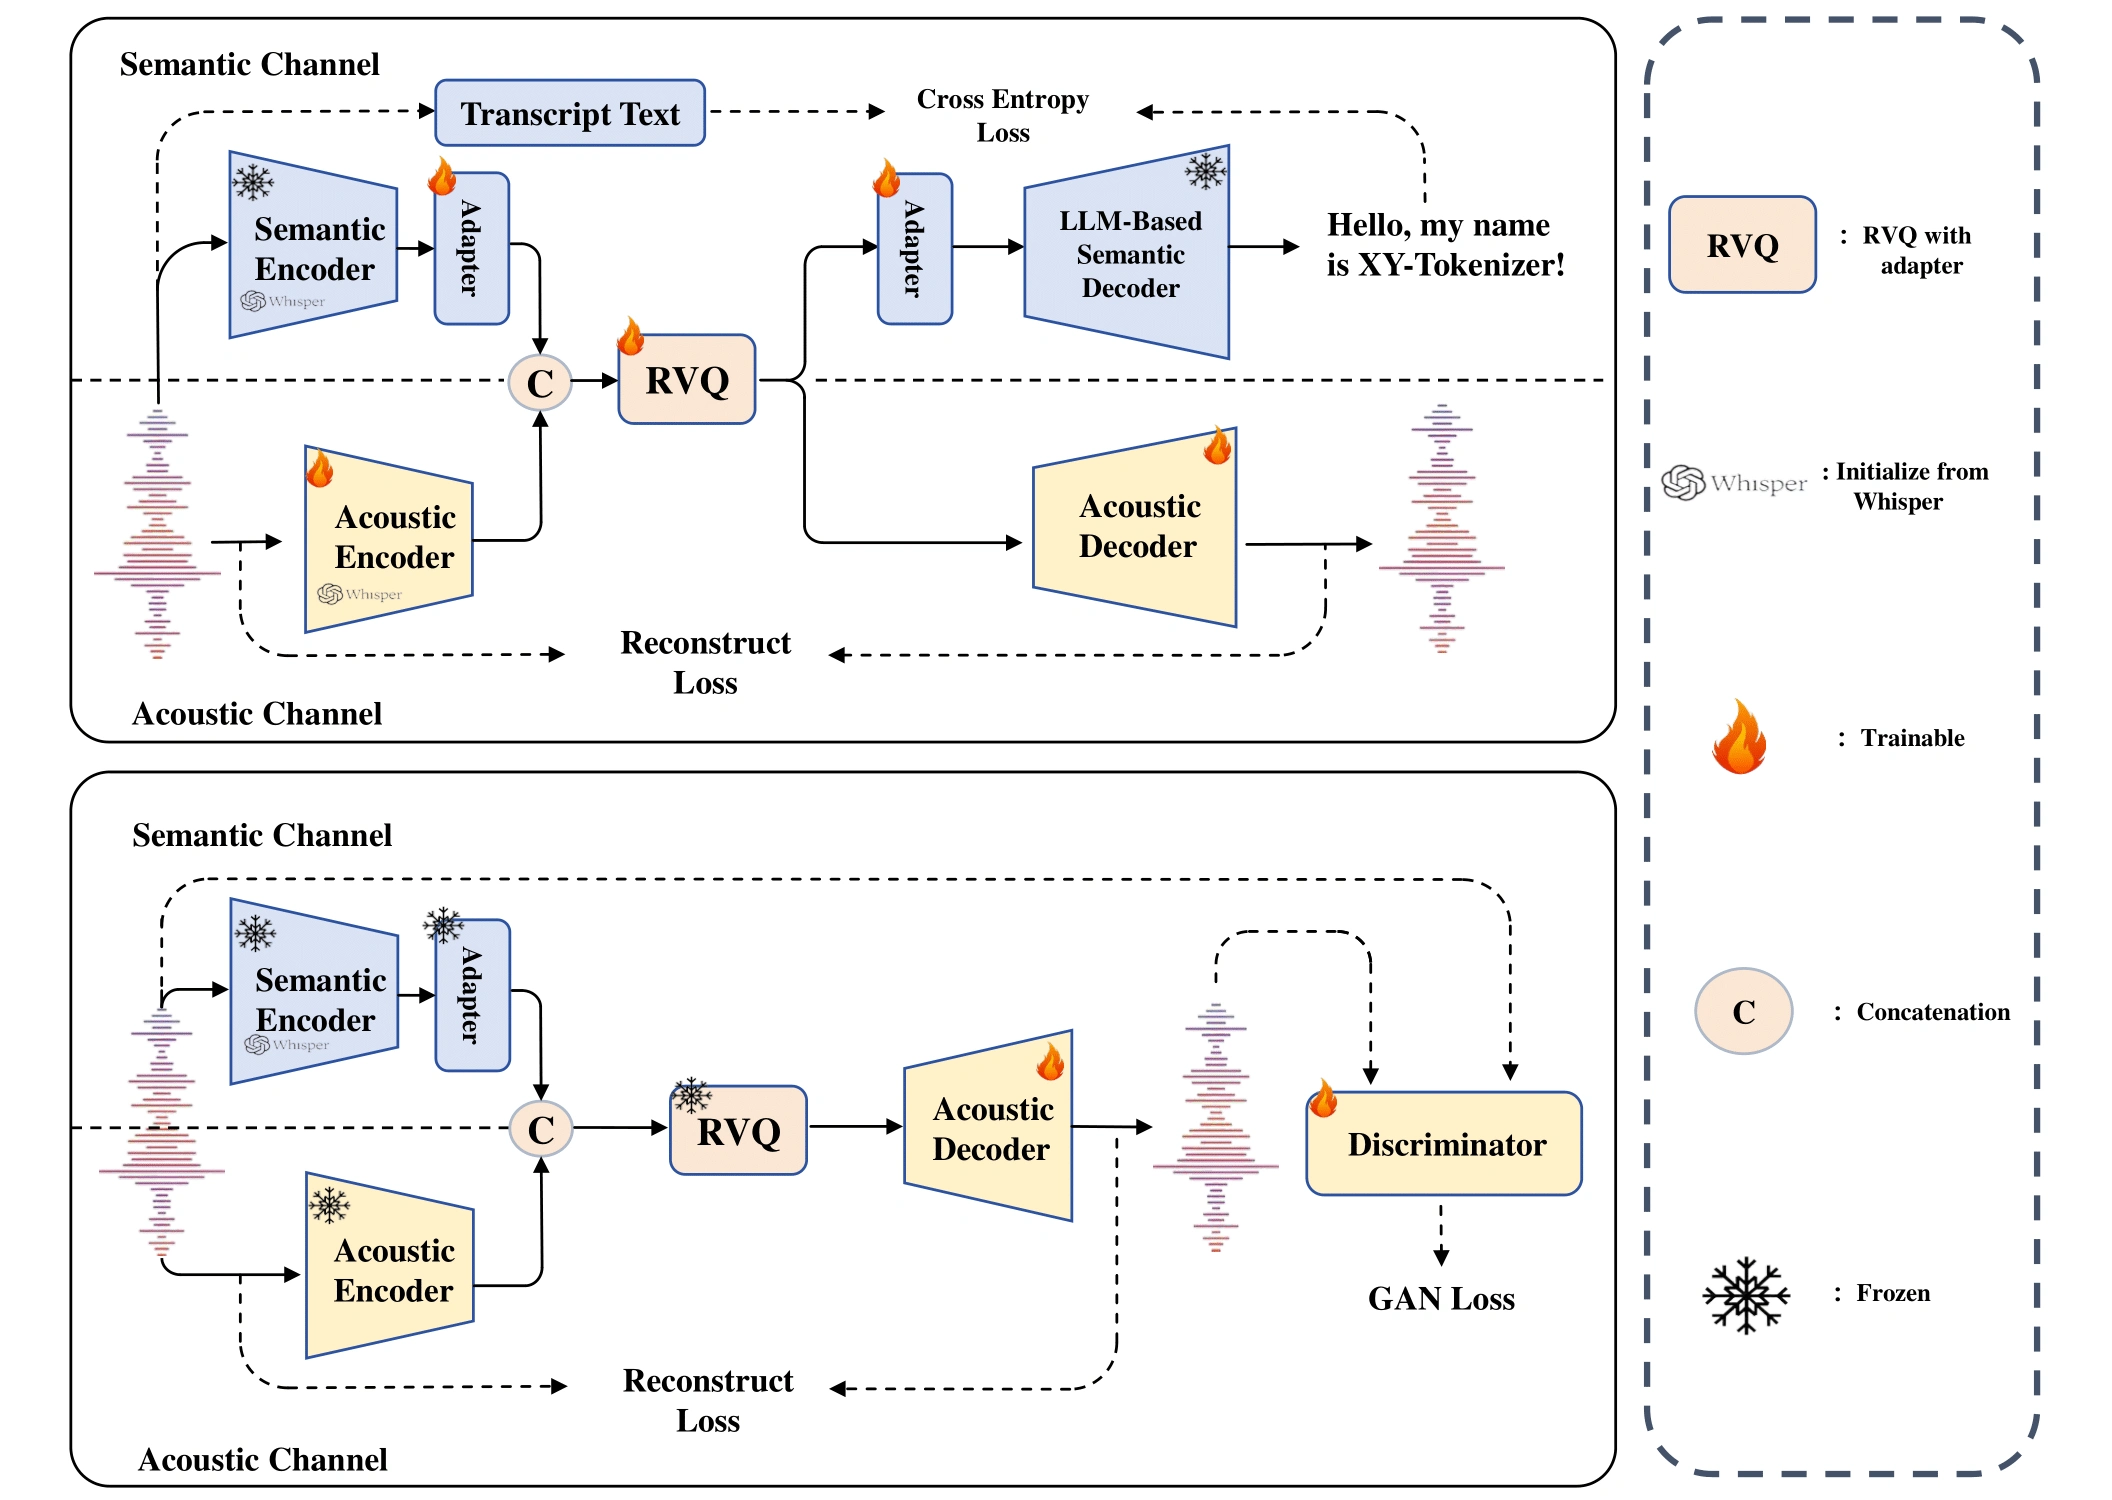
MOSS-TTSD ist ein von der Speech and Language Laboratory der Tsinghua-Universität in Zusammenarbeit mit dem Tencent-AI-Lab und weiteren Institutionen entwickeltes Open-Source-Modell zur zweisprachigen Dialog-Sprachsynthese. Es unterstützt Chinesisch und Englisch und kann Dialogskripte zweier Sprecher in natürliche, ausdrucksstarke Dialogstimmen umwandeln. Das Modell basiert auf dem Qwen3-1.7B-Basismodell, das mittels diskreter Sprachsequenzmodellierung weiter trainiert wurde. Über den XY-Tokenizer wird Sprache auf 1 kbps komprimiert, wobei semantische und akustische Informationen erhalten bleiben.
Das MOSS-TTSD-Modell unterstützt Chinesisch und Englisch, kann die Stimmen mehrerer Sprecher Zero-Shot klonen und Stimmen mit einer Länge von bis zu 960 Sekunden erzeugen. Es eignet sich für Szenarien wie KI-Podcasts, Synchronisation von Film und Fernsehen sowie ausführliche Interviews. Die Modellgewichte, der Inferenzcode und die API-Schnittstellen sind vollständig Open Source und unterstützen eine kostenlose kommerzielle Nutzung.
Hauptmerkmale
✅ Hochausdrucksstarke Dialogstimme: Dank eines einheitlichen semantisch-akustischen Neural-Audio-Codecs, eines vortrainierten großen Sprachmodells sowie Millionen Stunden an TTS-Daten und 400.000 Stunden an synthetischen und realen Dialogstimmen werden menschenähnliche Dialogstimmen mit natürlicher Dialogprosodie und starker Ausdruckskraft erzeugt.
✅ Stimmklonung mit zwei Sprechern: Unterstützt Zero-Shot-Stimmklonung für zwei Sprecher und kann Sprecher anhand von Dialogskripten präzise wechseln, um Dialogstimmen zu erzeugen.
✅ Zweisprachige Unterstützung für Chinesisch und Englisch: Erzeugt ausdrucksstarke Stimmen in Chinesisch und Englisch.
✅ Erzeugung langer Sprachausgaben: Dank eines Codecs mit niedriger Bitrate und einer optimierten Trainingsarchitektur speziell auf die Erzeugung langer Sprachausgaben ausgelegt.
✅ Vollständig Open Source und kommerziell nutzbar: MOSS-TTSD und alle zukünftigen Aktualisierungen sind vollständig Open Source und unterstützen eine kostenlose kommerzielle Nutzung.
Technische Grundlagen von MOSS-TTSD
✅ Modellarchitektur: Feinabstimmung auf Basis des Qwen3-1.7B-Basismodells mit diskreter Sprachmodellierung. Mittels 8-stufiger RVQ (Residual Vector Quantization) werden Sprachsignale in diskrete Token-Sequenzen umgewandelt, autoregressiv in Kombination mit Delay Pattern erzeugt und schließlich durch einen Decoder wieder in Sprache zurückverwandelt.
✅ Kerninnovation: Der XY-Tokenizer verfügt über einen zweistufigen Multitask-Lernprozess. In der ersten Stufe werden gleichzeitig Aufgaben zur automatischen Spracherkennung (ASR) und zur Sprachrekonstruktion trainiert, wobei semantische und grobkörnige akustische Informationen verschmolzen werden. In der zweiten Stufe werden Encoder und Quantizer fixiert und nur der Decoder trainiert, wobei Rekonstruktions- und GAN-Loss hinzugefügt werden, um die Detailtreue zu erhöhen.
✅ Datenumfang und Vortraining: Trainiert mit ca. 1 Million Stunden Einkreisprecherdaten und 400.000 Stunden Dialogsprachdaten. Die Daten wurden streng gefiltert und annotiert und einem zweisprachigen TTS-Vortraining unterzogen.
Anwendungsszenarien
✅ KI-Podcast-Produktion: MOSS-TTSD wandelt Texte automatisch in Podcast-Audio mit mehreren Sprechern um, unterstützt Zero-Shot-Stimmklonung und die Erzeugung langer Sprachausgaben und senkt so die Produktionskosten.
✅ Synchronisation von Film/Fernsehen und Animation: Erzeugt natürliche Dialogstimmen für Film-, Fernseh- und Animationsproduktionen, unterstützt mehrsprachige Wechsel und steigert die Effizienz der Synchronisation.
✅ Ausführliche Interviews und Besprechungsprotokolle: Wandelt Interview- oder Besprechungstexte in Sprache um, bewahrt Prosodie und Emotionen des Dialogs und erleichtert Archivierung und Weitergabe.
Vorteile und Besonderheiten
✅ Open Source und kommerzielle Nutzung: Die Modellgewichte, der Inferenzcode und die API-Schnittstellen von MOSS-TTSD sind Open Source und können kostenlos kommerziell genutzt werden.
✅ Natürlichkeit und Ausdruckskraft: Natürlichkeit und Ausdruckskraft der Stimme erreichen ein branchenführendes Niveau.
✅ Unterstützung von Soundeffekten: Ermöglicht nicht-sprachliche Geräusche wie Lachen, um die Ausdruckskraft der Stimme zu erhöhen.
Open-Source-Adresse: https://github.com/OpenMOSS/MOSS-TTSD
Offizielle MOSS-TTSD-Webseite: https://www.open-moss.com/cn/









