
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ThinkSound: multimodales KI-Audio-Tool aus Alibabas Tongyi Lab
小编 ·

ThinkSound: multimodales KI-Audio-Tool aus Alibabas Tongyi Lab
ThinkSound ist ein multimodales KI-Tool des Tongyi-Labors von Alibaba, das aus Video-, Text- oder Audioeingaben hochwertige Soundeffekte und Szenenklänge erzeugen kann.
Kernfunktionen
✅ Video-zu-Audio: Wandelt beliebige Videos in reichhaltige, zum Bild passende Soundeffekte um. Durch die bildweise Analyse von Bildelementen, Bewegungsabläufen und Umgebungshintergrund werden umgebungssynchrone Hintergrundgeräusche und Raumklang erzeugt.
✅ Intelligente Sprachsynthese: Erzeugt auf Grundlage des Videoinhalts natürliche Dialoge und Erzählungen. Die KI erkennt Gesichtsausdrücke, Lippenbewegungen und den emotionalen Kontext und gibt eine Sprache aus, die lippensynchron, natürlich betont und emotional authentisch ist.
✅ Multimodales Soundeffekt-Design: Kombiniert Videos mit Textanweisungen, Referenzsounds und Stilvorhängen, um Soundeffekte präzise zu steuern und eine natürliche Verschmelzung mit dem Bild sicherzustellen – geeignet für professionelle Produktionen in Film, Gaming und mehr.
✅ Interaktive Audio-Bearbeitung: Nutzer können auf Zielobjekte im Video klicken oder direkt natürlichsprachliche Anweisungen eingeben, um bestimmte Klänge feinjustieren.
Technische Grundlagen
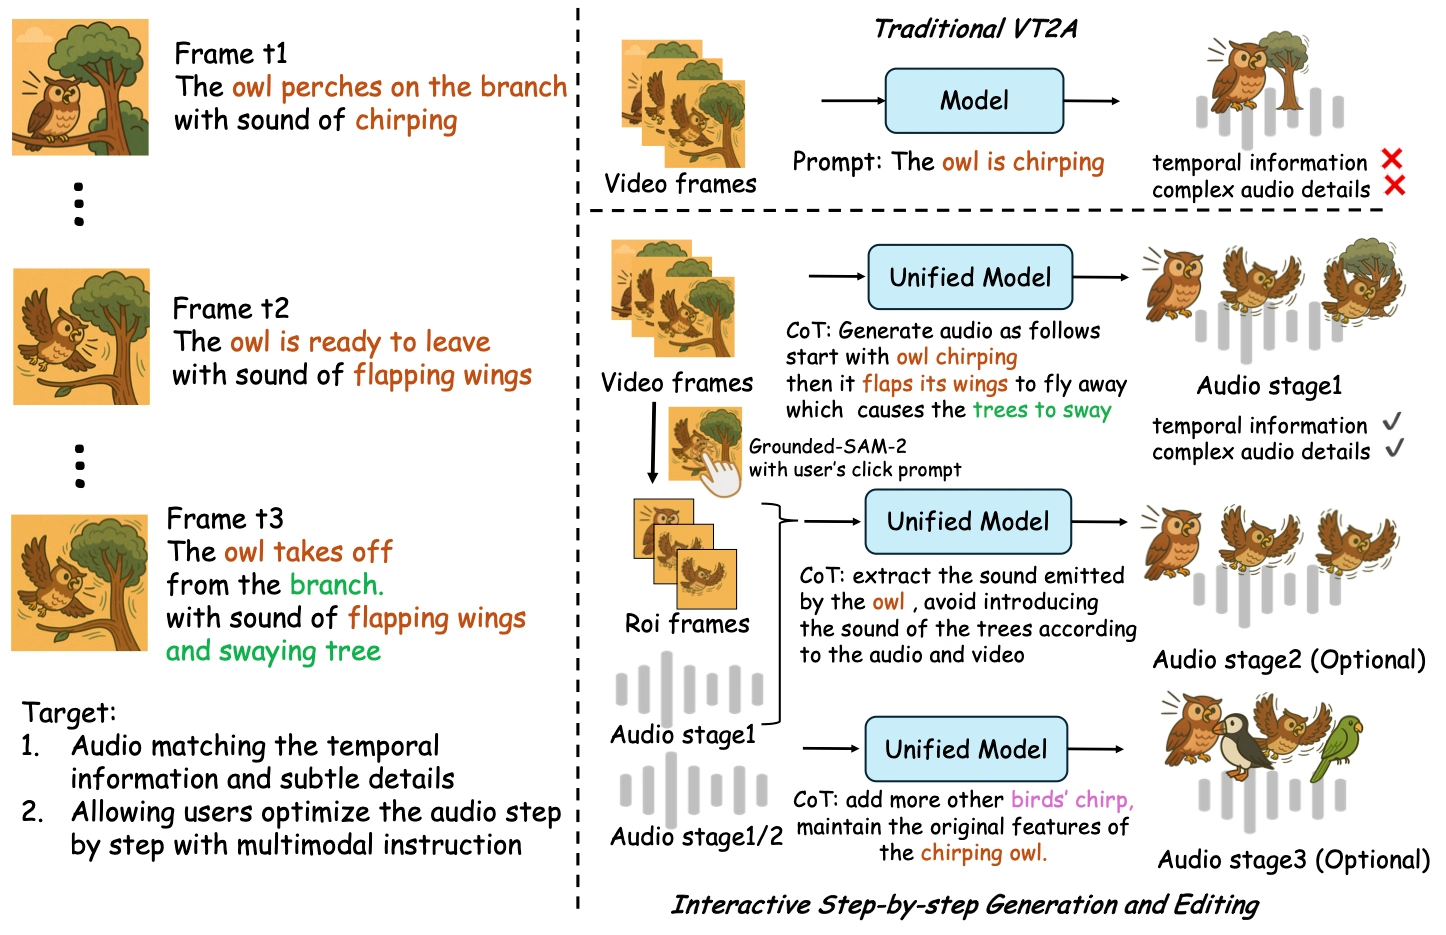
Dreistufiger interaktiver Rahmen:
✅ Grundlegende Soundeffekt-Generierung: Das System analysiert zunächst das gesamte Video, erkennt durch logisches Schlussfolgern Klangereignisse, Umgebungselemente, akustische Eigenschaften und zeitliche Zusammenhänge und erzeugt eine erste kohärente Hintergrundgeräuschkulisse.
✅ Objekt-Optimierung: Nachdem der Nutzer auf ein Zielobjekt klickt, extrahiert das System mithilfe von Lokalisierungstechnik den Bereich und verfolgt die Objektbewegung, um gezielt die Soundeffekt-Logik dieses Objekts zu erzeugen, Audiodetails zu optimieren und gleichzeitig die Abstimmung mit dem gesamten Audiotrack zu wahren.
✅ Anweisungsbasierte Bearbeitung: Gibt der Nutzer natürlichsprachliche Anweisungen ein (z. B. „Vogelgesang hinzufügen“, „Autogeräusche entfernen“), wandelt das System diese in präzise Audiooperationen um und passt sie unter Berücksichtigung von Bild und aktuellem Klangzustand an.
✅ Multimodales Großmodell (MLLM): Die Kernfähigkeit besteht darin, Videobilder, Textbeschreibungen und Klangkontext synchron zu verstehen, die Informationen zu fusionieren und schrittweise natürliche, realistische Soundeffekte zu erzeugen.
Vorteile und Merkmale
✅ Hohe Soundeffekt-Realitätsnähe, herausragende Leistung in Video-Audio-Generierungstests mit starker Szenenpassung.
✅ Unterstützt die Erstellung kreativer Effekte durch ausführliche Prompts und gewährleistet gleichzeitig eine natürliche Bild-Ton-Synchronisation.
✅ Kompatibel mit gängigen Videoformaten (MP4/MOV/AVI/MKV), unterstützt Auflösungen von SD bis 4K sowie verschiedene Bildraten.
✅ Speziell für professionelle Szenarien konzipiert (Film, Werbung, Gaming usw.); alle Versionen beinhalten eine kommerzielle Nutzungslizenz.
Anwendungsszenarien
✅ Film-Nachbearbeitung: Erzeugt schnell Umgebungsgeräusche, Dialoge oder Musik für stummes Material und steigert so die Produktionseffizienz.
✅ Gaming-Sounddesign: Erstellt dynamische Umgebungsgeräusche und erhöht die Immersion virtueller Szenen.
✅ Interaktive Medien und Bildung: Ermöglicht mehrsprachige Dialoge durch Sprachsynthese, kombiniert mit präziser Lippensynchronisation und emotionalem Ausdruck, um virtuelle Charaktere lebendiger zu machen.
Projekt-Links
✅ Github:https://github.com/FunAudioLLM/ThinkSound
✅ Offizielle Webseite:https://thinksound-demo.github.io/
✅ HuggingFace:https://huggingface.co/spaces/FunAudioLLM/ThinkSound









