
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
MultiTalk: Meituans Open-Source-Tool zur audio-gesteuerten Generierung von Mehrpersonen-Gesprächsvideos
小编 ·

MultiTalk: Meituans Open-Source-Tool zur audio-gesteuerten Generierung von Mehrpersonen-Gesprächsvideos
MultiTalk ist ein von Meituans Vision-Intelligence-Team als Open Source veröffentlichtes Tool zur Erzeugung von Audio-gesteuerten Mehrpersonen-Dialog-Videos. Es kann auf Basis von Mehrpersonen-Audio, Referenzbildern und Textaufforderungen lippensynchrone und natürlich wirkende Dialog-Videos mit digitalen Menschen erzeugen – mit hervorragender Qualität. Die Nutzer laden lediglich Audio, Referenzbilder und Prompts hoch und erhalten daraufhin Dialogvideos mit passender Mundbewegung; zudem lassen sich Gesangsszenen und Cartoong Figuren erzeugen.
Dieses Projekt bietet zahlreiche praktische Funktionen: Die Audio-gesteuerte Lippensynchronisation ist äußerst präzise, mit Prompts lassen sich die Aktionen virtueller Figuren steuern, Videos in unterschiedlichen Auflösungen können ausgegeben werden, und es können bis zu 15 Sekunden lange Dialogszenen erzeugt werden. Darüber hinaus verfügt es über eine integrierte Text-to-Speech-Funktion, wurde durch mehrere Optimierungen hinsichtlich der Generierungseffizienz verbessert, unterstützt einen Low-VRAM-Modus sowie Multi-GPU-Inferenz und läuft bereits auf einer einzelnen RTX 4090 Grafikkarte.
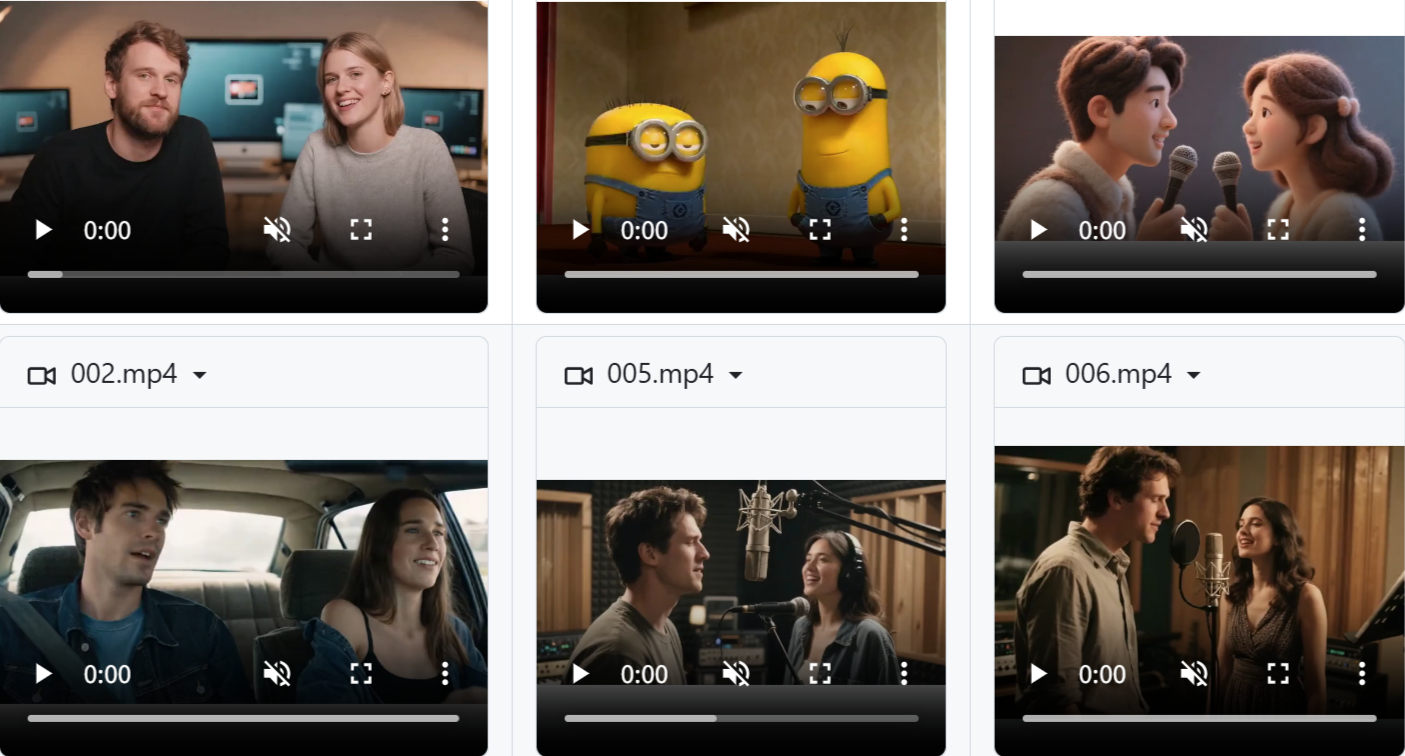
Funktionsmerkmale
✅ Audio-gesteuert: Durch die Eingabe von Mehrpersonen-Audio werden natürliche Lippensynchronisation und Körperbewegungen erzeugt
✅ Eingabe eines einzigen Fotos: Mit nur einem Referenzbild lassen sich Interaktionsvideos mit mehreren Personen erzeugen
✅ Befolgung komplexer Aktionen: Unterstützt komplexe Textaufforderungen und erzeugt Aktionen sowie Szenen gemäß der Beschreibung
✅ Mehrsprachige Unterstützung: Verarbeitet mehrsprachiges Audio und erzielt eine präzise Lippensynchronisation
✅ Lange Videoerzeugung: Erzeugt mithilfe autoregressiver Methoden zusammenhängende lange Videos
✅ Effiziente Trainingsstrategien: Durch zweistufiges Training, Teilparametertraining und Multitask-Training wird die Leistung des Modells gesteigert
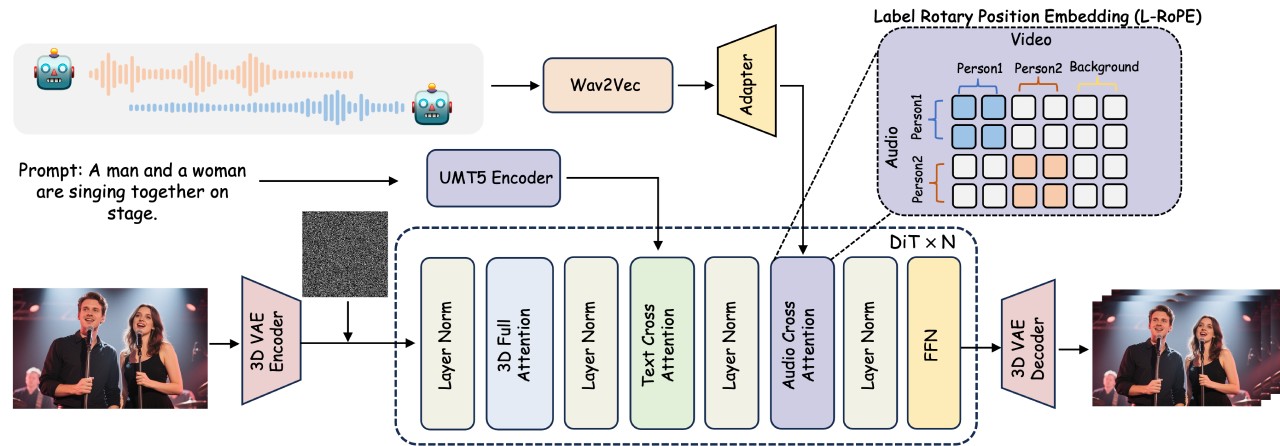
✅ L-RoPE-Technik: Durch Label Rotary Position Embedding wird eine präzise Zuordnung mehrerer Audioströme zu den jeweiligen Personen erreicht
✅ Hochwertige Ausgabe: Die erzeugten Videos wirken natürlich und flüssig und zeigen visuell nahezu keine Artefakte
Technische Highlights
✅ Erstmalige L-RoPE-Technik: Mithilfe von Label Rotary Position Embedding wird das Problem der Fehlzuordnung mehrerer Audioströme zu den Personen gelöst, sodass Audio und Figuren präzise einander entsprechen
✅ Audio-gesteuerte Videoerzeugung: Durch die Eingabe von Mehrpersonen-Audio, Referenzbildern und Textaufforderungen werden lippensynchrone und natürlich wirkende Interaktionsvideos mit passenden Körperbewegungen erzeugt
✅ Teilparametertraining + Multitask-Lernstrategie: Während die Fähigkeit zur Befolgung komplexer Aktionsanweisungen erhalten bleibt, wird eine adaptive Positionierung dynamischer Figuren ermöglicht
✅ Unterstützung mehrerer Szenarien: Einsetzbar in Filmproduktion, Live-Streaming-E-Commerce und vielen weiteren Szenarien
Technischer Rahmen
✅ Grundlegende Modellarchitektur: Basierend auf einem DiT-Videodiffusionsmodell mit integriertem 3D-Variational-Autoencoder zur effizienten Verarbeitung von Videodaten
✅ Audiointegration für Einzelpersonen: Nach der Text-Cross-Attention-Schicht jedes DiT-Blocks wird ein Audio-Cross-Attention-Mechanismus hinzugefügt, Audio-Features werden mit Wav2Vec extrahiert und ein Audio-Adapter löst das Problem der unterschiedlichen zeitlichen Granularität zwischen Video und Audio
✅ Verarbeitung von Mehrpersonen-Audio: Durch die L-RoPE-Technik wird eine präzise Zuordnung mehrerer Audioströme zu mehreren Personen erreicht und ein gleichzeitiges Sprechen aller Figuren vermieden
Trainingsstrategien
✅ Zweistufiges Training: Zunächst wird die Fähigkeit zur Erzeugung von Einzelpersonenvideos trainiert, anschließend die Interaktion und Zuordnung mehrerer Personen
✅ Teilparametertraining: Es werden nur die Netzwerkparameter der Audio-Cross-Attention-Schicht und des Audio-Adapters aktualisiert, die übrigen Parameter des Basismodells bleiben eingefroren
✅ Multitask-Training: Die Trainingsmethoden Audio + Bild zu Video sowie Bild zu Video werden kombiniert, um die Befolgung von Anweisungen durch das Modell zu stärken
Leistungsfähigkeit
✅ Quantitative Bewertung: Bei der Erzeugung von Kopf- und Körperbewegungen erzielt das Modell im Vergleich zu mehreren modernen Methoden hervorragende Ergebnisse hinsichtlich Lippensynchronisation (Sync-C, Sync-D) und Videoqualität (FID, FVD)
✅ Qualitative Bewertung: Auch bei komplexen Interaktionsszenen liefert das Modell gute Ergebnisse, erzeugt Videos, die präzise auf komplexe Textaufforderungen reagieren, mit wenigen visuellen Artefakten und einem natürlich wirkenden Bild
✅ Erzeugung langer Videos: Mithilfe autoregressiver Methoden wird der Endteil eines zuvor erzeugten Videos als Bedingung verwendet, um neue Videosequenzen zu generieren und so zeitliche Kohärenz sowie Erweiterbarkeit sicherzustellen
Anwendungsszenarien
Filmproduktion: Interaktion virtueller Figuren, Animationssynchronisation, Effektkomposition, Kurzfilmproduktion
Live-Streaming-E-Commerce: Interaktion virtueller Moderatoren, Produktpräsentation und -erläuterung, mehrsprachige Live-Übertragungen
Bildungsbereich: Interaktion virtueller Lehrkräfte, Sprachenlernen, historische Rekonstruktionen
Spieleentwicklung: Dialoge virtueller Figuren, NPC-Interaktion, Multiplayer-Onlinespiele
Werbung und Marketing: Virtuelle Testimonials, Produktwerbung, Social-Media-Anzeigen
Virtuelle soziale Interaktion: Interaktion auf Plattformen für virtuelle Soziale Netzwerke, virtuelle Meetings
Unterhaltung und Kreativität: Musikvideos, virtuelle Konzerte, kreative Kurzfilme
Öffentliche Dienste: Nachrichtenmoderation, Öffentlichkeitsarbeit für Serviceleistungen
Unternehmensschulungen: Virtuelle Schulungsszenarien, Situationssimulationen
Internationaler Austausch: Mehrsprachige Dialoge, kultureller Austausch
Projektadresse
Projekt-Hauptseite: https://meigen-ai.github.io/multi-talk/
Open-Source-Code: https://github.com/MeiGen-AI/MultiTalk
Paper und Technik: https://arxiv.org/abs/2505.22647









