
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ColQwen-Omni: ein Open-Source-Multimodal-RAG-Modell
小编 ·

ColQwen-Omni: ein Open-Source-Multimodal-RAG-Modell
ColQwen-Omni, ein Open-Source-Multimodal-RAG-Modell, das auf ColQwen2 und Qwen2-VL aufbaut, ist das erste Open-Source-Modell, das das ColBERT-Abrufparadigma auf die Audio-Modalität erweitert.
Es unterstützt Cross-Modal-Retrieval und kann verschiedene modale Daten wie Text, Audio und Bilder verarbeiten. Das Trainingsdatenset umfasst 127.460 Abfrage-Seite-Paare, wobei 63 % aus Trainingssets öffentlicher akademischer Datensets stammen und 37 % aus synthetischen Datensets. Das Modell verfügt über Zero-Shot-Audio-Retrieval-Fähigkeiten.
Kern-Highlights
Cross-Modal-Retrieval: Unterstützt Text-zu-Audio-, Audio-zu-Bild-Abfragen usw., wobei alle modalen Daten im selben Vektorraum abgerufen werden.
Direkte Verarbeitung von Audio-Videos: Keine Transkription erforderlich, verarbeitet Audio- und Video-Rohdaten direkt und bewahrt Emotionen, Tonfall und visuelle Details.
Extrem schnelles Retrieval: 30 Minuten Audio in 10 Sekunden verarbeitet, kurze Videos in jeweils weniger als 10 Sekunden, einzelne Abfrage in weniger als 100 Millisekunden.
TMRoPE-Synchronisation: Zeitlich ausgerichtete multimodale Einbettungen, präzise Ausrichtung von Video-/Audio-Frames.
Leichtgewichtig und effizient: 3 Milliarden Parameter, lauffähig auf der kostenlosen GPU von Colab.
Technische Details zu ColQwen-Omni
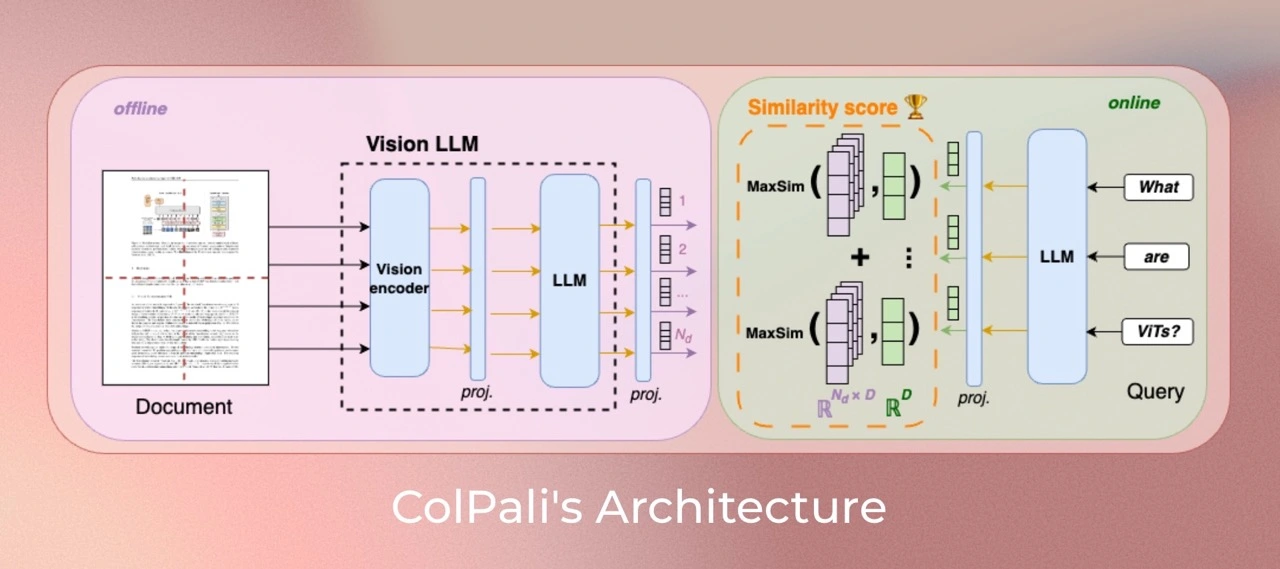
Trainingsstrategie: Trainiert mit colpali-engine==0.3.11, basierend auf Qwen2.5-Omni-3B-Instruct, unter Verwendung der ColBERT-artigen Multi-Vektor-Darstellungsstrategie.
Trainingsdaten: Enthält 127.460 Abfrage-Seite-Paare, die öffentliche akademische Datensets und synthetische Datensets abdecken.
Dynamische Auflösungsverarbeitung: Unterstützt Eingaben mit dynamischer Bildauflösung, skaliert oder beschneidet Bilder nicht und behält das ursprüngliche Seitenverhältnis bei.
Zero-Shot-Audio-Retrieval-Fähigkeit: Die Trainingsdaten enthalten zwar nur Bild-Text-Paare, dennoch kann das Modell Audioinhalte abrufen.
Anwendungsszenarien
Audio- und Video-Retrieval: Textsuche in TED-Vorträgen, Audiosuche nach YouTube-Covern usw.
Dokumenten-Frage-Antwort-System: PDF-/Bild-Frage-Antwort ohne OCR, kann Layouts und Diagramme parsen.
Bildung und Forschung: Abruf von Kursvideos/Vorlesungen für Cross-Modal-Analysen.
Entertainment-Analyse: Suche in Kurzvideos/Podcasts unter Bewahrung von Emotionen und Umgebungsgeräuschen.
Datenschutzsensible Szenarien: Kann lokal auf Colab ausgeführt werden, ohne dass Daten hochgeladen werden müssen.
Wichtige Fragen
Welche Merkmale weist das Trainingsdatenset von ColQwen2.5-Omni auf?
Das Trainingsdatenset dieses Modells umfasst 127.460 Abfrage-Seite-Paare, wobei 63 % aus Trainingssets öffentlicher akademischer Datensets stammen und 37 % aus synthetischen Datensets (einschließlich per Webcrawling gesammelter PDF-Seiten und von VLM generierter Pseudo-Fragen). Das Datenset ist vollständig in englischer Sprache gestaltet, um die Erforschung der Zero-Shot-Generalisierungsfähigkeit auf nicht-englische Sprachen zu erleichtern. 2 % der Stichproben dienen als Validierungsset zur Abstimmung der Hyperparameter. Zudem werden keine mehrseitigen PDF-Dokumente gleichzeitig für ViDoRe und das Trainingsset verwendet, um Evaluierungsverzerrungen zu vermeiden. Der Sprachmodell-Vortrainingskorpus sowie das multimodale Training können mehrsprachige Daten enthalten.
Wie unterscheidet sich ColQwen2.5-Omni in der Bildverarbeitung von ColPali?
ColQwen2.5-Omni nimmt dynamische Bildauflösungen an, ohne das Seitenverhältnis durch Skalierung zu verändern, und erstellt bei maximaler Auflösung bis zu 1024 Bild-Patches; ColPali verändert hingegen das Seitenverhältnis des Bildes.
Wie verwendet man ColQwen2.5-Omni für das Audio-Retrieval?
Installieren Sie zunächst colpali-engine in einer Version höher als 0.3.11 (kann via pip install git+https://github.com/illuin-tech/colpali installiert werden); importieren Sie dann die erforderlichen Bibliotheken und laden Sie das Modell sowie den Prozessor; verarbeiten Sie das Audio-Datenset, erstellen Sie einen Datenlader und generieren Sie Audio-Einbettungsvektoren; definieren Sie schließlich eine Retrieval-Funktion, geben Sie den Abfragetext ein, generieren Sie mit dem Modell Abfrage-Einbettungsvektoren, bewerten Sie diese gegen die Audio-Einbettungsvektoren und erhalten Sie die _topk-Ergebnisse, um die entsprechenden Audiodateien anzuzeigen.
Projektlinks
GitHub-Adresse:https://github.com/illuin-tech/colpali.
Modell-Adresse:https://huggingface.co/vidore/colqwen-omni-v0.1.









