
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
MuseSteamer: Baidus eigenentwickeltes KI-Videogenerierungsmodell
小编 ·

MuseSteamer: Baidus eigenentwickeltes KI-Videogenerierungsmodell
MuseSteamer ist das von Baidu am 2. Juli 2025 veröffentlichte Video-Generierungsmodell. Es kann gleichzeitig Bilder, Soundeffekte und Dialogzeilen erzeugen und ist das erste Modell, das eine integrierte Erzeugung von Audio und Video auf Chinesisch ermöglicht. Damit durchbricht es das traditionelle KIGC-Video-Muster, bei dem zuerst das Bild und anschließend die Vertonung erstellt wird. Baidu brachte gleichzeitig die KI-Videoerstellungsplattform „绘想“ auf den Markt.
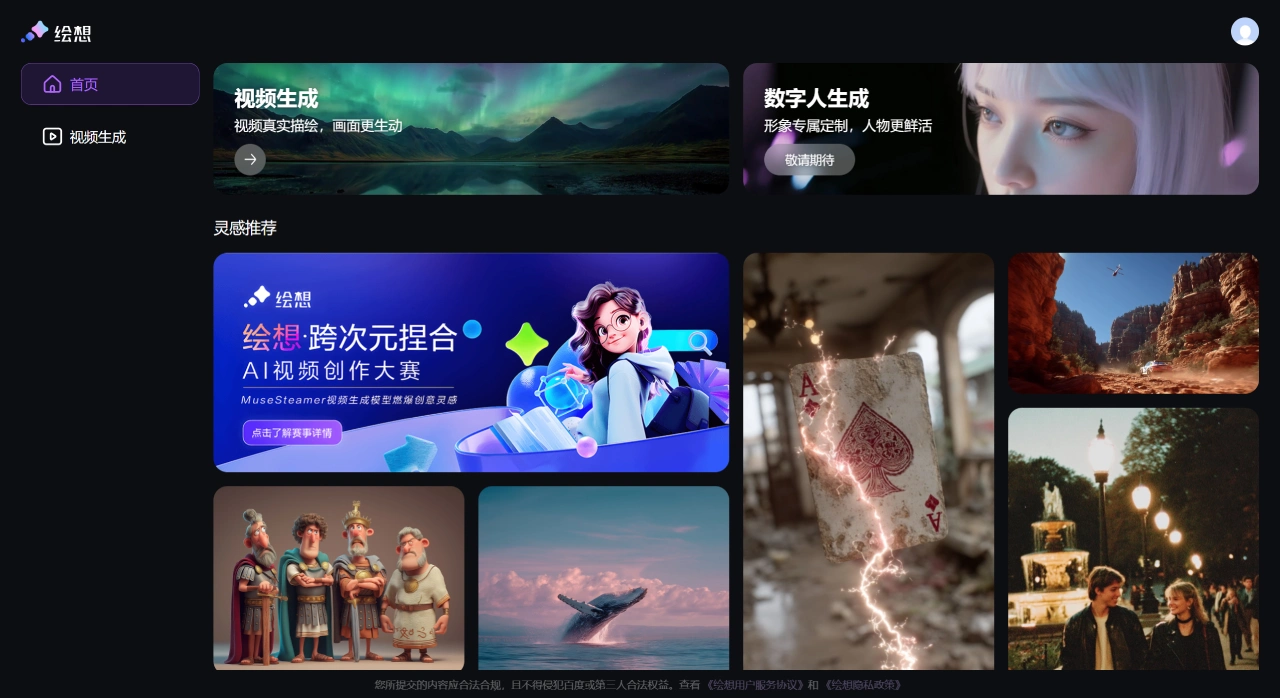
Funktionsmerkmale:
Integrierte Audio-Video-Generierung: Das weltweit erste Videomodell, das eine integrierte Erzeugung von Audio und Video auf Chinesisch ermöglicht. Es kann Bilder gemeinsam mit Soundeffekten und gesprochenen Dialogzeilen erstellen und durchbricht den traditionellen AIGC-Video-Workflow „erst Bild, dann Vertonung“.
Multimodale Eingabe: Unterstützt chinesische Textaufforderungen, Referenzbilder und andere Eingabemethoden.
Video-Generierung: Kann dynamische Videos von bis zu 10 Sekunden Länge mit hervorragender Bildqualität erzeugen, ermöglicht eine flexible Steuerung von Szene, Aktion und Kameraführung und erzielt eine integrierte Audio-Video-Ausgabe. Beispielsweise wirken bei generierten Videos im Kostüm-Martial-Arts-Stil die Bewegungen und Gesichtsausdrücke der Figuren natürlich und die Kameraführung professionell.
Integrierte Generierung: Erzeugt synchron Bild, Soundeffekte und Dialogzeilen, wobei Ton und Bild natürlich zueinander passen, was die Vollständigkeit und den künstlerischen Ausdruck des Videos steigert.
Chinesisches Sprachverständnis: Versteht die chinesische Semantik präzise und stellt durch eine optimierte Datenaufbereitung sicher, dass Textanweisungen und visuelle Elemente semantisch aufeinander abgestimmt sind.
Video-Beschreibungssprache: Verwendet eine fein strukturierte, deskriptive Sprache für Videos, die Bilddetails, Bewegungstrajektorien von Motiven, Stileigenschaften und Kamerasprache abdeckt, um sicherzustellen, dass das Modell die Bilddetails genau umsetzt.
Technologische Durchbrüche:
Bereinigung hundertmillionen chinesischer multimodaler Daten: Umfassende Bereinigung großer Mengen chinesischer multimodaler Daten, um eine hohe Qualität der Trainingsdaten sicherzustellen.
Fein strukturierte deskriptive Video-Beschreibungssprache: Verbessert die Fähigkeit des Modells, Videoinhalte zu verstehen und zu generieren.
Multi-Objective-Verstärkungslernen: Optimierte Verfahren, die ein angemessenes Bewegungsausmaß der Videos gewährleisten und gleichzeitig die Konsistenz und stabile Ausgabe der Hauptinhalte bewahren.
Produktmatrix und Zielgruppen:
Lite-Version: 720p, schnelle Generierungsgeschwindigkeit (30 Sekunden), günstiger Preis, geeignet für preisbewusste Nutzer.
Turbo-Version: 720p, spezialisiert auf die Generierung von Personen- und Anime-Videos, mit guter Bewegungskonsistenz, großem Bewegungsspielraum und natürlichen Gesichtsausdrücken, geeignet für die meisten Kreativen, bereits auf der 绘想-Plattform verfügbar und mit einer befristeten kostenlosen öffentlichen Beta gestartet.
Pro-Version: 1080p, Bildqualität und Kameraführung auf Kinoniveau, starke Ausdruckskraft, geeignet für professionelle Kreative und Filmproduktionsstudios.
Ton-Version: Unterstützt in allen Auflösungen die integrierte Erzeugung von Soundeffekten und Dialogzeilen, geeignet für Nutzer mit hohen Anforderungen an synchronen Ton und Bild.
Anwendungsszenarien:
Videoerstellung: Hilft Kreativen, kreative Engpässe zu überwinden und schnell hochwertige Videos zu generieren.
Werbeproduktion: Bietet effiziente Lösungen für die Erstellung von Werbevideos und steigert deren Attraktivität.
Bildung und Schulung: Erzeugt Lehrvideos und Animationen, um komplexe Konzepte anschaulich zu erklären.
Persönliche Unterhaltung: Nutzer können Bilder hochladen und daraus personalisierte Videos erstellen, um persönliche Geschichten zu teilen.









