
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
XVerse: ByteDances Open-Source-Tool zur Multi-Subject-Bildsynthese
小编 ·

XVerse: ByteDances Open-Source-Tool zur Multi-Subject-Bildsynthese
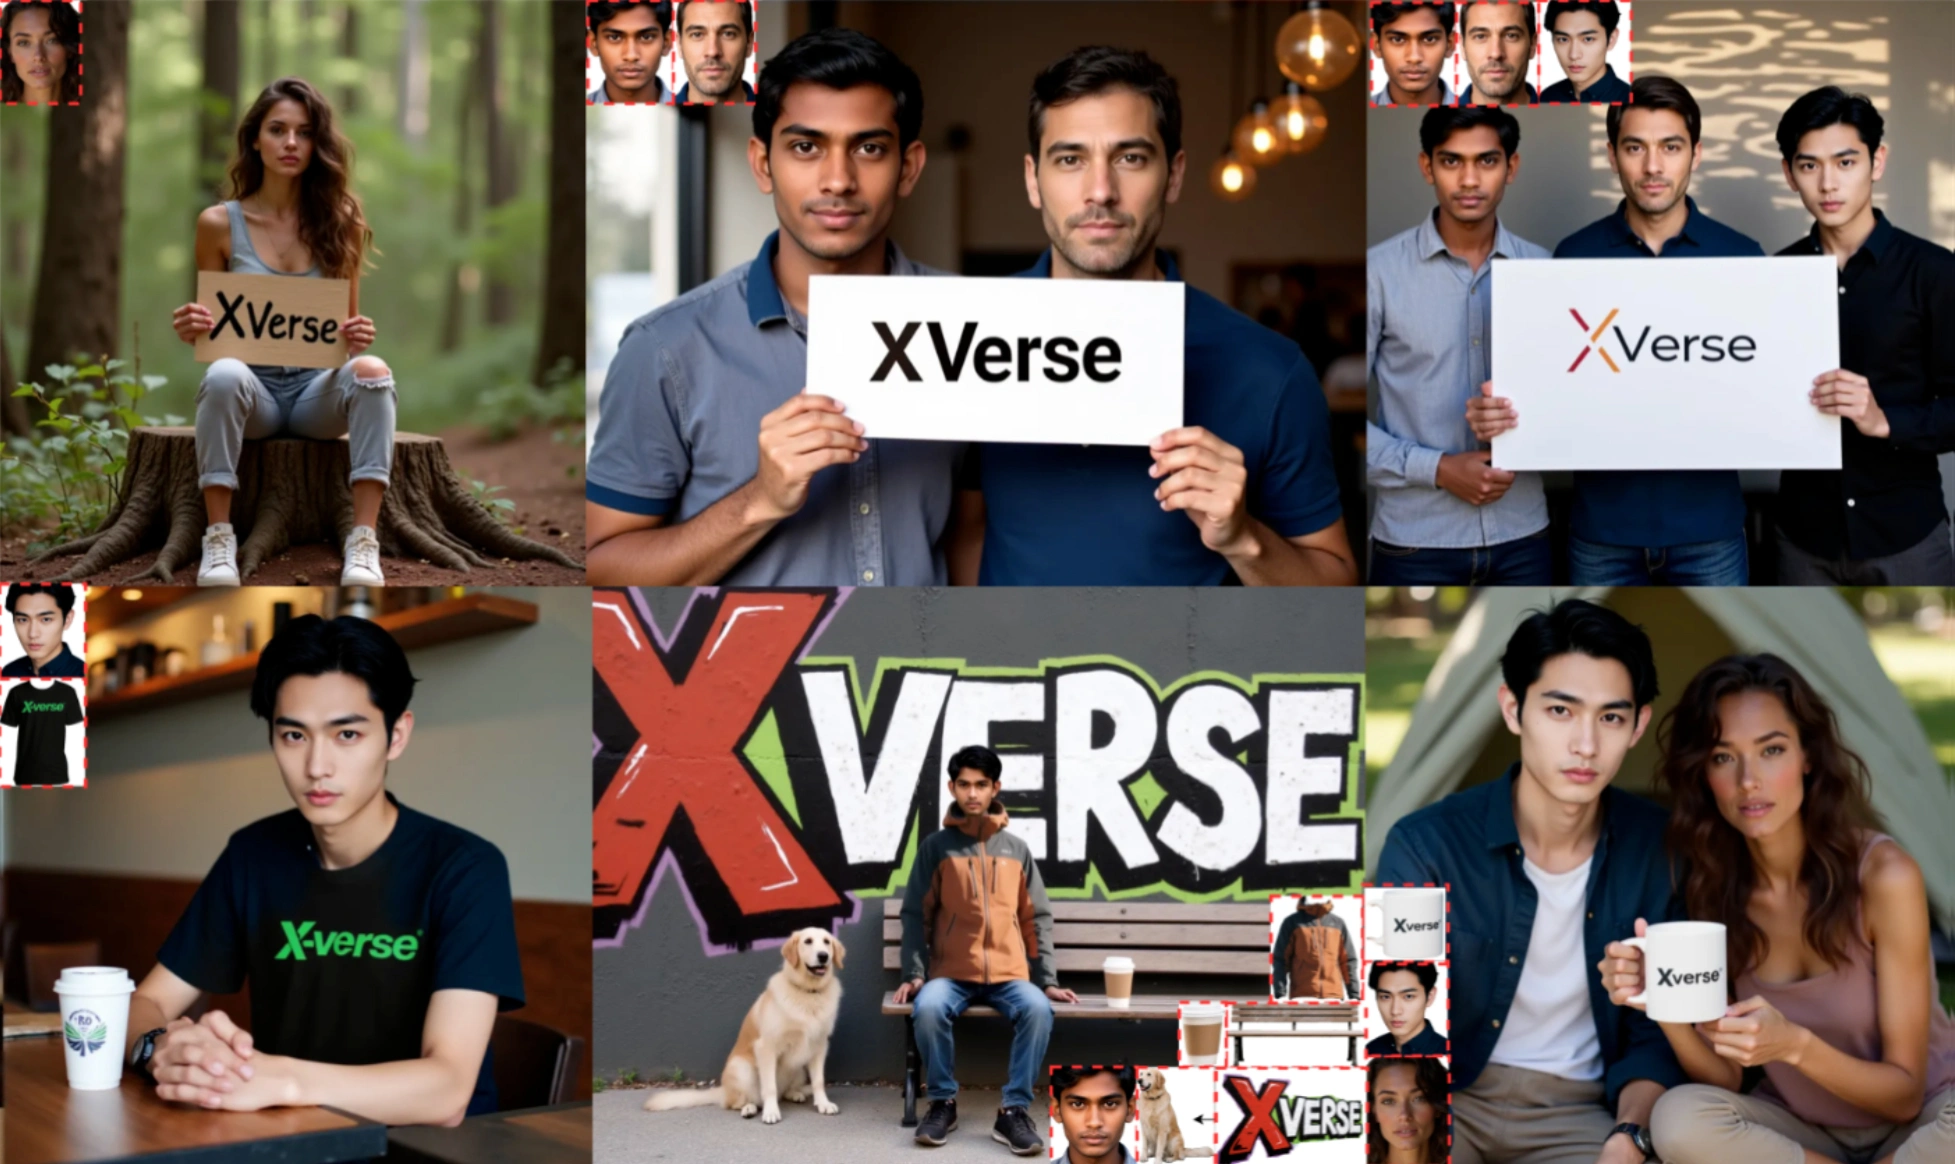
XVerse ist ein von ByteDance eingeführtes Werkzeug zur Multi-Subjekt-Bildsynthese, das eine hochpräzise Erzeugung von Bildern mit mehreren Subjekten ermöglicht. Es ermöglicht Benutzern die unabhängige und präzise Steuerung mehrerer Subjekte und verbessert so die Fähigkeit zur Generierung komplexer Szenen erheblich.
Kernfunktionen
Multi-Subjekt-Steuerung: XVerse wandelt Referenzbilder in textflussmodulierte Offsets um, steuert die Identitätsmerkmale jedes Subjekts präzise und passt semantische Attribute (Pose, Stil, Beleuchtung usw.) unabhängig an. Dies löst die bei herkömmlichen Modellen häufig auftretenden Probleme der Identitätsverwechslung und Attributverflechtung in Multi-Subjekt-Szenen und ermöglicht eine hochauflösende, bearbeitbare Multi-Subjekt-Bildsynthese.
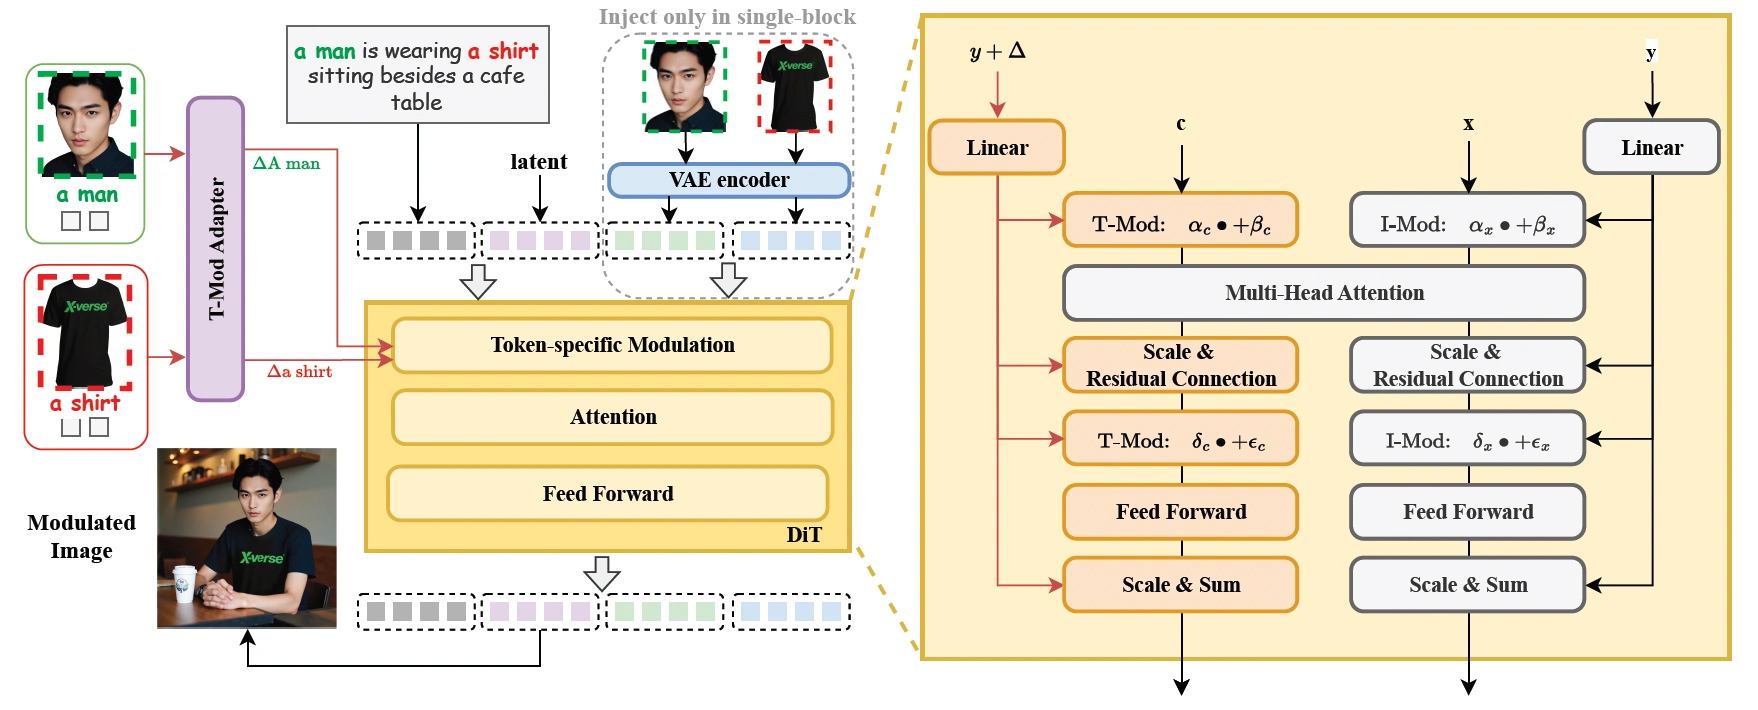
Verbesserung der Textflussmodulation: Durch die Kombination von Referenzbildmerkmalen und Textprompt-Merkmalen zur Erzeugung von Offsets und deren Injektion in spezifische Text-Token-Einbettungen erreicht XVerse eine präzise Steuerung jedes Subjekts, während die Gesamtstruktur des erzeugten Bildes erhalten bleibt und Details feinabgestimmt werden können.
VAE-codierte Bildmerkmale: VAE-codierte Bildmerkmale werden als Hilfseingabe in einzelne Blöcke der DiTs injiziert. Dies hilft dabei, Bilddetails zu erfassen und wiederzugeben, und vermeidet Artefakte sowie Qualitätsverluste, die bei einer direkten Injektion von Bildmerkmalen auftreten können.
Regularisierungstechniken: Durch den Einsatz von Regional Preservation Loss wird das Modell gezwungen, in nicht modulierten Bereichen Konsistenz zu wahren und die Merkmale verschiedener Subjekte zu unterscheiden und beizubehalten. Durch den Text-Bild-Aufmerksamkeitsverlust werden die Kreuzaufmerksamkeitskarten zwischen dem Modulationsmodell und dem Referenz-T2I-Zweig in Einklang gebracht, um die Konsistenz und Bearbeitbarkeit semantischer Interaktionen während der Modulation sicherzustellen.
Technische Prinzipien von XVerse
Textflussmodulationsmechanismus: XVerse wandelt Referenzbilder in tokenspezifische Textflussmodulations-Offsets um, die den Text-Embeddings des Modells hinzugefügt werden, um so eine präzise Steuerung bestimmter Subjekte zu ermöglichen, ohne die Bildlatenten oder -merkmale zu stören.
VAE-codiertes Bildmerkmalsmodul: Zur Verbesserung der Detailerhaltung in erzeugten Bildern führt XVerse ein Modul für VAE-codierte Bildmerkmale ein. Dieses Modul dient als Hilfsmodul und unterstützt das Modell dabei, im Generierungsprozess mehr Detailinformationen zu bewahren und Artefakte sowie Verzerrungen zu reduzieren.
Regularisierungstechniken: Basierend auf einer zufälligen Beibehaltung der Modulationsinjektion auf einer Seite wird das Modell gezwungen, in nicht modulierten Bereichen Konsistenz zu wahren. Subjektspezifische Merkmale werden regularisiert und als Datenaugmentierungsstrategie für Multi-Subjekt-Datensätze eingesetzt, um die Fähigkeit des Modells zu verbessern, Subjektmerkmale in Multi-Subjekt-Szenen zu unterscheiden und beizubehalten. Durch die Berechnung des L2-Verlusts der Text-Bild-Kreuzaufmerksamkeitskarten zwischen dem Modulationsmodell und dem Referenz-T2I-Zweig wird sichergestellt, dass das Modulationsmodell konsistente Aufmerksamkeitsmuster wie der T2I-Zweig beibehält und somit die Konsistenz und Bearbeitbarkeit semantischer Interaktionen gewahrt bleibt.
Anwendungsszenarien
Digitale Inhaltserstellung: XVerse hilft Kreativen, eine präzise Steuerung mehrerer Subjekte mühelos umzusetzen. Es kann zum Zeichnen von Comics, zur Erstellung von Story-Illustrationen, zum Aufbau komplexer virtueller Szenen und mehr verwendet werden und macht Werke so lebendiger, reichhaltiger und fantasievoller.
Werbebranche: XVerse kann die Attribute jedes Subjekts präzise steuern und gewährleistet eine hohe Wiedergabetreue und Konsistenz der Werbebilder, sodass Werbung auffälliger wird und die Verbreitungswirkung gesteigert wird.
Kunstbereich: Bietet Künstlern ein völlig neues Kreativwerkzeug, das die Grenzen traditioneller Kreation sprengt und die Schaffung einzigartiger, ausdrucksstarker Kunstwerke ermöglicht.
Verwendung von XVerse
Benutzer müssen eine Conda-Umgebung mit Python 3.10.16 erstellen, Abhängigkeiten installieren sowie die zugehörigen Checkpoints und Gesichtserkennungsmodelle herunterladen. Die Benutzeroberfläche ist benutzerfreundlich und bietet umfangreiche Eingabeeinstellungsoptionen, einschließlich einer Funktion „Erkennung und Segmentierung", die hochgeladene Bilder analysieren, Gesichter automatisch zuschneiden und Beschreibungen generieren kann. Darüber hinaus wird eine interaktive Gradio-Demo bereitgestellt, mit der Benutzer Bilder hochladen, Beschreibungen eingeben und in Echtzeit Bilder erzeugen sowie die Ergebnisse durch Anpassen der Parameter optimieren können.
Projektadresse
Projekt-Website:https://bytedance.github.io/XVerse/
GitHub-Repository:https://github.com/bytedance/XVerse
HuggingFace-Modellbibliothek:https://huggingface.co/ByteDance/XVerse
arXiv-Technische Abhandlung:https://arxiv.org/pdf/2506.21416









