
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Alibaba Ovis-U1: Multimodales Verstehen, Bildgenerierung und -bearbeitung in einem Modell
小编 ·

Alibaba Ovis-U1: Multimodales Verstehen, Bildgenerierung und -bearbeitung in einem Modell
Am 29. Juni 2025 stellte das internationale AI-Team von Alibaba das multimodale Großmodell Ovis-U1 vor, die neueste Version der Ovis-Serie. Es wurde auf der bestehenden Architektur entwickelt und verfügt über 300 Millionen Parameter.
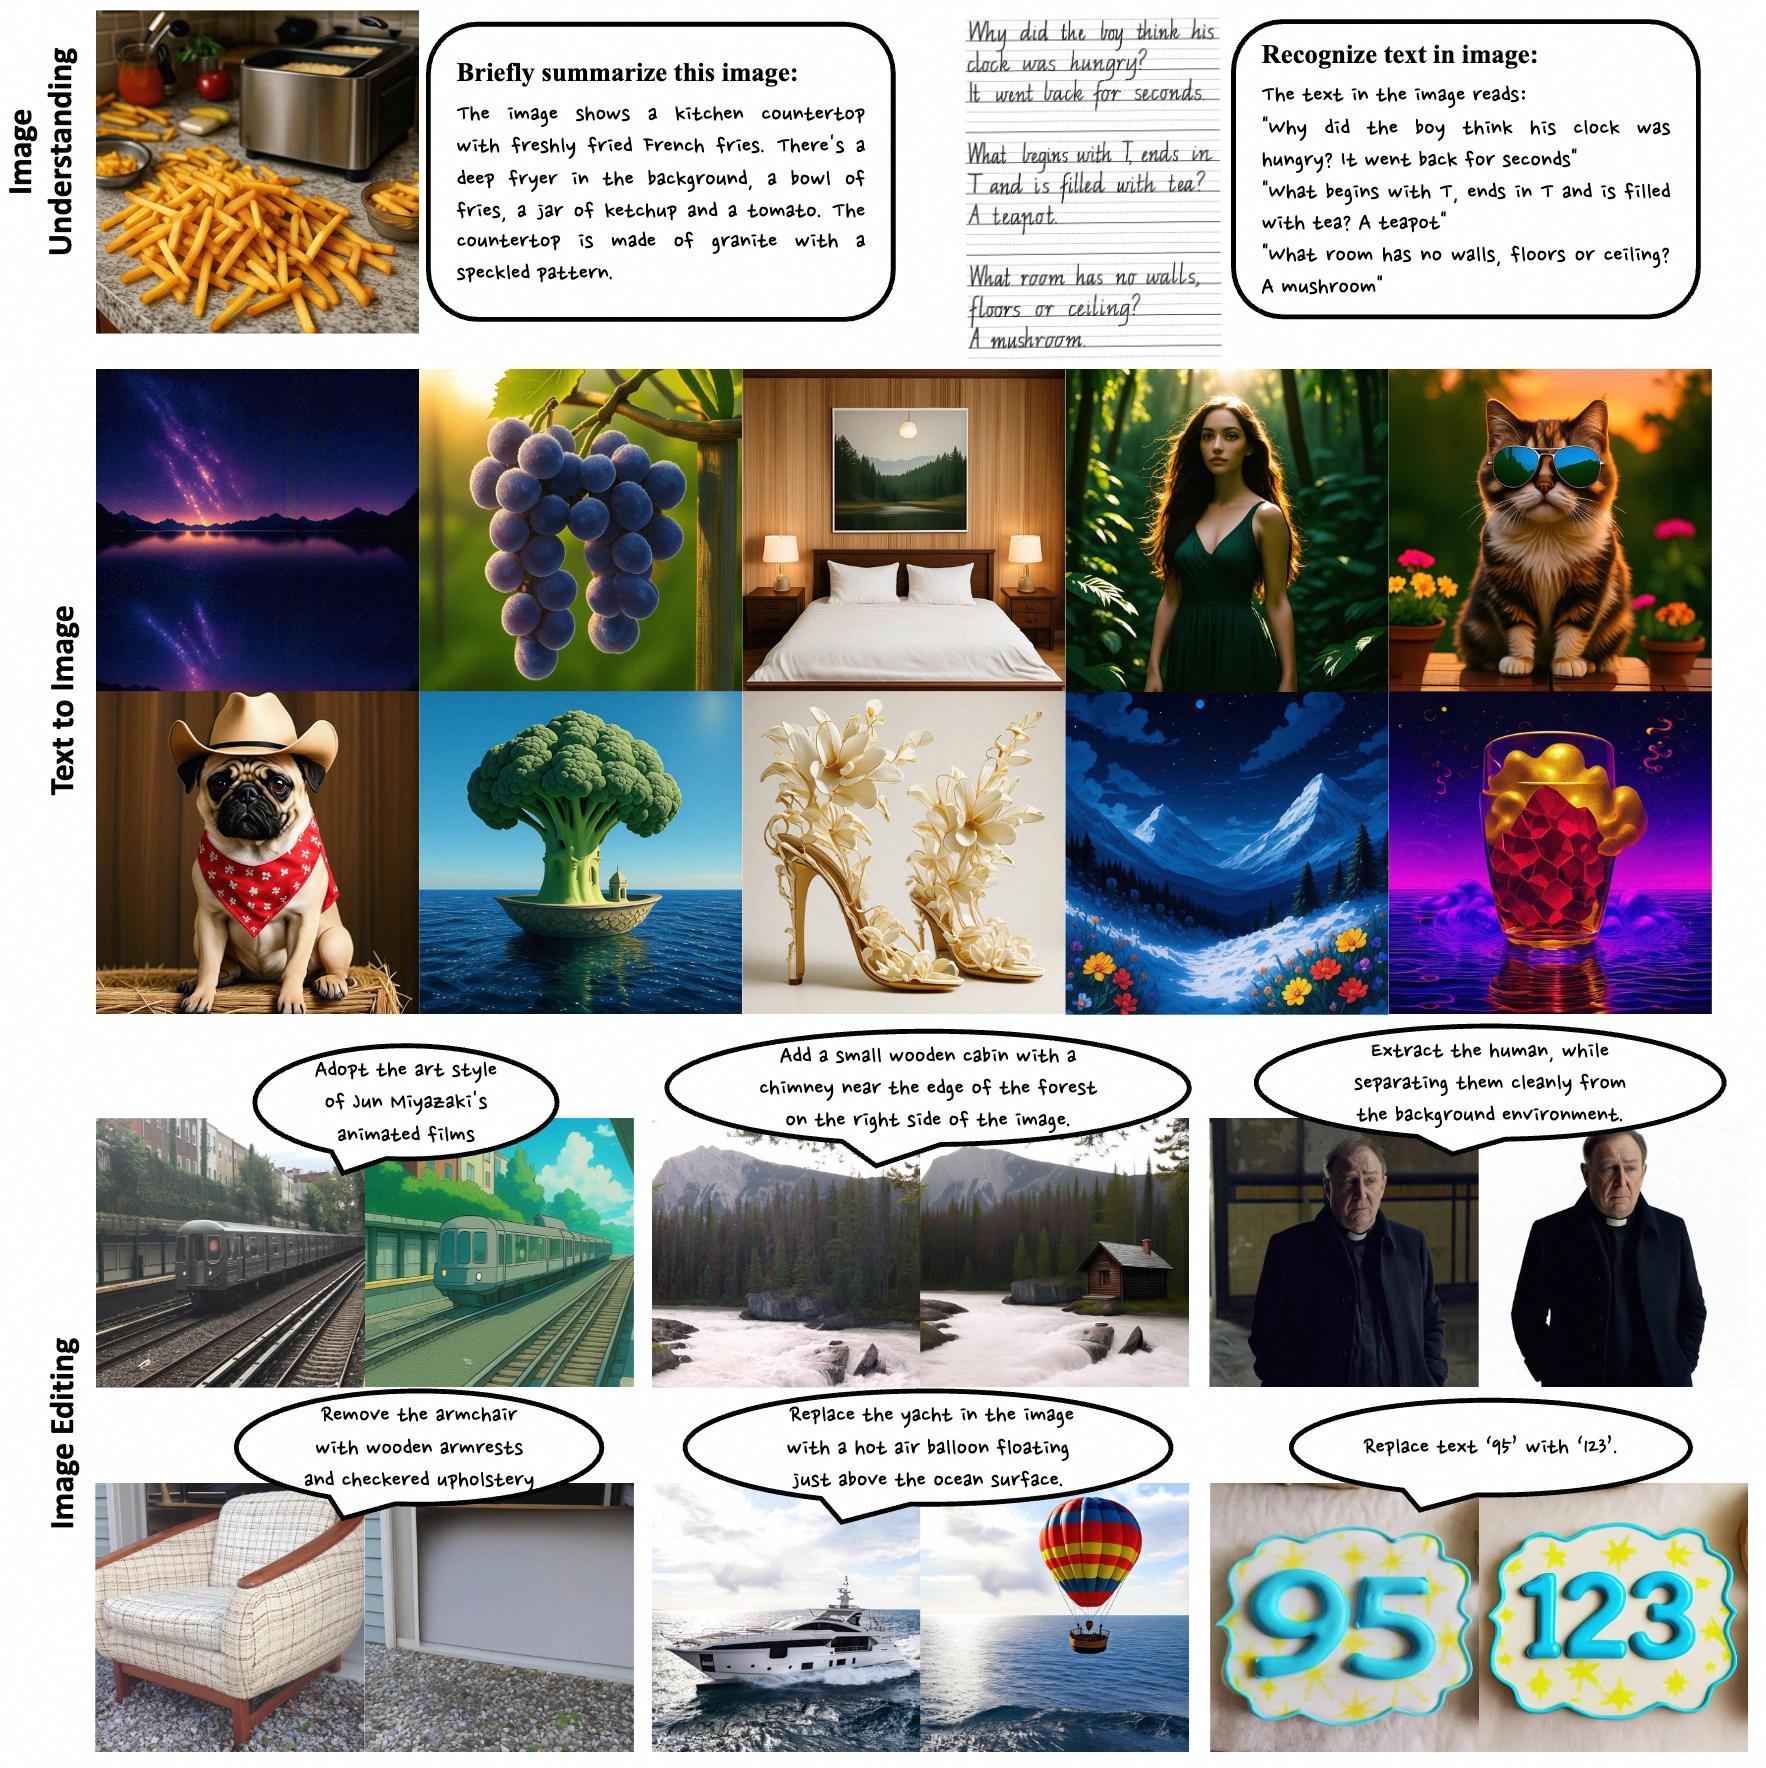
Das Modell integriert multimodales Verständnis, Bildgenerierung und Bearbeitungsfunktionen. Zu den Kernkomponenten gehören ein visueller Tokenizer, eine visuelle Einbettungstabelle und ein großes Sprachmodell. Durch die Optimierung der Abstimmung zwischen visuellen und textuellen Einbettungen werden einige Einschränkungen traditioneller multimodaler Modelle gelöst, was zu einer besseren Leistung in komplexen Szenarien führt. Es unterstützt Text- und Bildeingaben und zeigt hervorragende Ergebnisse bei Aufgaben wie mathematischem Schließen und Objekterkennung. Es kann Objekte oder handschriftlichen Text in Bildern präzise erkennen sowie Bilder nach Anweisung generieren oder bearbeiten.
Kernfähigkeiten
Multimodales Verständnis: Kann komplexe visuelle Szenen und Textinhalte analysieren, bildbezogene Fragen beantworten sowie Aufgaben wie visuelle Frage-Antwort-Systeme (VQA) und Bildbeschreibungsgenerierung durchführen.
Text-zu-Bild-Generierung: Erzeugt hochwertige Bilder auf Basis von Textbeschreibungen und passt sich an verschiedene Stile und komplexe Szenarien an.
Bildbearbeitung: Ermöglicht das Hinzufügen, Anpassen, Ersetzen und Löschen von Bildelementen sowie Stilumwandlungen durch Textanweisungen.
Technische Architektur
Visueller Decoder: Verwendet eine diffusionsbasierte Transformer-Architektur (MMDiT), um Texteinbettungen in hochwertige Bilder umzuwandeln.
Bidirektionaler Token-Refiner: Stärkt die Interaktion zwischen Text- und visuellen Einbettungen und verbessert die Bildsynthese sowie Bearbeitungsergebnisse.
Visueller Encoder: Basiert auf der Feinabstimmung vortrainierter Modelle (z. B. Aimv2-large-patch14-448) zur Anpassung an multimodale Aufgaben.
Adapter: Verbindet den visuellen Encoder mit dem multimodalen großen Sprachmodell (MLLM) und richtet die beiden Arten von Einbettungsdaten aufeinander aus.
Multimodales großes Sprachmodell: Dient als Kernmodul zur Verarbeitung von Text- und visuellen Informationen und unterstützt Mehrfachaufgabenverarbeitung.
Trainingsmethode
Ovis-U1 verbessert die Generalisierungsfähigkeit durch synchrones Training der Aufgaben multimodales Verständnis, Bildgenerierung und Bildbearbeitung, wobei gemeinsames Wissen geteilt wird. Das Training erfolgt in sechs Phasen, in denen die Leistung bei jeder Aufgabe schrittweise optimiert wird.
Datenkomposition
Daten für multimodales Verständnis: Stammen aus öffentlichen Datensätzen wie COYO, Wukong, Laion sowie aus internen Entwicklungsdaten.
Daten für Bildgenerierung: Basieren auf den Datensätzen Laion5B und JourneyDB sowie auf detaillierten Beschreibungen, die von vortrainierten Modellen generiert wurden.
Daten für Bildbearbeitung: Umfassen Daten für Aufgaben wie referenzbildgesteuerte Generierung und pixelgenaue Steuerung.
Leistungsoptimierung
In der Bildbearbeitung wird die Anweisungsausführung durch Anpassung der Text- und Bildführungsfaktoren (CFG) präzise gesteuert. Zur umfassenden Bewertung der Modellfähigkeiten werden Benchmarks wie OpenCompass und GenEval eingesetzt.
Anwendungsszenarien
Inhaltserstellung: Unterstützt Künstler und Video-Editoren bei der kreativen Konzeption.
Werbung und Marketing: Generiert Werbebilder und Plakate basierend auf Produkt- und Zielgruppenbeschreibungen.
Spieleentwicklung: Erzeugt Bilder von Spielszenerien, Charakteren und Requisiten.
Architekturdesign: Erstellt Architekturkonzepte und Raumgestaltungslösungen.
Wissenschaftliche Forschung: Visualisiert komplexe wissenschaftliche Phänomene und experimentelle Szenarien.
In Fortführung der Open-Source-Tradition der Ovis-Serie wurden Modellcode, Gewichtungen und Trainingsdaten unter der Apache2.0-Lizenz auf Hugging Face und GitHub veröffentlicht, sodass Entwickler das Modell schnell reproduzieren und bereitstellen können.
Projektadressen
GitHub-Repository:https://github.com/AIDC-AI/Ovis-U1
HuggingFace-Modellbibliothek:https://huggingface.co/AIDC-AI/Ovis-U1-3B
Technisches Paper:https://github.com/AIDC-AI/Ovis-U1/blob/main/docs/Ovis_U1_Report.pdf
Online-Demo:https://huggingface.co/spaces/AIDC-AI/Ovis-U1-3B









