
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DreamActor-H1: Videos mit Personen, die Produkte präsentieren – ideal für Werbeclips
小编 ·

DreamActor-H1: Videos mit Personen, die Produkte präsentieren – ideal für Werbeclips
DreamActor-H1 ist ein Video-Generierungs-Framework, das von ByteDance im Juni 2025 vorgestellt wurde. Es basiert auf der Diffusion-Transformer-Technologie (DiT), richtet sich hauptsächlich an den E-Commerce- und Digitalmarketing-Bereich und kann zur Erstellung von Produktvorstellungsvideos verwendet werden.
Dieses Framework kann anhand von Paaren aus menschlichen Körpern und Produktbildern hochwertige Demonstrationsvideos von Personen mit Produkten erzeugen. Es wurde auf einem umfangreichen, gemischten Datensatz mit kategorieübergreifender Augmentation trainiert und übertrifft bestehende Methoden sowohl bei der Erhaltung der Identität von Personen und Produkten als auch bei der Erzeugung physikalisch plausibler Demonstrationsbewegungen. Damit eignet es sich für personalisierte E-Commerce-Werbung und interaktive Medien. Es liefert mithilfe einer 3D-Körpernetzvorlage und Produkt-Bounding-Boxen präzise Bewegungsanleitungen und kombiniert diese mit VAE-codierten Erscheinungsmerkmalen, strukturierten, textcodierten, kategoriebezogenen Semantiken und Mechanismen wie Referenz- und Objekt-Attention, um die Probleme bestehender Frameworks bei der Identitätserhaltung und dem Verständnis räumlicher Beziehungen zu lösen.
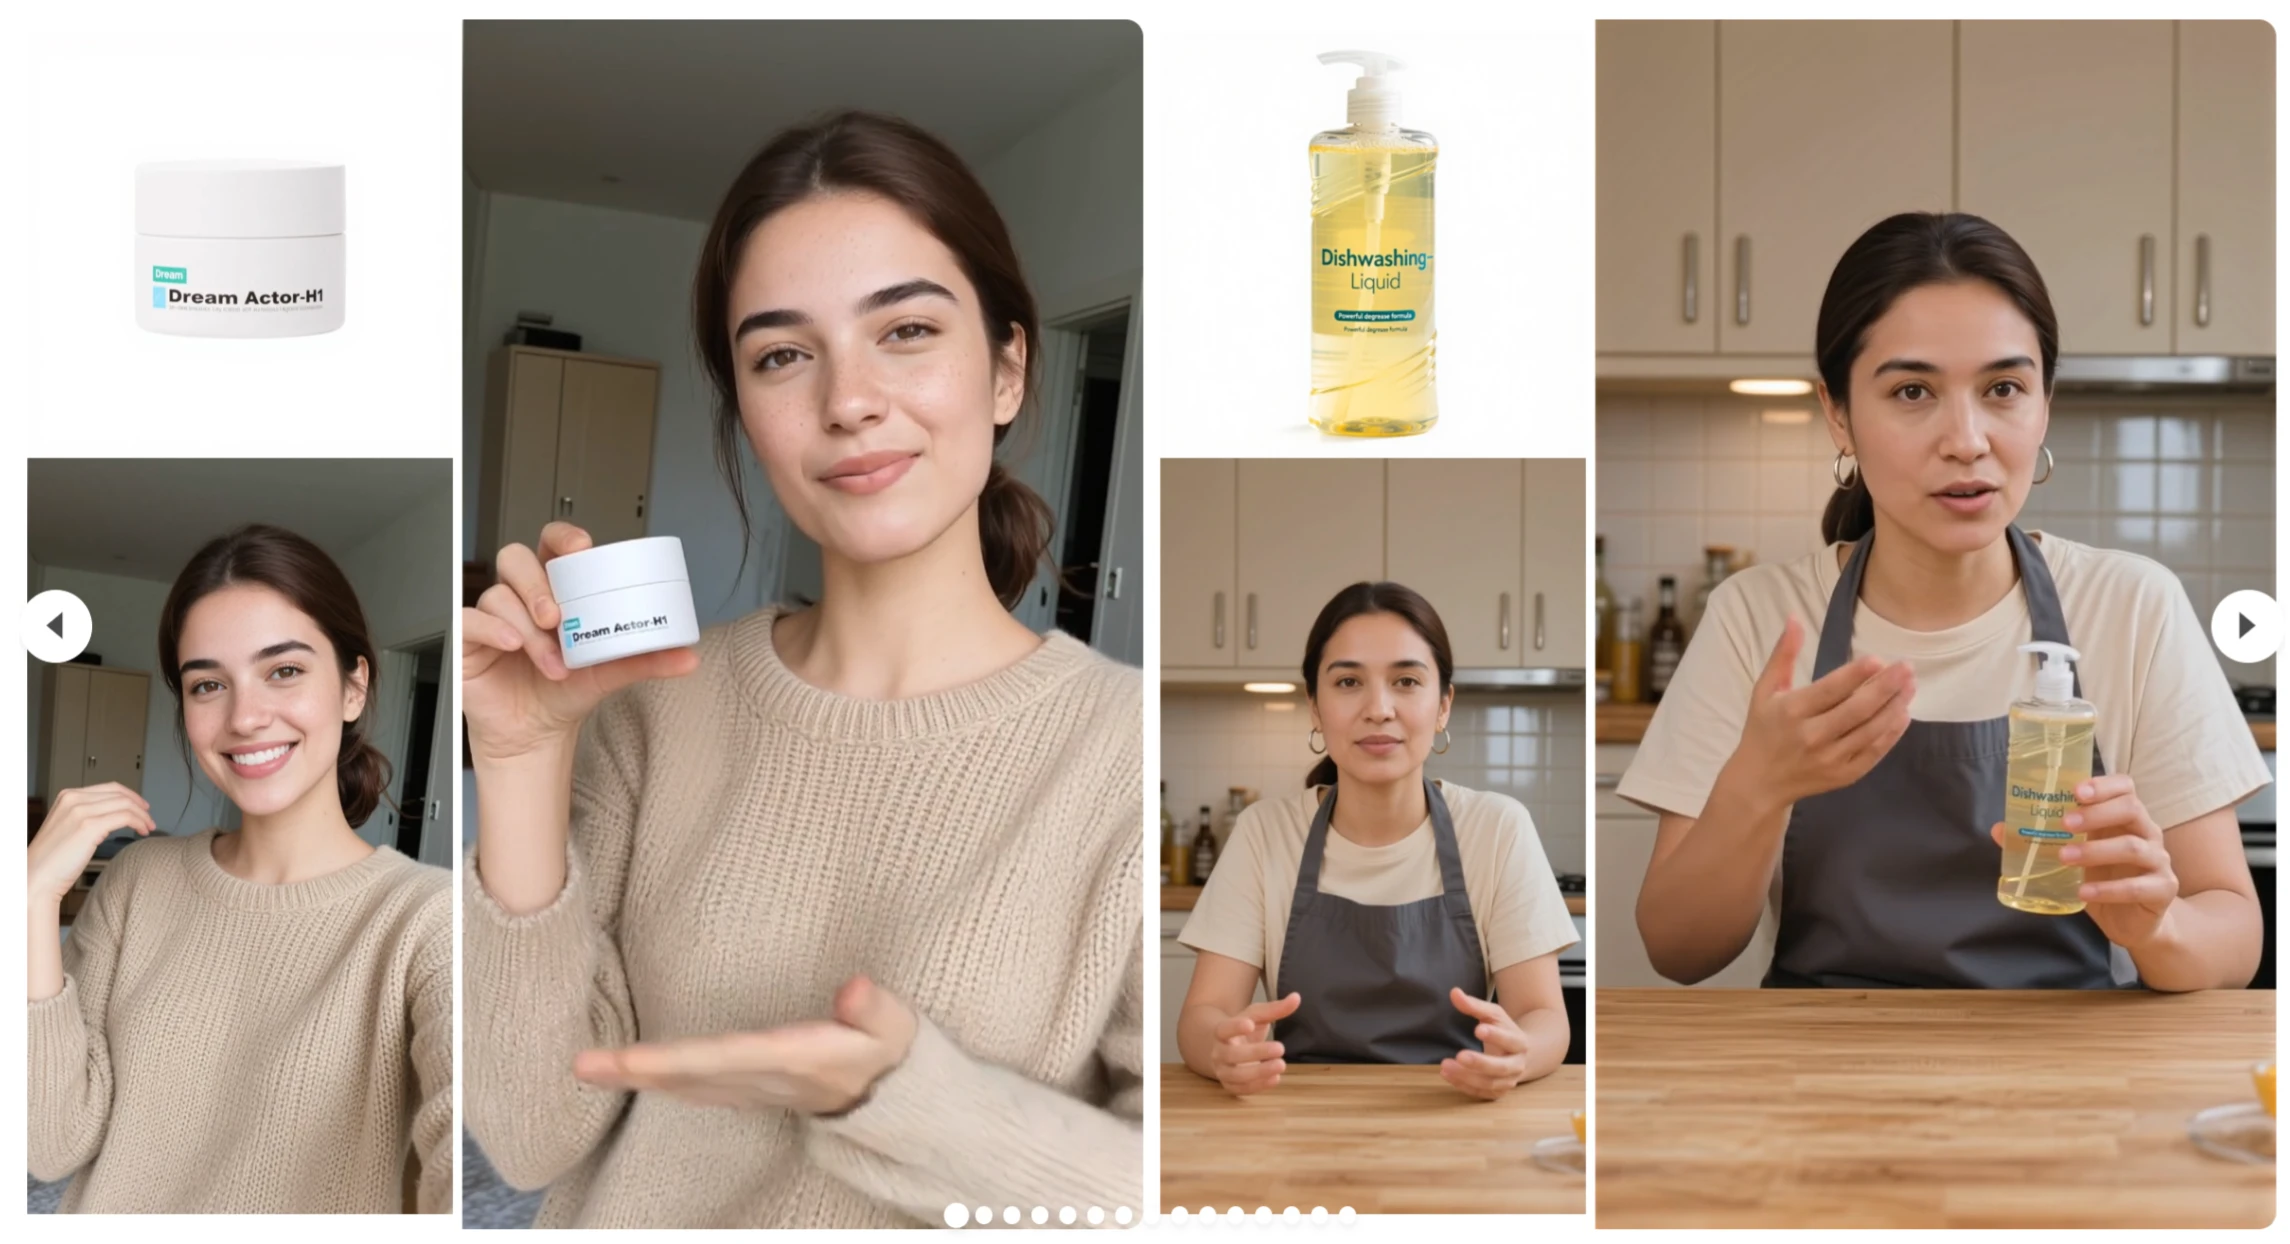
Die wichtigsten Vorteile von DreamActor-H1:
Dynamische Mensch-Objekt-Ausrichtung: Es kann Gesten und Produktpositionen automatisch aufeinander abstimmen. Beim Demonstrieren von „eine Kosmetik aufnehmen" etwa liegen die Berührungspunkte zwischen Fingern und Flasche natürlich auf, ohne Durchdringungen oder Verschiebungen. Zudem unterstützt es die gemeinsame Steuerung durch 3D-Körpernetzvorlagen und Produkt-Bounding-Boxen, sodass die Bewegungen physikalischen Gesetzen wie Schwerkraft und Greifwinkel entsprechen.
Mehrdimensionale Detailtreue: Bei der Wahrung der Identitätskonsistenz von Figuren bleiben Merkmale wie Frisur und Hautfarbe erhalten; bei Produkten werden Details wie Materialtexturen und Logos präzise wiedergegeben.
Semantisch verstärkte dreidimensionale Kohärenz: In Kombination mit kategoriebezogenen Textbeschreibungen, etwa „Lippenstift rotierend zeigen", wirken selbst kleinste Rotationsbewegungen flüssiger, sodass Produktzittern oder -verformungen vermieden werden.
Technische Prinzipien:
Datenverarbeitungsphase: Ein Vision-Language-Modell (VLM) analysiert die Textanweisungen, etwa „Handy in der Hand umdrehen". Anschließend wird durch Posenabschätzung ein menschliches Skelett erzeugt, das zusammen mit Produkt-Bounding-Boxen räumliche Beziehungen aufbaut, um Bewegungsmerkmale zu extrahieren.
Modellarchitektur-Design: Die globale Attention steuert die zeitliche Kohärenz des Gesamtbildes; die Referenz-Attention integriert Merkmale aus Referenzbildern von Personen oder Produkten; die Objekt-Attention verarbeitet speziell die latenten Merkmale von Produkten, damit keine Details verloren gehen. Der Diffusion-Transformer (DiT) mit dreifacher Attention basiert auf dem 7-Milliarden-Parameter-Basismodell Seaweed-7B und fusioniert Informationen zu Person und Objekt über maskierte Cross-Attention.
Inferenzoptimierung: Es greift dynamisch auf eine vordefinierte Bibliothek von Bewegungsvorlagen zu und passt den Skalierungsfaktor der Objekt-Boxen an, beispielsweise indem die Boxen kleiner Objekte vergrößert werden.
Anwendungsszenarien von DreamActor-H1:
E-Commerce-Livestreams: Es kann automatisch Demonstrationsvideos erzeugen, in denen virtuelle Moderatoren Produkte in den Händen halten, wodurch die Kosten für Livestreams gesenkt und deren Effizienz gesteigert werden.
Werbung und Marketing: Es ermöglicht die kostengünstige Erstellung von Produktanwendungsanimationen aus mehreren Blickwinkeln, etwa das rotierende Zeigen von Schuhmodellen, um die Aufmerksamkeit der Verbraucher zu gewinnen.
Einschränkungen von DreamActor-H1:
Produktbeschränkungen: Derzeit werden nur kleine und mittelgroße Gegenstände unterstützt; große Haushaltsgeräte und Ähnliches können nicht verarbeitet werden.
Abhängigkeit von Bewegungsvorlagen: Bewegungen wie „einen Gegenstand vom Tisch aufheben" müssen vordefiniert werden, und es besteht eine Abhängigkeit von der Übereinstimmung mit der initialen Personenpose.
Dynamische Artefakte: Bei schnellen Bewegungen können Produkttexturen flackern.
Ablauf zur Erstellung von Produktvorstellungsvideos mit DreamActor-H1:
Materialvorbereitung: Bereiten Sie ein Personenbild und ein Produktbild vor. Für das Personenbild empfiehlt sich eine frontale Halbaufnahme mit einer Auflösung von mehr als 800 × 800, damit die Personenmerkmale im erzeugten Video klar erkennbar sind. Das Produktbild sollte alle Details des Produkts deutlich zeigen, etwa Markenzeichen und Texturen.
Eingabe der Textanweisung: Geben Sie je nach Bedarf des Produktvorstellungsvideos kategoriebezogene Textbeschreibungen ein, beispielsweise „Handy in der Hand umdrehen" oder „Lippenstift-Details zeigen", um der Video-Generierung konkrete Bewegungs- und Präsentationsanforderungen zu liefern.
Video-Generierung: Geben Sie die vorbereiteten Materialien und Textanweisungen in das DreamActor-H1-System ein, das diese auf Basis einer mehrstufigen, kooperativen Architektur und eines hybriden Attention-Mechanismus verarbeitet. In der Datenverarbeitungsphase analysiert das Vision-Language-Modell (VLM) die Textanweisungen, während das Bewegungsmerkmal-Extraktionsmodul durch Posenabschätzung ein menschliches Skelett erzeugt und zusammen mit den Produkt-Bounding-Boxen räumliche Beziehungen aufbaut. In der Modellarchitektur arbeiten globale Attention, Referenz-Attention und Objekt-Attention zusammen, um schließlich ein hochauflösendes Demonstrationsvideo der Mensch-Computer-Interaktion zu erzeugen.
Projektadressen wie folgt:
Projekt-Hauptseite:https://submit2025-dream.github.io/DreamActor-H1/
Technisches Paper:https://arxiv.org/abs/2506.10568









