
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
TableRAG: Ein Retrieval-Augmented-Generation-Framework für das Tabellenverständnis
小编 ·

TableRAG: Ein Retrieval-Augmented-Generation-Framework für das Tabellenverständnis
TableRAG ist ein Framework zur Lösung der Probleme des Verlusts von Strukturinformationen und des fehlenden globalen Überblicks bei der Fragebeantwortung in heterogenen Dokumenten. Es kombiniert SQL-Ausführung und Textretrieval, kann Tabellendaten einheitlich verstehen und komplexe Operationen durchführen. Das Framework umfasst eine Offline-Datenbankerstellung und einen vierstufigen iterativen Online-Inferenzprozess. Auf dem neuen Benchmark HeteQA sowie anderen öffentlichen Benchmarks schneidet TableRAG hervorragend ab, übertrifft bestehende RAG- und programmatische Methoden und ist eine fortschrittliche Lösung für die Verarbeitung komplexer Inferenzen in heterogenen Dokumenten.
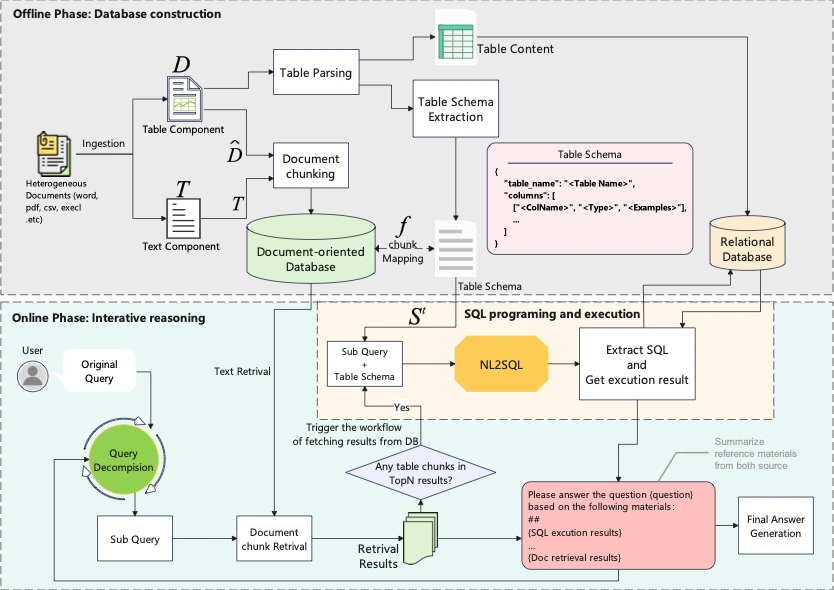
Kernprinzip
Query-Erweiterung und Retrieval: TableRAG lokalisiert Schlüsselinformationen in der Tabelle durch Query-Erweiterung, Schema-Retrieval und Zellen-Retrieval. Es generiert unabhängige Abfragen für Schema- und Zellenwerte und vermeidet so redundante Informationen, die durch einzelne Abfragen entstehen können.
Schema-Retrieval: Das ai-Sprachmodell kann über Spaltennamen Schlüsselspalten und deren Datentypen erkennen, ohne die gesamte Spalte kodieren zu müssen. Beispielsweise generiert das Sprachmodell für die Frage „Wie hoch ist der Durchschnittspreis einer Brieftasche?" Spaltennamen-Abfragen wie „Produkt" und „Preis".
Zellen-Retrieval: Basierend auf den vom Sprachmodell generierten Abfragen werden relevante Spaltennamen und Zellen zur Frage abgerufen. Beispielsweise das Abrufen von Zellenwerten im Zusammenhang mit „Brieftasche".
Frequenzbewusste Kürzung: Es wird ein Zellenkodierungsbudget B eingeführt. Übersteigt die Anzahl unterschiedlicher Werte B, werden nur die B häufigsten Werte kodiert.
TableRAGHauptmodule
online_inference/main.py: Der Kerninferenzcode von TableRAG, der die TableRAG-Klasse enthält und die Hauptlogik der Online-Inferenz implementiert.
offline_data_ingestion_and_query_interface/src/interface.py: Bietet mithilfe des Flask-Frameworks eine SQL-Abfrageschnittstelle.
online_inference/tools/sql_tool.py: Enthält Tool-Funktionen für SQL-Generierung und -Ausführung und unterstützt einen Wiederholungsmechanismus.
offline_data_ingestion_and_query_interface/src/sql_alchemy_helper.py: Stellt eine Hilfsklasse für SQLAlchemy-Datenbankoperationen bereit, die das Einfügen und Abfragen von Daten unterstützt.
offline_data_ingestion_and_query_interface/src/service.py: Die Kernlogik zur Verarbeitung von TableRAG-Anfragen, einschließlich des Abrufens von SQL-Anweisungen vom LLM und deren Ausführung.
online_inference/chat_utils.py: Enthält Tool-Funktionen zum Abrufen der vom LLM generierten Ergebnisse und unterstützt verschiedene API-Backends.
offline_data_ingestion_and_query_interface/src/data_persistent.py: Tool-Funktionen zum Bereinigen von DataFrame-Spaltennamen.
offline_data_ingestion_and_query_interface/src/handle_requests.py: Ruft die Inferenzschnittstelle des großen Modells auf und enthält Mechanismen zur Ausnahmebehandlung und exponentielles Backoff-Wiederholungen.
online_inference/tools/retriever.py: Implementiert semantisches Retrieval und hybrides Dokumenten-Retrieval, einschließlich Recall und Reranking.
Vorteile
Effiziente Datenkodierung: Durch Schema-Retrieval und Zellen-Retrieval reduziert TableRAG die Eingabelänge des Sprachmodells, sodass diese unabhängig von der Tabellengröße ist, was die Kodierungseffizienz verbessert und die Rechenkosten senkt.
Reduzierung von Informationsverlust: Dem Sprachmodell werden nur die abgerufenen Schemata und Zellen bereitgestellt, wodurch der Verlust wichtiger Informationen vermieden wird, der bei der Verarbeitung der gesamten Tabelle entsteht.
Verbesserte Inferenzfähigkeit: TableRAG verbessert die Tabelleninferenzfähigkeit des Sprachmodells, indem es wichtige Informationen bereitstellt.
TableRAGAnwendungsszenarien
Datenanalyse und Berichterstellung: Geeignet für Szenarien, die große Tabellendaten verarbeiten müssen, wie Datenanalyse, Berichterstellung und Verarbeitung von Finanzberichten.
Tabellenübergreifende Fragebeantwortung: Kann Aufgaben wie tabellenbasierte Faktenüberprüfung sowie ein- und mehrsprunghafte Tabellenfragebeantwortung bewältigen.
Experimentelle Validierung
Die Forscher entwickelten einen Benchmark im Millionen-Token-Bereich, basierend auf den Datensätzen Arcade und BIRD-SQL, um die Leistung von TableRAG bei großskaligen Tabellenverständnisaufgaben zu bewerten. Die experimentellen Ergebnisse zeigen, dass TableRAG bestehende Methoden hinsichtlich Retrieval-Qualität und Leistung beim großskaligen Tabellenverständnis übertrifft.
Projektlink
Github:https://github.com/yxh-y/TableRAG









