
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Nanonets-OCR-s: Ein Modell, das Tabellen in Bildern in Markdown umwandelt
小编 ·

Nanonets-OCR-s: Ein Modell, das Tabellen in Bildern in Markdown umwandelt
Was ist Nanonets-OCR-s?
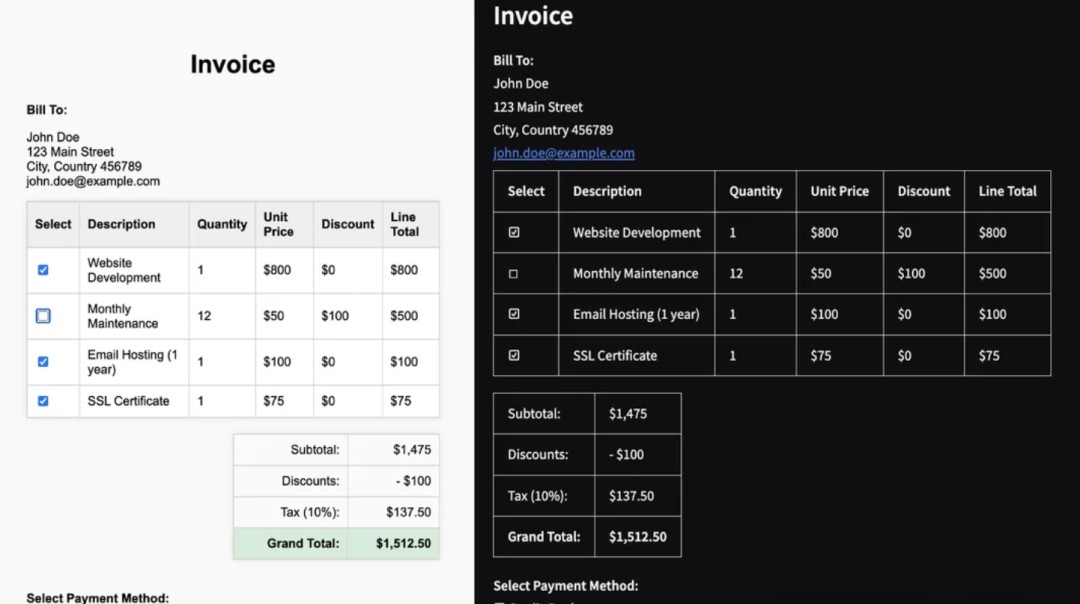
Nanonets-OCR-s kann Tabellen aus Bildern in das Markdown-Format umwandeln und erkennt außerdem LaTeX-Syntax. Es kann zudem die Position von Bildern erkennen und sie in -Tags umwandeln. Unterschriften werden in
Funktions-Highlights
Tabellenkonvertierung: Kann komplexe Tabellen präzise extrahieren und sie in klar strukturierte Formate wie Markdown und HTML umwandeln.
Formelerkennung: Kann mathematische Formeln in Dokumenten präzise in LaTeX-Syntax umwandeln – sowohl Inline-Formeln als auch eigenständige Formeln lassen sich mühelos verarbeiten.
Bildverarbeitung: Erkennt automatisch Bilder in Dokumenten und beschreibt sie mit
-Tags, was die Weiterverarbeitung erleichtert.
Extraktion von Unterschriften und Wasserzeichen: Kann Unterschriften und Wasserzeichen in Dokumenten erkennen und sie entsprechend mit den Tags
und kennzeichnen. Verarbeitung von Kontrollkästchen: Wandelt Kontrollkästchen und Optionsfelder in Dokumenten in standardmäßige Unicode-Symbole um, was das Lesen und Bearbeiten erleichtert.
Nutzungsweise
Über die Python-Bibliothek:
Installieren der erforderlichen Bibliotheken (z. B. transformers usw.).
Laden des vortrainierten Modells, anschließend Verarbeiten des Bildes und Extrahieren der Inhalte.
Über die Server-Schnittstelle:
Starten Sie den Server, senden Sie Anfragen über Python und entsprechende Clients und erhalten Sie die Konvertierungsergebnisse.
Über vereinfachte Werkzeuge:
Verwenden Sie Tools wie docext, um die Anwendung mit einem Klick zu starten und den Arbeitsablauf zu vereinfachen.
Einsatzszenarien
Wissenschaftliche Forschung: Schnelle Umwandlung von Formeln, Abbildungen und Tabellen in wissenschaftlichen Arbeiten in ein bearbeitbares Markdown-Format, was das Strukturieren und die weitere Forschung erleichtert.
Geschäftsalltag: Verarbeitung von Verträgen, Berichten und anderen Dokumenten, Extraktion wichtiger Informationen bei gleichzeitiger Beibehaltung eines einheitlichen Formats zur Steigerung der Arbeitseffizienz.
Juristischer Bereich: Erkennung und Isolierung wichtiger Elemente wie Unterschriften und Wasserzeichen, um die Vollständigkeit und Genauigkeit von Dokumenten sicherzustellen.
Vorteile
Leistungsstarke Funktionen: Erkennt eine Vielzahl von Dokumentelementen und erfüllt die Anforderungen unterschiedlicher Szenarien.
Intelligent und effizient: Durch intelligente Erkennung und semantische Markierung sind die Ausgabeinhalte leichter zu verarbeiten.
Leichtgewichtig und praktisch: Das Modell hat eine moderate Größe, wurde auf Basis bestehender Technologien optimiert und unterstützt Chinesisch.
Projektadresse
https://huggingface.co/nanonets/Nanonets-OCR-s









