
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
VRAG-RL: Ein RAG-Framework auf Basis visueller Wahrnehmung vom Tongyi-Team von Alibaba
小编 ·

VRAG-RL: Ein RAG-Framework auf Basis visueller Wahrnehmung vom Tongyi-Team von Alibaba
Was ist VRAG-RL?
VRAG-RL ist ein kürzlich vom Alibaba Tongyi-Team vorgestelltes Modell, das auf einem visuell wahrnehmungsbasierten RAG-Framework basiert. Dieses Modell steigert die Leistung auf Qwen2.5-VL-3B um 30 % und auf Qwen2.5-VL-7B um 20 %.
VRAG-RL wird durch bestärkendes Lernen trainiert und stattet das Modell mit der Fähigkeit zu mehrstufigem Denken und Schlussfolgern aus. Dadurch wird das Verständnis für visuelle Sprachmodelle (VLM) sowie die Genauigkeit der Antworten schrittweise verbessert. Es definiert einen visuellen Wahrnehmungs-Aktionsraum, der es dem Modell ermöglicht, sich schrittweise von grob nach fein auf informationsdichte Bereiche zu konzentrieren, Schlüsselinformationen präzise aus den Bildern zu extrahieren und die Fähigkeiten des VLM beim Abrufen, Schlussfolgern und Verstehen visueller Informationen zu verbessern.
Darüber hinaus verfügt VRAG-RL über multimodale Abruf- und iterative Schlussfolgerungsfähigkeiten. Durch mehrstufige Interaktion wird das Verständnis visueller Informationen schrittweise verfeinert, sodass am Ende genaue und umfassende Antworten erzeugt werden. Es eignet sich für verschiedene visuelle Aufgaben wie Bildverstehen, Diagramm-Analyse und das Parsen komplexer Layouts.
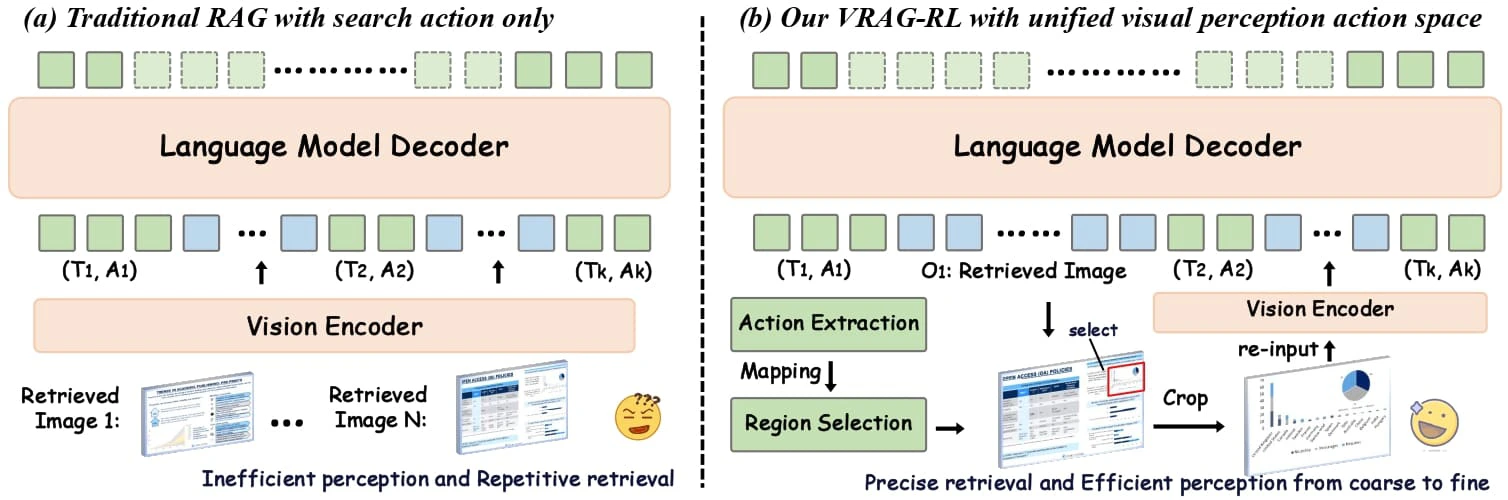
Grenzen herkömmlicher RAG-Methoden
Unzureichende Fähigkeit zur Verarbeitung visueller Informationen: Bildinhalte können nicht effektiv analysiert werden, da das Verständnis und die Schlussfolgerungsfähigkeit für visuelle Daten fehlen.
Feste Abläufe schränken dynamisches Schlussfolgern ein: Meist wird ein festgelegter Abruf-Generierungs-Ablauf verwendet, der es erschwert, den Schlussfolgerungspfad in komplexen Aufgaben dynamisch anzupassen, wodurch die Fähigkeit des Modells, visuelle Informationen zu erschließen, begrenzt wird.
Unzureichende Abrufeffizienz und Schlussfolgerungstiefe: Bei komplexen visuellen Aufgaben können Schlüsselinformationen oft nicht effizient lokalisiert werden, was zu ungenauen Ergebnissen führt.
Kerninnovationen von VRAG-RL
Visueller Wahrnehmungs-Aktionsraum: Durch die Einführung verschiedener visueller Wahrnehmungsaktionen wie Bereichsauswahl, Zuschneiden und Zoomen kann sich das Modell schrittweise von grob nach fein auf informationsdichte Bereiche konzentrieren und Schlüsselinformationen aus Bildern präzise extrahieren. Diese Vorgehensweise von grob nach fein verbessert nicht nur das Verständnis visueller Informationen, sondern steigert auch deutlich die Abrufeffizienz.
Framework für bestärkendes Lernen: Optimierung der Schlussfolgerungs- und Abruffähigkeiten des Modells durch bestärkendes Lernen (RL). Das Modell interagiert über mehrere Runden mit der Suchmaschine, sampelt eigenständig ein- oder mehrstufige Schlussfolgerungspfade und optimiert kontinuierlich auf Basis dieser Stichproben.
Umfassender Belohnungsmechanismus: Es wurde eine umfassende Belohnungsfunktion entwickelt, die eine Belohnung für die Abrufeffizienz, eine Belohnung für die Musterkonsistenz und eine modellbasierte Ergebnisbelohnung umfasst. Dieser Belohnungsmechanismus berücksichtigt das Endergebnis, optimiert den Abrufprozess und ermöglicht es dem Modell, relevantere Informationen effektiver zu gewinnen.
Multi-Experten-Sampling-Strategie: Kombination der Schlussfolgerungsfähigkeit großer Modelle mit der präzisen Annotationsfähigkeit von Expertenmodellen, damit das Modell effektivere Strategien zur visuellen Wahrnehmung erlernen kann.
Mehrstufiges Interaktionstraining: Basierend auf einer Trainingsstrategie mit mehrstufiger Interaktion optimiert das Modell den Schlussfolgerungsprozess durch kontinuierliche Interaktion mit der externen Umgebung schrittweise, was die Stabilität und Konsistenz der Schlussfolgerungen verbessert.
Technische Vorteile von VRAG-RL
Leistungssteigerung: Die experimentellen Ergebnisse zeigen, dass VRAG-RL auf mehreren visuellen Sprach-Benchmark-Datensätzen deutlich bessere Leistungen als bestehende Methoden erzielt. Die Aufgabentypen reichen von Single-Hop- bis Multi-Hop-Schlussfolgern, von reinem Textverständnis bis hin zu Diagrammerkennung und dem Parsen komplexer Layouts in verschiedensten visuell reichhaltigen Szenarien.
Unterstützung mehrstufiger Interaktion: Während der Schlussfolgerungsphase kann sich das Modell schrittweise auf informationsdichte Bereiche konzentrieren und so eine Informationsgewinnung von grob nach fein erreichen.
Effizientes Training: Durch die Einführung des branchenführenden GRPO-Algorithmus und die lokale Bereitstellung einer Suchmaschine zur Simulation realer Anwendungsszenarien entfallen die Kosten für Suchmaschinenaufrufe, sodass das Modelltraining deutlich effizienter wird.
Anwendungsszenarien von VRAG-RL
Analyse komplexer Diagramme: Extraktion wichtiger Daten aus Finanzberichten und wissenschaftlichen Diagrammen.
Analyse von Designentwürfen: Verstehen und Schlussfolgern von Layouts und Elementen in Designentwürfen.
Dokumentenabruf: Effizientes Auffinden von Informationen in Dokumenten-Wissensdatenbanken, die Bilder und Tabellen enthalten.
Multimodale Fragebeantwortung: Kombination von Text und Bild für Multi-Hop-Schlussfolgern, um komplexe Fragen zu beantworten.
Projektlinks
GitHub-Repository:https://github.com/Alibaba-NLP/VRAG
HuggingFace-Modellbibliothek:https://huggingface.co/collections/autumncc/vrag-rl
arXiv-Technische Abhandlung:https://arxiv.org/pdf/2505.22019









