
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Alibaba veröffentlicht QwenLong-L1-32B: ein LLM für Long-Context-Reasoning
小编 ·

Alibaba veröffentlicht QwenLong-L1-32B: ein LLM für Long-Context-Reasoning
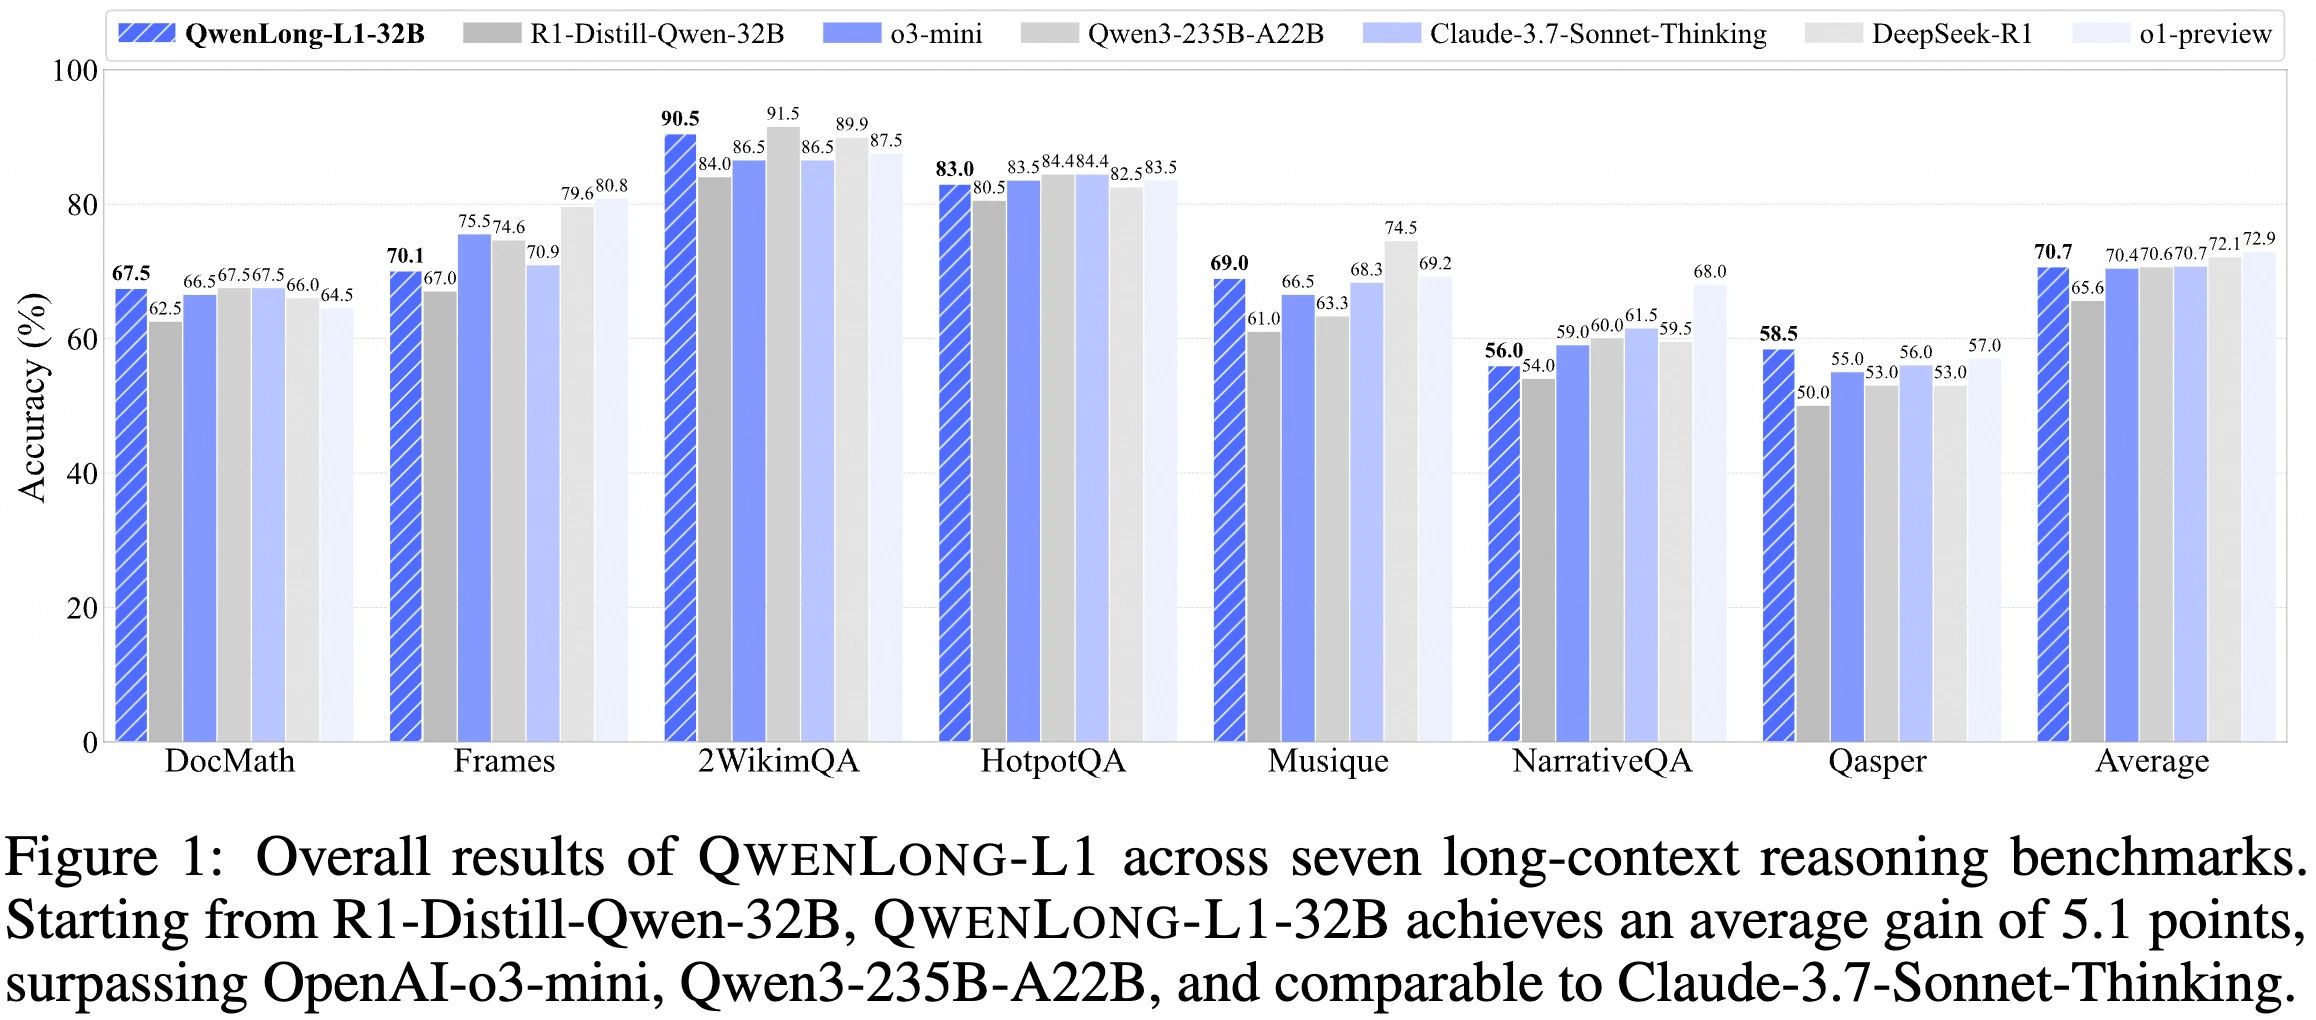
Am 26. Mai 2025 veröffentlichte das Alibaba-Team QwenLong-L1-32B, das erste auf Reinforcement Learning basierende Large Reasoning Model für lange Kontexte, sowie den DocQA-RL-1.6K-Datensatz (mit 1600 Dokument-Frage-Antwort-Aufgaben aus den Bereichen Mathematik, Logik und Multi-Hop-Reasoning). Sein Framework löst durch Warm-up Supervised Fine-Tuning, kursbasiertes Reinforcement Learning und einen schwierigkeitsbewussten Retrospektiv-Sampling-Mechanismus die Herausforderungen geringer Trainingseffizienz und instabiler Optimierungsprozesse beim Reinforcement Learning für Long-Context-Reasoning. In 7 Long-Context-DocQA-Benchmark-Tests übertrifft es in der Leistung Openai-o3-mini und Qwen3-235B-A22B und ist vergleichbar mit Claude-3.7-Sonnet-Thinking.
Modell-Framework
Kernidee: Anpassung von Large Reasoning Models (LRMs) mit kurzem Kontext an Szenarien mit langem Kontext durch Reinforcement Learning (RL).
Hauptkomponenten:
Warm-up Supervised Fine-Tuning (SFT)-Phase: Aufbau einer robusten Ausgangsstrategie.
Kursbasierte, stufenweise Reinforcement-Learning-Technik: Stabilisierung der Strategieentwicklung.
Schwierigkeitsbewusste Retrospektiv-Sampling-Strategie: Förderung der Strategieexploration.
Trainingsdaten
Es wurde ein speziell für das Reinforcement Learning erstellter Trainingsdatensatz namens DocQA-RL-1.6K verwendet, der 1600 Dokument-Frage-Antwort-Aufgaben aus den Bereichen Mathematik, Logik und Multi-Hop-Reasoning enthält.
Leistung
In sieben Long-Context-Dokument-Frage-Antwort-Benchmark-Tests übertrifft QwenLong-L1-32B Flaggschiff-LRMs wie OpenAI-o3-mini und Qwen3-235B-A22B und erreicht ein mit Claude-3.7-Sonnet-Thinking vergleichbares Niveau, was eine führende Leistung unter den aktuell modernsten LRMs darstellt.
Experimentelles Design
Es wurde ein spezieller RL-Trainingsdatensatz, DocQA-RL-1.6K, erstellt, der 1600 Dokument-Frage-Antwort-Aufgaben aus den Bereichen Mathematik, Logik und Multi-Hop-Reasoning enthält.
Für den Bereich mathematisches Reasoning wurden 600 Aufgaben aus dem DocMath-Datensatz verwendet, von denen 75 % für das Training und 25 % für die Evaluierung genutzt wurden.
Für den Bereich logisches Reasoning wurden mittels DeepSeek-R1 600 Multiple-Choice-Aufgaben synthetisiert, die Dokumente aus den Bereichen Recht, Finanzen, Versicherungen und Produktion abdecken.
Für den Bereich Multi-Hop-Reasoning wurden jeweils 200 Beispiele aus MultiHopRAG und Musique entnommen, mit Schwerpunkt auf dokumentübergreifendem Reasoning.
Die Evaluierung erfolgte an sieben Long-Context-DocQA-Benchmarks, darunter 2WikiMultihopQA, HotpotQA, Musique, NarrativeQA, Qasper, Frames und DocMath.
Ergebnisse und Analyse
QwenLong-L1-32B schneidet in sieben Long-Context-DocQA-Benchmark-Tests hervorragend ab, übertrifft Flaggschiff-LRMs wie OpenAI-o3-mini und Qwen3-235B-A22B und ist vergleichbar mit Claude-3.7-Sonnet-Thinking.
Auf dem Mathematik-Reasoning-Benchmark DocMath erreicht QwenLong-L1-32B eine Exact-Match- und LLM-Beurteilungsgenauigkeit von 85,3 %.
Auf dem Multi-Hop-Reasoning-Benchmark HotpotQA erreicht das Modell eine Leistung von 87,6 % und übertrifft bestehende Modelle deutlich.
Projekt-Links
Github:https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface:https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope:https://www.modelscope.cn/models/iic/QwenLong-L1-32B









