
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ParseStudio: eine Python-Bibliothek zur Vereinfachung des PDF-Parsings
小编 ·

ParseStudio: eine Python-Bibliothek zur Vereinfachung des PDF-Parsings
Was ist ParseStudio?
Bei der Verarbeitung von PDF-Dokumenten ist das Extrahieren von Text, Tabellen und Bildern oft mühsam, und die unterschiedliche Verwendung verschiedener Bibliotheken macht den Code repetitiv und schwer zu verwalten. ParseStudio ist eine Python-Bibliothek, die einen vereinfachten Ansatz bietet, indem sie mehrere Parser in einer einheitlichen Schnittstelle zusammenführt, sodass Benutzer PDF-Dokumente mit nur wenigen Codezeilen analysieren können. Die Bibliothek integriert die drei Engines Docling, PyMuPDF und Llama Parse und kann flexibel Texte, Tabellen und Bilder extrahieren. Die Hauptmerkmale von ParseStudio sind: modulares Design, gleichzeitige Extraktion verschiedener Inhaltstypen, eine übersichtliche API, automatische Umwandlung von Tabellen in das Markdown-Format, Einbeziehung von Metadaten beim Extrahieren von Bildern sowie Unterstützung der Stapelverarbeitung mehrerer PDF-Dateien. Für Entwickler mit soliden Python-Grundlagen ist ParseStudio ein nützliches Werkzeug.
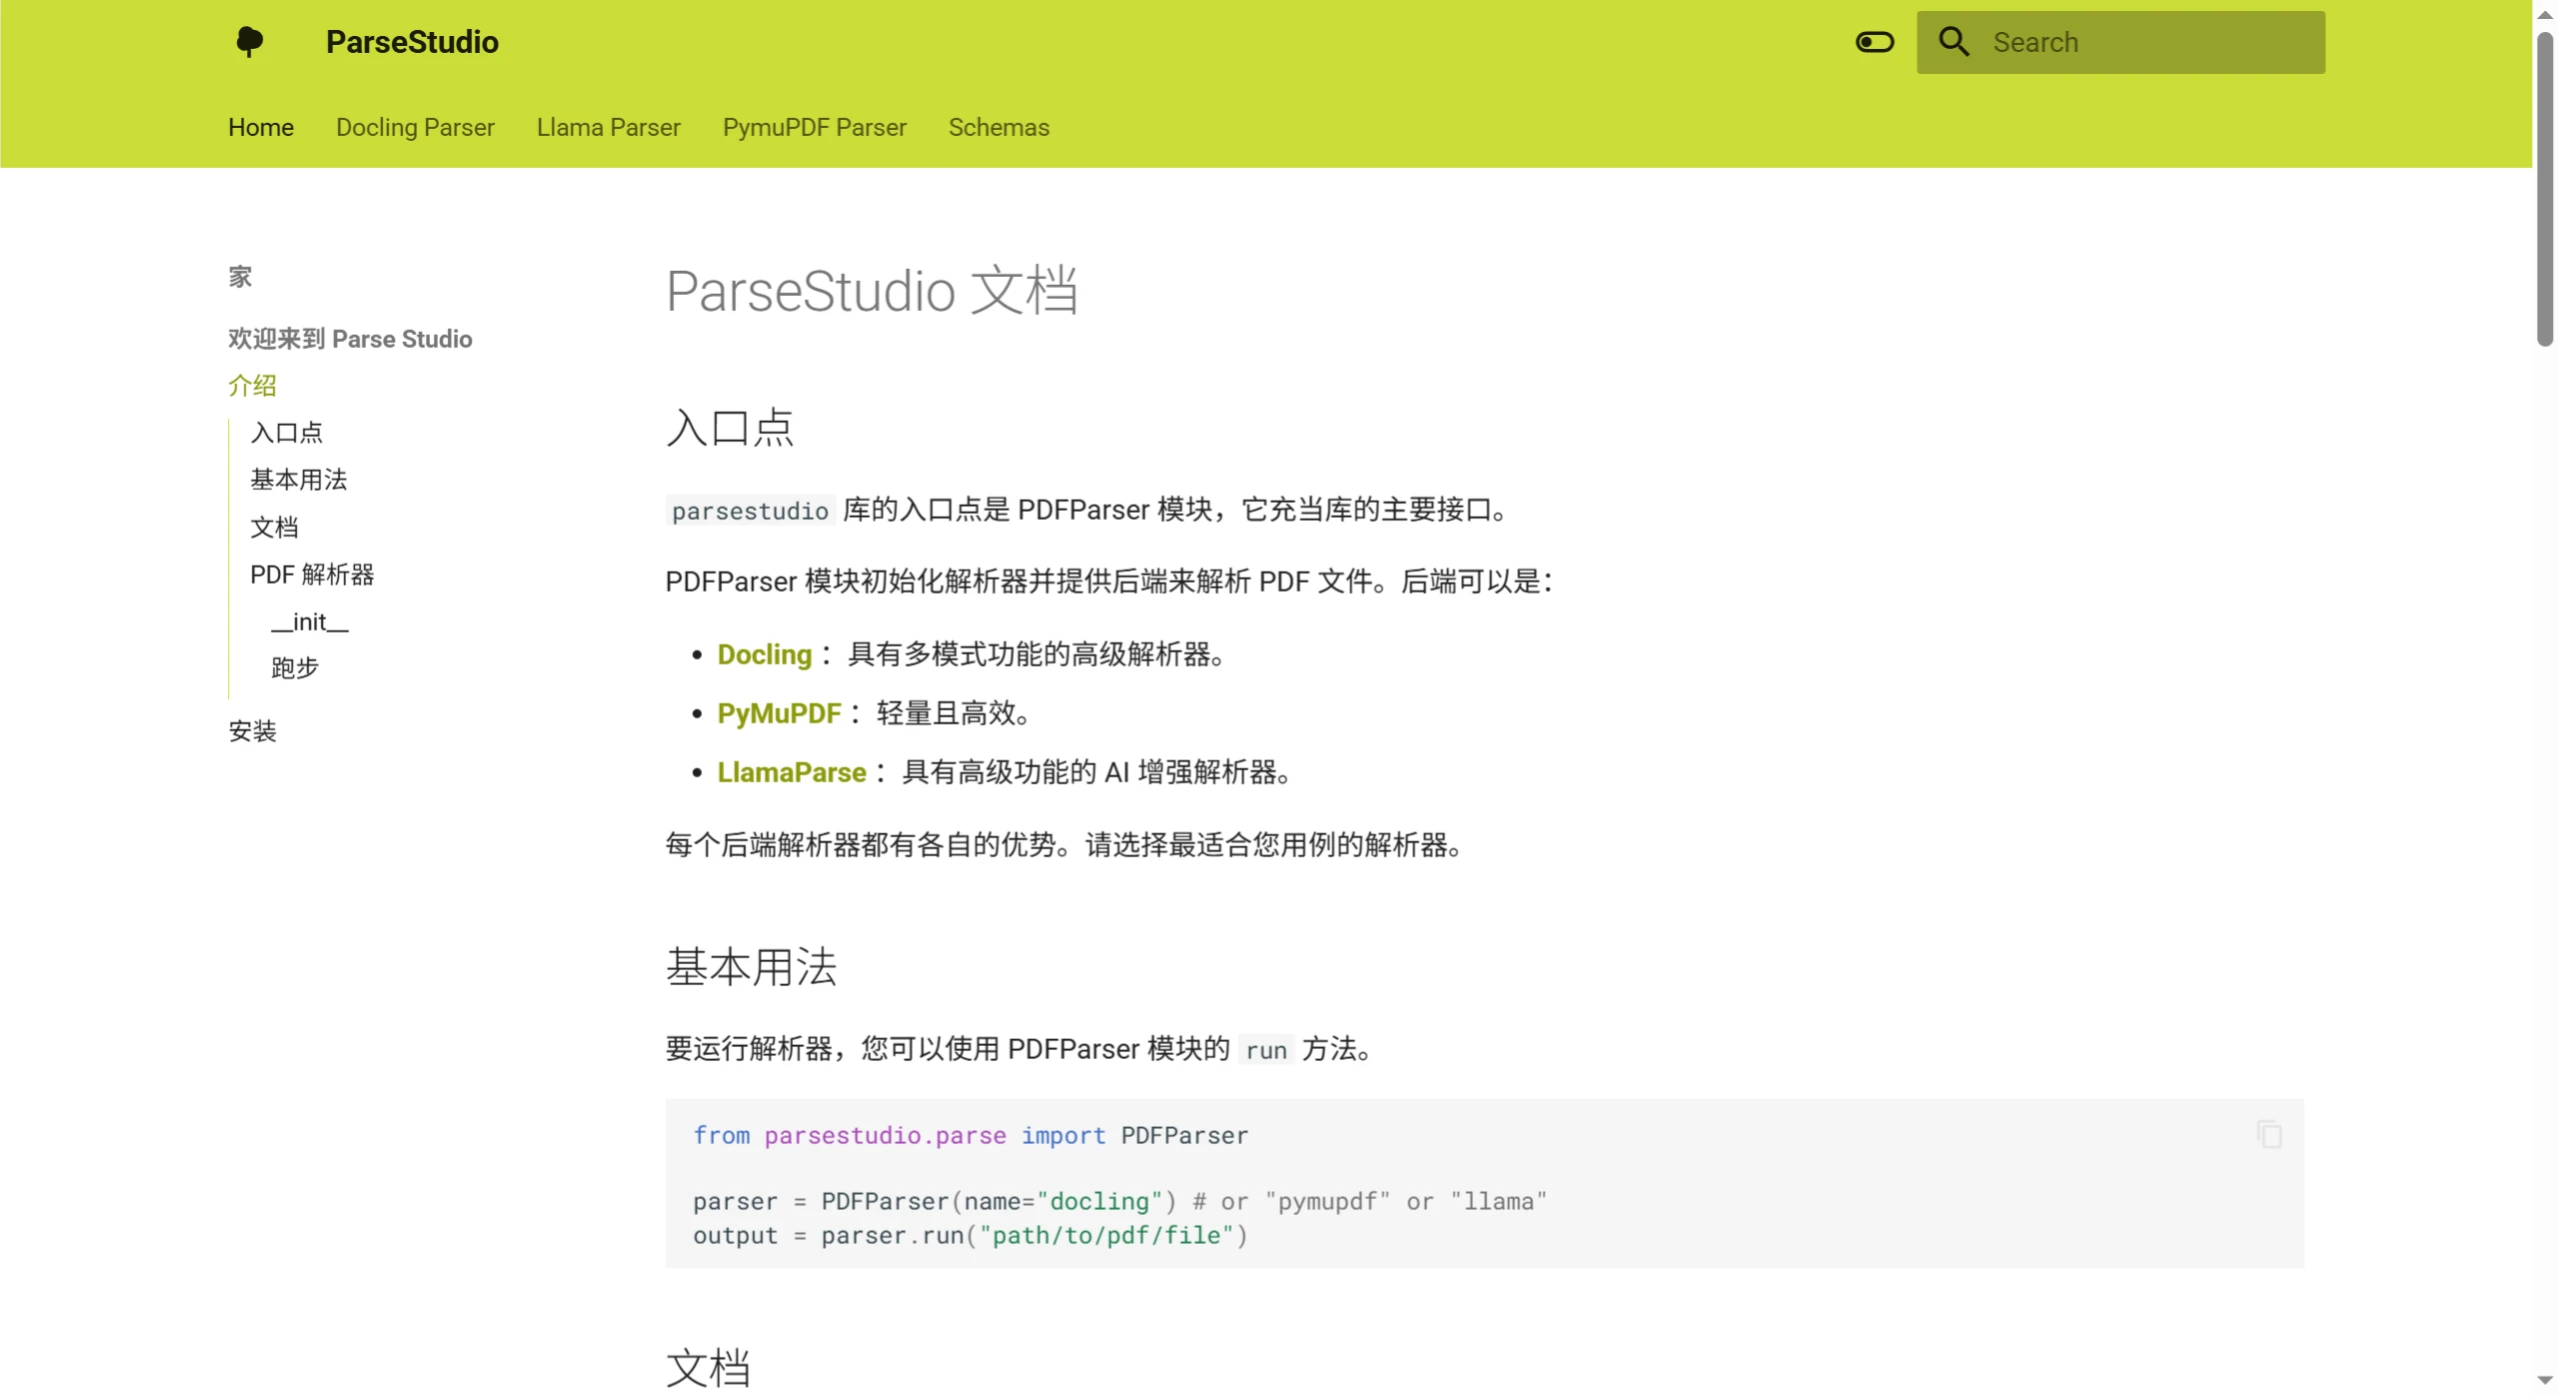
Hauptmerkmale von ParseStudio
Modulares Design: Es können verschiedene Parser-Backends wie Docling, PyMuPDF und Llama Parse ausgewählt werden, um unterschiedlichen Anforderungen gerecht zu werden.
Multimodale Analyse: Nahtlose Extraktion von Text, Tabellen und Bildern.
Einheitliche Syntax: Durch die Bereitstellung einer einheitlichen Schnittstelle wird die Interaktion mit verschiedenen Backends vereinfacht.
Erweiterbarkeit: Das Parser-Verhalten kann einfach über zusätzliche Parameter angepasst werden.
Benutzerfreundlich: Backend-spezifische Komplexität wird abstrahiert, sodass sich der Benutzer auf die Inhaltsextraktion konzentrieren kann.
Installation von ParseStudio
Installation mit pip:
pip install parsestudio
Installation aus dem Quellcode:
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
Schnellstart mit ParseStudio
Importieren und Initialisieren des Parsers:
from parsestudio.parse import PDFParser
# Initialisieren mit dem gewünschten Parser-Backend
parser = PDFParser(parser="docling")  # Optionen: "docling", "pymupdf", "llama"
PDF-Datei parsen:
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# Auf den Textinhalt zugreifen
print(outputs[0].text)
# Auf Tabellen zugreifen
for table in outputs[0].tables:
print(table.markdown)
# Auf Bilder zugreifen
for image in outputs[0].images:
image.image.show()
metadata = image.metadata
print(metadata)
Unterstützte Parser
Docling: Geeignet für die detaillierte Layout-Analyse komplexer Dokumente, unterstützt OCR und präzise Tabellenextraktion.
PyMuPDF: Leichtgewichtig und effizient, ideal für die schnelle Verarbeitung.
LlamaParse: Cloud-basierte und KI-gestützte Extraktion, ideal für Szenarien, die erweiterte Funktionen erfordern.
Github:https://github.com/chatclimate-ai/ParseStudio









