
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
AniSora: quelloffenes Animationsvideo-Generierungsmodell von Bilibili
小编 ·

AniSora: quelloffenes Animationsvideo-Generierungsmodell von Bilibili
AniSora – Was ist das?
AniSora ist ein von Bilibili am 12. Mai 2025 als Open Source veröffentlichtes KI-Animationsvideo-Generierungssystem. Es kann problemlos Anime-Videos in verschiedenen Stilen erzeugen, zum Beispiel Anime-Folgen, chinesische Originalanimationen, Manga-Adaptionen, VTuber-Inhalte, Anime-PVs sowie Guyin-Videos (parodistische Remix-Videos). Das System leistet gute Arbeit dabei, die Konsistenz des Charakterasussehens und die Geschmeidigkeit der Bewegungen beizubehalten, und gilt derzeit als eines der fortschrittlichsten Videogenerierungsmodelle für Animationen.
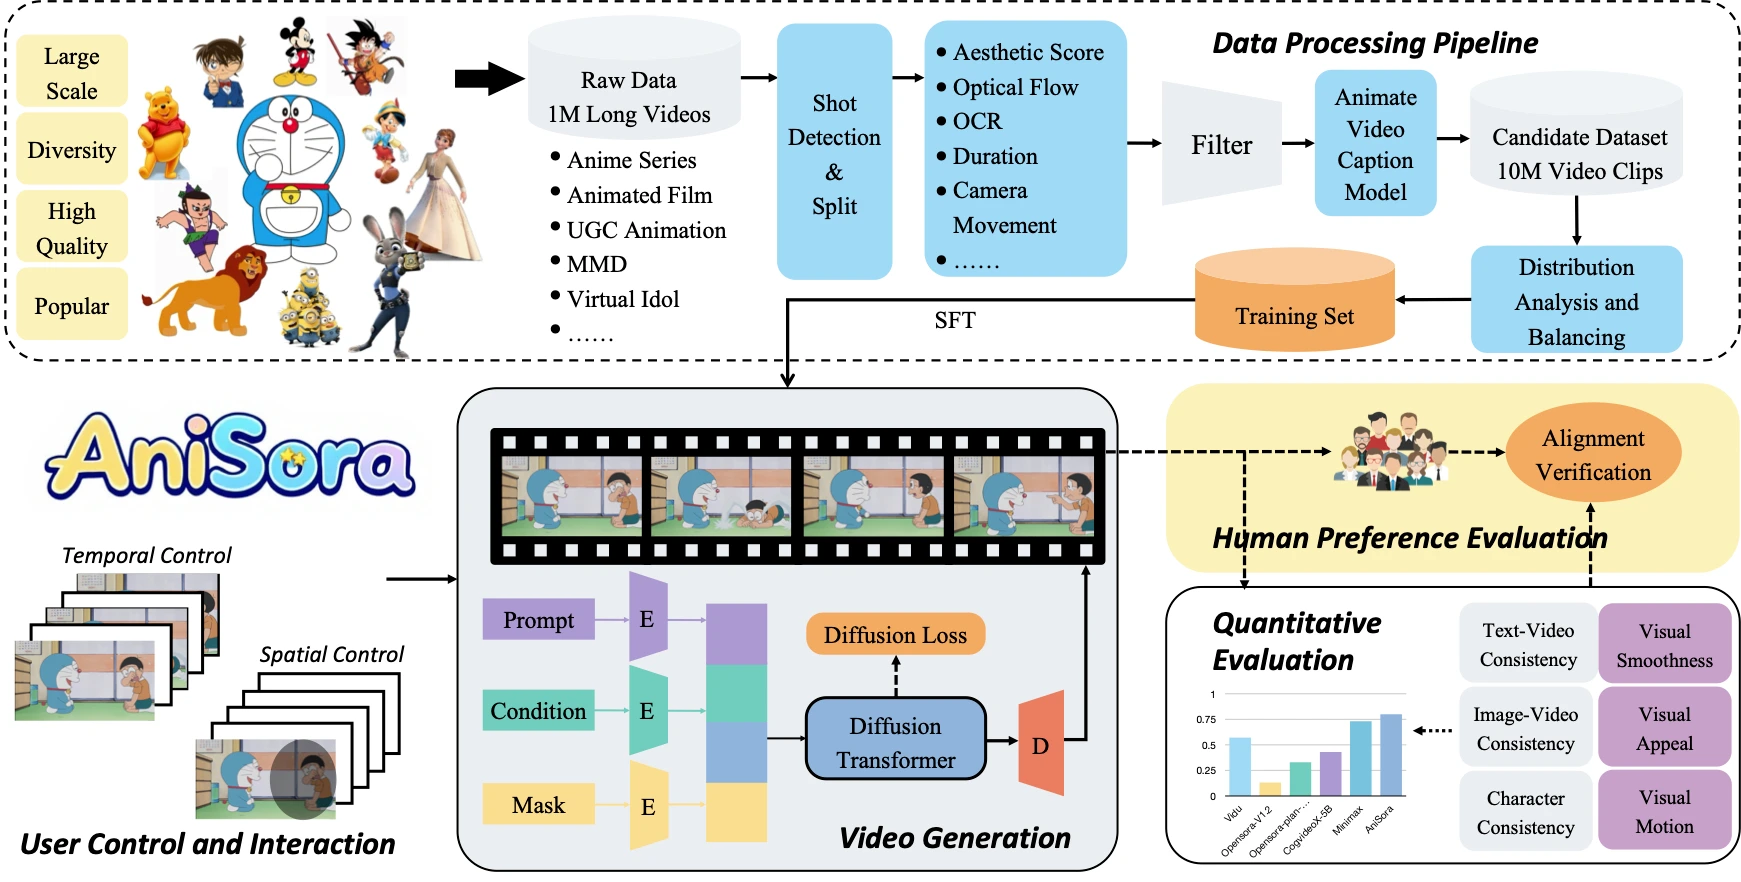
Funktionen von AniSora
Bild-zu-Video-Generierung: Erzeugt aus einem einzigen Bild ein zusammenhängendes animiertes Video und eignet sich damit, statische Szenen in dynamische Szenen zu erweitern.
Frame-Interpolation: Unterstützt die Interpolation von Keyframes, indem Zwischenbilder erzeugt werden, um weiche Übergänge zu realisieren und den manuellen Zeichenaufwand bei der Animation zu reduzieren.
Lokale Bildführung: Ermöglicht es Benutzern, bestimmte Bereiche für die Animationsgenerierung festzulegen.
Raumzeitliche Steuerung: Kombiniert zeitliche und räumliche Steuerungsmöglichkeiten und unterstützt unter anderem die Führung durch das erste Bild, das letzte Bild sowie mehrere Frames, um eine präzise Animation zu ermöglichen.
Modelleigenschaften von AniSora
Zielgerichtete Optimierung: Im Vergleich zu natürlichen Videos weisen Anime-Videos einen expressiveren und abstrakteren Stil auf. Herkömmliche Generierungsmodelle haben oft Schwierigkeiten, den Gesichtsausdruck der Charaktere, den Bewegungsrhythmus sowie die übertriebene Bildsprache präzise zu reproduzieren. AniSora wurde gezielt für diese Eigenschaften optimiert, mit dem Ziel, die Effizienz der Videogenerierung zu steigern, ohne den kreativen Ausdruck zu opfern.
Unterstützung vielfältiger Stile: Kann mit einem Klick Videoclips in unterschiedlichen Stilen erzeugen, darunter Serienfolgen, chinesische Originalanimationen, Manga-Adaptionen, VTuber-Inhalte, Anime-PVs und sogar Guyin-Kreationen.
Niedrige Einstiegshürde: Für Einzelpersonen oder Studios mit konkretem Produktionsbedarf ist AniSora ein äußerst attraktives Werkzeug.
Kernmodule von AniSora
Datenverarbeitungs-Pipeline: Es wurden über 10 Millionen qualitativ hochwertige Text-Video-Datenpaare vorverarbeitet, die eine solide Trainingsgrundlage bieten.
Steuerbares Generierungsmodell: Ein raumzeitliches Maskierungsmodul wird eingeführt, das Bild-zu-Video, Keyframe-Interpolation, lokale Bildführung und weitere Funktionen unterstützt und sich an verschiedene kreative Anforderungen anpassen lässt.
Evaluierungssystem: Es wurde ein Bewertungsdatensatz mit 948 vielfältigen Animationsclips aufgebaut, der in Kombination mit doppelblinder menschlicher Bewertung und dem VBench-Bewertungssystem die Charakterkonsistenz, die Bewegungsübergänge und weitere Dimensionen beurteilt.
Technische Prinzipien von AniSora
Diffusionsmodell (Diffusion Model): Basiert auf einer Diffusionsmodell-Architektur, die schrittweise Rauschen entfernt, um qualitativ hochwertige Videoinhalte zu erzeugen.
Raumzeitliches Maskierungsmodul (Spatiotemporal Mask Module): Ermöglicht es dem Modell, während des Generierungsprozesses bestimmte zeitliche und räumliche Bereiche zu steuern, etwa durch Masken festzulegen, welche Frames oder welche Bereiche animiert werden sollen, und unterstützt so lokale Führung und Keyframe-Interpolation.
3D Causal Variational Autoencoder (3D Causal VAE): Wird verwendet, um die raumzeitlichen Merkmale des Videos zu kodieren und zu dekodieren, das Video in einen niedrigdimensionalen latenten Raum zu komprimieren, die Rechenkomplexität zu reduzieren und gleichzeitig die wesentlichen raumzeitlichen Informationen zu erhalten.
Transformer-Architektur: Kombiniert die leistungsstarken Modellierungsfähigkeiten des Transformers und erfasst mithilfe des Aufmerksamkeitsmechanismus komplexe raumzeitliche Abhängigkeiten im Video, sodass das Modell lange Datensequenzen verarbeiten und kohärentere Videoinhalte erzeugen kann.
Supervised Fine-Tuning: Aufbauend auf dem Vortraining wird überwachtes Feintuning mit umfangreichen Anime-Videodaten durchgeführt. Durch verschiedene Strategien (beispielsweise Weak-to-Strong-Trainingsstrategien und Multi-Task-Learning) werden die Generalisierungsfähigkeit und die Generierungsqualität des Modells verbessert.
Datenverarbeitungs-Pipeline: Basierend auf Szenenerkennung, optischer Fluss-Analyse, ästhetischer Bewertung und weiteren Techniken werden aus einer großen Menge roher Anime-Videos qualitativ hochwertige Trainingsdaten gefiltert, um deren Qualität und Vielfalt sicherzustellen.
Open-Source-Adressen
https://github.com/bilibili/Index-anisora/tree/main
https://huggingface.co/IndexTeam/Index-anisora
https://www.modelscope.cn/organization/bilibili-index









