
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Simple Subtitling: Automatisches Untertitel-Tool für Videoinhalte
小编 ·

Simple Subtitling: Automatisches Untertitel-Tool für Videoinhalte
Was ist Simple Subtitling?
Simple Subtitling ist ein aitool, das automatisch Untertitel für Film- und Fernsehproduktionen generiert. Es verwendet die WhisperX-Technologie, um Audiodateien in Untertiteldateien (SRT) mit Zeitstempeln und Sprecher-IDs umzuwandeln. Anschließend weist es Sprecher-IDs durch das Extrahieren von Sprechereinbettungen und Clustering zu und kann den Sprechern genaue Namen zuweisen, sofern Audiobeispiele vorhanden sind. Konkret wandelt es zunächst Audio in Text um und fügt Zeitstempel hinzu; dann extrahiert es die Merkmale jedes Sprechers, gruppiert diese mit agglomerativem hierarchischem Clustering (AHC) und weist den Sprechern schließlich IDs zu. Wenn der Benutzer Sprachbeispiele der Darsteller bereitstellt, kann das Tool den Sprechern auch Namen zuordnen. Dieses Tool wurde entwickelt, um die Untertitelgenerierung zu vereinfachen und das Ansehen von Film- und Fernsehwerken bequemer zu machen.
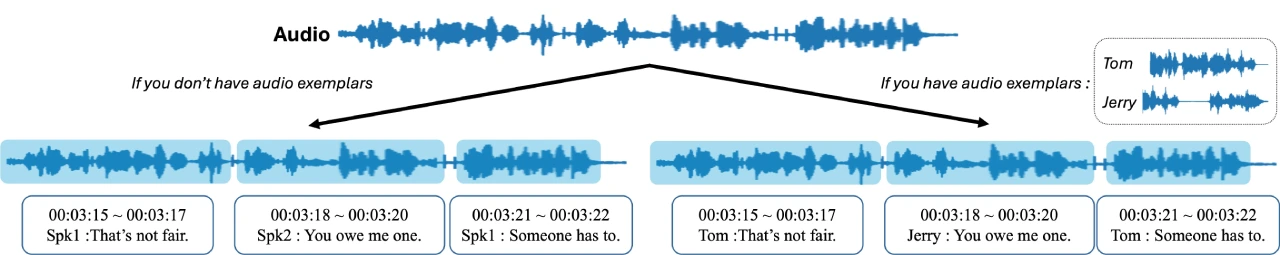
Funktionsmerkmale von Simple Subtitling
Spracherkennung und Zeitstempelgenerierung: Mithilfe der WhisperX-Technologie kann der Audioinhalt Wort für Wort und Satz für Satz präzise erkannt und in Sprachtext mit Zeitstempeln umgewandelt werden.
Sprechererkennung: Durch die Extraktion von Sprechereinbettungen auf Satzebene und die Anwendung von agglomerativem hierarchischem Clustering (AHC) zur Gruppierung der Einbettungen werden Sprecher-IDs zugewiesen.
Mehrsprachige Unterstützung: Unterstützt Audioeingaben in mehreren Sprachen und kann entsprechende Untertitel generieren.
Benutzerdefinierte Einstellungen: Benutzer können ein Verzeichnis für Audiobeispiele angeben, um den Sprechern genaue Namen zuzuweisen.
Spracherkennung und Clustering mit hoher Genauigkeit: Ermöglicht hochpräzise Spracherkennung und Clustering, wandelt Sprache genau in Text um und klassifiziert die Sprache verschiedener Sprecher, um die Genauigkeit und Lesbarkeit der Untertitel zu verbessern.
Installation und Verwendung von Simple Subtitling
Installationsschritte
Erstellen und aktivieren Sie eine conda-Umgebung namens simplesub mit der Python-Version 3.11.
Installieren Sie in dieser Umgebung die für das Projekt erforderlichen Python-Pakete mit dem Befehl pip install -r requirements.txt.
Außerdem muss ffmpeg installiert werden. Die spezifische Installationsmethode finden Sie in der entsprechenden Dokumentation.
Verwendung
Grundlegende Verwendung
Führen Sie python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] aus, z. B. python main.py --input_file data/friends.wav --output_file result/friends.srt. Dadurch wird basierend auf der eingegebenen Audiodatei eine Untertiteldatei generiert.
Sprechernamen mithilfe von Audiobeispielen angeben
Organisieren Sie zunächst das --exemplar_dir-Verzeichnis gemäß einer bestimmten Struktur. Jeder Unterordner steht für einen Sprecher und enthält Audiobeispiele dieses Sprechers.
Führen Sie dann python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] --exemplar_dir [PATH_OF_EXEMPLARS] aus, z. B. python main.py --input_file data/friends.wav --output_file result/friends_exemplars.srt --exemplars exemplars.
Parameterbeschreibung
input_file: Pfad zur eingegebenen Audiodatei.
output_file: Pfad zur Ausgabe-Untertiteldatei (SRT-Format).
whisper_model_type: Typ des Whisper-Modells, standardmäßig 'medium'. Die wählbaren Typen finden Sie in der entsprechenden Dokumentation.
language: Sprachcode (zwei Buchstaben, z. B. 'en' für Englisch). Wenn der Wert None ist, erkennt Whisper die Sprache in den ersten 30 Sekunden. Standardwert ist None.
embedding_model: Sprecher-Einbettungsextraktor, wählbar zwischen 'ecapatdnn' oder 'wespeaker'. Standardwert ist 'wespeaker'.
n_cluster: Wenn die Anzahl der Sprecher bekannt ist, kann dieser Parameter angegeben werden. Standardwert ist None.
distance_threshold: Wenn n_cluster nicht angegeben ist, ist dies der Abstandsschwellenwert für AHC (agglomeratives hierarchisches Clustering). Standardwert ist 0.8.
exemplar_dir: Pfad zum Verzeichnis mit Audiobeispielen. Standardwert ist None.
exemplar_threshold: Schwellenwert für die Kosinusähnlichkeit, der zur Bestimmung „unbekannter" Sprecher verwendet wird. Standardwert ist 0.2.
Github:https://github.com/JaesungHuh/simple-subtitling









