
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ContextGem: KI-Tool zur Extraktion strukturierter Daten aus Dokumenten
小编 ·

ContextGem: KI-Tool zur Extraktion strukturierter Daten aus Dokumenten
Was ist ContextGem?
ContextGem ist ein KI-Tool zur Extraktion strukturierter Daten aus Dokumenten. Seine Kernfähigkeit besteht darin, die Absicht des Nutzers anhand der angegebenen Extraktionsinformationen automatisch zu verstehen und den entsprechenden Inhalt im Dokument präzise zu lokalisieren, wobei es sich besonders für tiefgehende Analysen eignet.
Es eignet sich hervorragend für Szenarien, in denen umfangreiche Dokumentlektüre erforderlich ist, etwa zur Extraktion wichtiger Klauseln aus Verträgen, relevanter Daten aus Berichten oder zentraler Aussagen aus wissenschaftlichen Arbeiten, und hilft Nutzern, effizient präzises Lesen zu betreiben.
ContextGem kann nicht nur Informationen lokalisieren und Ihnen genau sagen, in welchem Absatz oder Satz sie stehen, sondern auch die Gründe für die Extraktion dieser Informationen sowie den zugrunde liegenden Schlussfolgerungsprozess erläutern. Komplexe Extraktionsaufgaben lassen sich mit nur wenigen Codezeilen erledigen – der Automatisierungsgrad ist sehr hoch, und viele komplexe Vorgänge sind bereits gekapselt. Das Tool kann automatisch Prompts generieren, Datenvalidierungen durchführen und Dokumente segmentieren, was den Arbeitsablauf für die Nutzer erheblich vereinfacht.
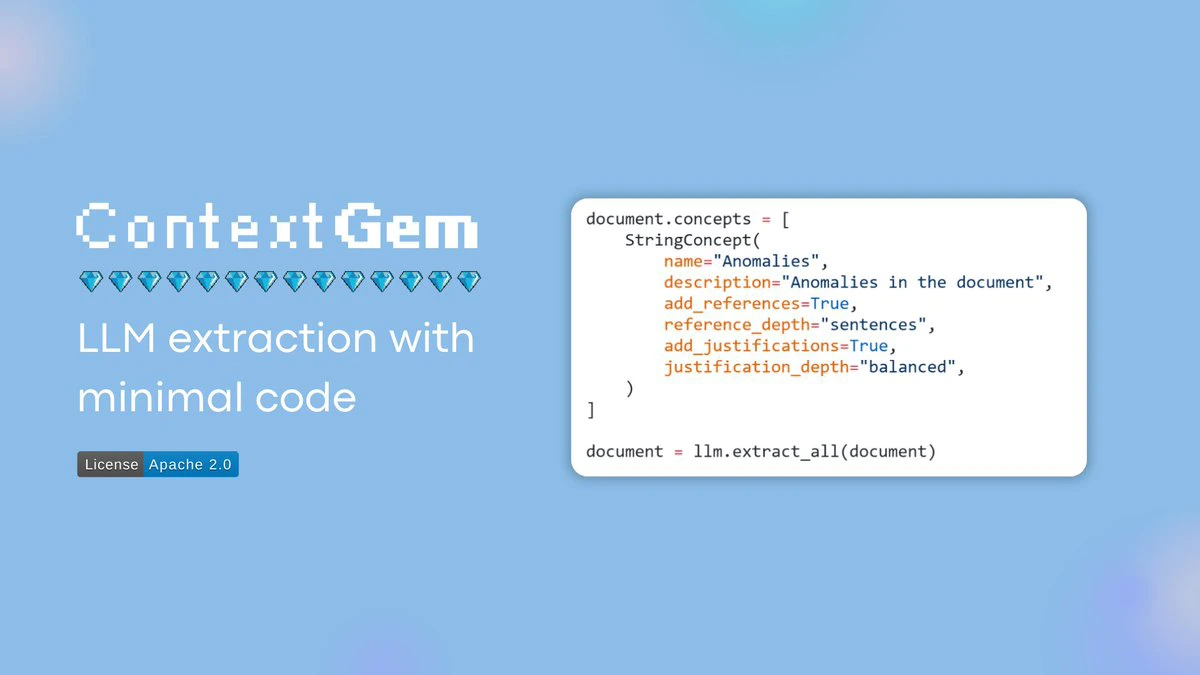
Kernfunktionen von ContextGem
Automatisierte dynamische Prompts: Erstellt automatisch maßgeschneiderte, umfassende Prompts auf Basis der Extraktionsanforderungen, ohne dass diese manuell verfasst und gepflegt werden müssen.
Automatische Generierung von Datenmodellen und Validatoren: Erstellt automatisch Pydantic-Datenmodelle und Validierungslogik aus den Definitionen und vermeidet so wiederholt zu schreibenden Boilerplate-Code.
Präzise Zuordnung der extrahierten Inhalte: Ordnet extrahierte Daten automatisch präzise ihrer Position im Quelldokument zu (auf Absatz- oder Satzebene), sodass die Ergebnisse überprüfbar und nachvollziehbar sind.
Bereitstellung von Extraktionsbegründungen: Enthält automatisch textuelle Begründungen oder Belege, die jede einzelne extrahierte Information stützen, und erhöht so die Transparenz und Vertrauenswürdigkeit der Ergebnisse.
Intelligente Dokumentensegmentierung: Nutzt modernste neuronale Segmentierungsmodelle (SaT), um Dokumente präzise in Absätze und Sätze zu zerlegen, und unterstützt mehrere Sprachen.
Einheitlicher Extraktionsprozess: Ermöglicht die Definition des gesamten Extraktions-Workflows in einer einzigen, deklarativen und wiederverwendbaren Pipeline-Konfiguration, einschließlich verschachtelter Kontexte und rollenspezifischer LLMs.
Unterstützung für verschachtelte Kontext Extraktion: Verarbeitet hierarchische Informationsextraktion (z. B. Dokument > Abschnitt > Unterabschnitt > Entität) automatisch gemäß der Pipeline-Definition und vereinfacht so die Analyse komplexer Dokumente.
Integrierte Parallelverarbeitung: Aktiviert parallele I/O-Verarbeitung durch einfaches Umschalten von use_concurrency=True und beschleunigt so rechenintensive Extraktions-Workflows mit mehreren LLM-Aufrufen.
Automatische Nachverfolgung von Nutzung und Kosten: Überwacht LLM-Aufrufe, Token-Verbrauch und zugehörige Kosten im Workflow ohne zusätzlichen Konfigurationsaufwand.
Integrierte Fallback- und Retry-Logik: Verfügt über einen integrierten Retry-Mechanismus und ermöglicht die einfache Konfiguration von Fallback-LLMs für höhere Ausfallsicherheit.
Mehrsprachigkeit: Unterstützt Ein- und Ausgabe in mehreren Sprachen ohne zusätzliche Prompts.
Unterstützung mehrerer LLM-Anbieter: Unterstützt Cloud-LLMs (z. B. OpenAI, Anthropic, Google, Azure OpenAI usw.) sowie lokale LLMs (z. B. Ollama, LM Studio usw.) mit einer einheitlichen Schnittstelle für einfaches Wechseln.
Optimierungsstrategien: Bietet Strategien zur Optimierung von Genauigkeit, Geschwindigkeit und Kosten sowie Empfehlungen für den Umgang mit langen Dokumenten und die Auswahl geeigneter LLMs.
Ergebnis-Serialisierung: Ermöglicht das Speichern und Laden von Dokumentobjekten, Pipelines und LLM-Konfigurationen, um teure LLM-Aufrufe nicht zu wiederholen.
Dokumentkonverter
ContextGem stellt einen integrierten Dokumentkonverter bereit, der DOCX-Dateien in für LLMs verwertbare Daten umwandelt. Es kann Informationen extrahieren, die andere Open-Source-Tools häufig nicht erfassen, etwa verschobene Tabellen, Anmerkungen, Fußnoten, Textfelder, Kopf- und Fußzeilen sowie eingebettete Bilder, und bewahrt dabei die Dokumentstruktur sowie umfangreiche Metadaten für eine bessere LLM-Analyse.
Anwendungsfälle von ContextGem
ContextGem konzentriert sich auf tiefgehende, präzise Analysen einzelner Dokumente und nutzt die erweiterten Kontextfenster und Fähigkeiten moderner LLMs. Es eignet sich für Szenarien, in denen exakte Informationen sowie Erkenntnisse aus bestimmten Dokumenten extrahiert werden müssen, etwa für die Analyse juristischer Verträge oder die Verarbeitung von Finanzdokumenten. Abfragen über mehrere Dokumente hinweg oder ein Retrieval über gesamte Korpora werden derzeit jedoch nicht unterstützt; für solche Anwendungsfälle sind moderne RAG-Systeme (z. B. LlamaIndex, Haystack) möglicherweise besser geeignet.
Projektlink von ContextGem
https://github.com/shcherbak-ai/contextgem









