
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Insert Anything: Open-Source-Framework zur Bildbearbeitung mit Gesichts- und Outfit-Wechsel u. v. m.
小编 ·

Insert Anything: Open-Source-Framework zur Bildbearbeitung mit Gesichts- und Outfit-Wechsel u. v. m.
Insert Anything Einführung
Insert Anything ist ein einheitliches Bildinsertion-Framework, das gemeinsam von der Zhejiang-Universität, der Harvard-Universität und der Nanyang Technological University entwickelt wurde. Es ermöglicht die nahtlose Integration von Objekten aus Referenzbildern in Zielszenen und unterstützt eine Vielzahl praktischer Anwendungsszenarien, wie z. B. künstlerische Kreation, realistischen Face-Swap, Komposition von Filmszenen, virtuelle Anprobe von Kleidung, Accessoires-Anpassung und digitalen Requisitenwechsel.
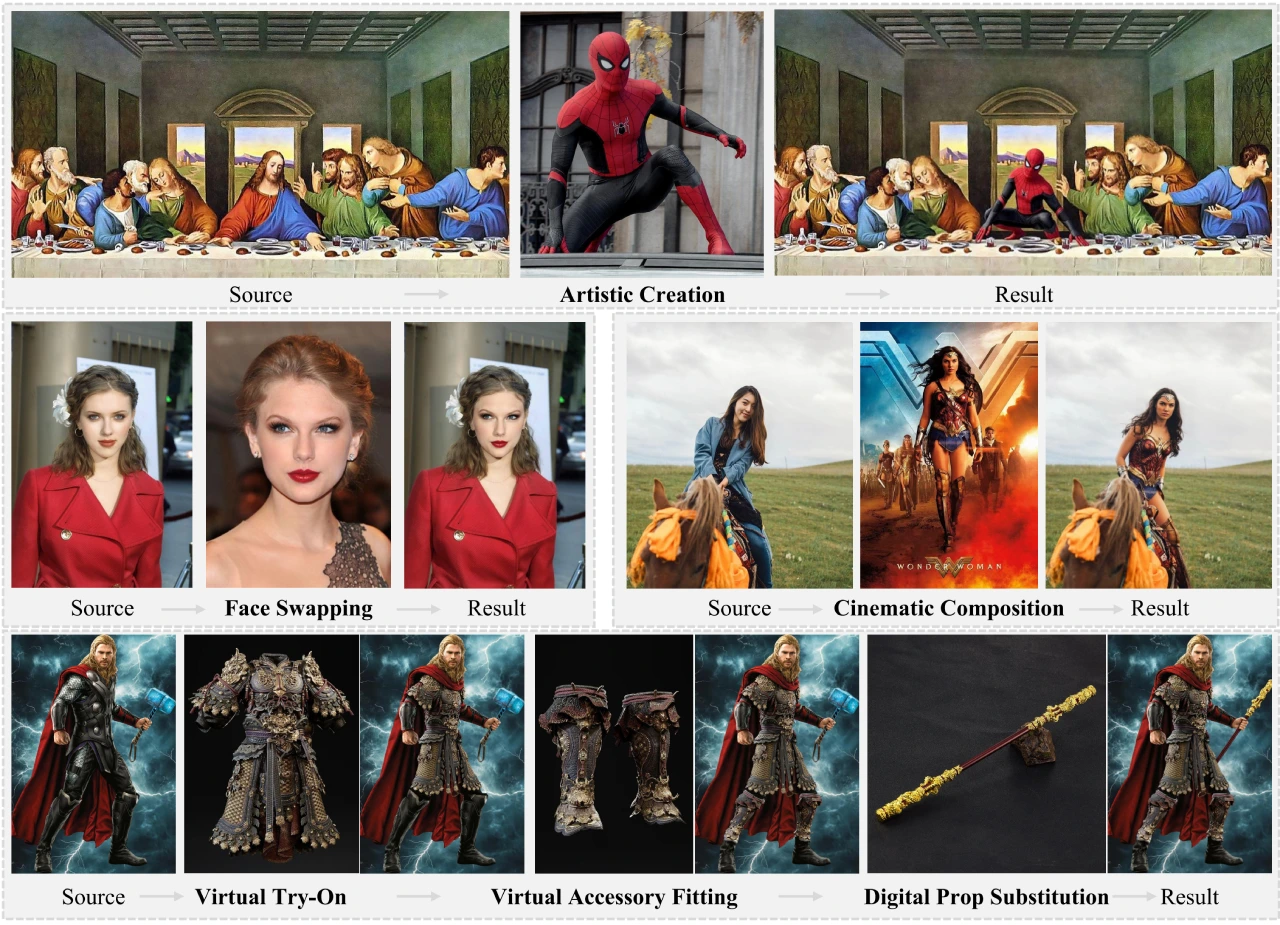
Technische Prinzipien von Insert Anything
1. AnyInsertion-Datensatz
Umfang und Inhalt: Das Framework basiert auf einem AnyInsertion-Datensatz, der 120.000 Prompt-Bild-Paare enthält und verschiedene Aufgaben wie das Einfügen von Personen, Objekten und Kleidung abdeckt.
Mehrere Steuerungsmodi: Der Datensatz unterstützt zwei Steuerungsmodi, nämlich Masken-Prompts (58K Paare) und Text-Prompts (101K Paare), und bietet dem Modell somit reichhaltige Trainingsdaten.
2. Diffusion Transformer (DiT)
Multimodaler Aufmerksamkeitsmechanismus: Insert Anything nutzt den multimodalen Aufmerksamkeitsmechanismus von DiT und unterstützt sowohl maskengesteuerte als auch textgesteuerte Bearbeitung. Dieser Mechanismus verarbeitet visuelle Eingaben und Textbeschreibungen separat über einen Bild- und einen Textzweig und fusioniert diese Informationen anschließend durch multimodale Aufmerksamkeit.
Bildzweig: Verarbeitet Referenzbild, Quellbild und Maske, extrahiert visuelle Merkmale und konkateniert sie mit Rauschen.
Textzweig: Kodiert Textbeschreibungen, um semantische Steuerung bereitzustellen.
3. Kontext-Bearbeitungsmechanismus
Diptychon- und Triptychon-Prompt-Strategien:
Masken-Prompt-Diptychon: Links befindet sich das Referenzbild, rechts das Zielbild mit Maske.
Text-Prompt-Triptychon: Links befindet sich das Referenzbild, in der Mitte das Quellbild, rechts das durch Text generierte Ergebnis.
Funktion: Dieser Mechanismus behandelt das Referenzbild als Kontextinformation und stellt durch implizite Interaktion sicher, dass die eingefügten Elemente visuell konsistent mit der Zielszenen sind, während deren einzigartige Merkmale erhalten bleiben.
Vorteile
Universalität: Ein einziges Modell kann mehrere Insertionsaufgaben bewältigen, sodass kein separates Training für jede Aufgabe erforderlich ist.
Flexibilität: Unterstützt zwei Steuerungsmodi – Maske und Text – und erfüllt damit unterschiedliche Bearbeitungsanforderungen der Nutzer.
Visuelle Konsistenz: Durch den Kontext-Bearbeitungsmechanismus wird eine natürliche Verschmelzung der eingefügten Elemente mit der Zielszenen gewährleistet.
Anwendungsszenarien von Insert Anything
Künstlerische Kreation: Nahtloses Einfügen künstlerischer Elemente in verschiedene Hintergründe.
Werbung: Einfügen von Produktbildern in Werbeszenen.
Popkultur-Kreationen: Einfügen von Popkultur-Elementen in entsprechende Szenen.
Projektlinks
Projekt-Hauptseite:https://song-wensong.github.io/insert-anything/
Paper:https://arxiv.org/abs/2504.15009
Github:https://github.com/song-wensong/insert-anything









