
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Voila: Ein Open-Source-End-to-End-KI-Sprachmodell
小编 ·

Voila: Ein Open-Source-End-to-End-KI-Sprachmodell
Was ist Voila?
Voila ist ein Ende-zu-Ende-KI-Sprachmodell, das Full-Duplex-Technologie verwendet und gleichzeitig hören und sprechen kann. Es zeichnet sich durch eine geringe Latenz aus, wobei die Reaktionsverzögerung nur 195 Millisekunden beträgt – niedriger als die durchschnittliche Reaktionszeit eines Menschen – und verzichtet auf herkömmliche Pipeline-Systeme.
Das Modell verfügt über mehr als eine Million voreingestellte Stimmen und unterstützt verschiedene Funktionen wie automatische Spracherkennung (ASR), Text-to-Speech (TTS) sowie mehrsprachige Sprachübersetzung. Darüber hinaus ermöglicht Voila Echtzeit-Autonomdialoge, hört kontinuierlich zu, schlussfolgert und reagiert proaktiv auf den Benutzer. Die Benutzer können außerdem über Textbefehle die Identität, den Tonfall und andere Merkmale des Sprechers definieren, um ein individuelleres und natürlicheres Sprachinteraktionserlebnis zu erzielen.
Funktionsmerkmale von Voila
Geringe Latenz und Full-Duplex-Dialoge: Voila ermöglicht Full-Duplex-Dialoge mit geringer Latenz, wobei die Reaktionsverzögerung nur 195 Millisekunden beträgt und damit die durchschnittliche Reaktionszeit des Menschen übertrifft.
Erhalt sprachlicher Details: Es bewahrt umfangreiche Sprachdetails wie Intonation, Rhythmus und Emotionen.
Hierarchische Multi-Skalen-Transformer-Architektur: Kombiniert die Schlussfolgerungsfähigkeiten großer Sprachmodelle (LLMs) mit leistungsstarker akustischer Modellierung und ermöglicht so eine natürliche, charakterbewusste Sprachgenerierung. Die Benutzer können über Textbefehle die Identität, den Tonfall und andere Merkmale des Sprechers definieren.
Leistungsstarke Stimm-Anpassungsfähigkeit: Unterstützt über eine Million vorgefertigte Stimmen und kann effizient neue Stimmen aus Audioproben von nur 10 Sekunden Länge anpassen.
Einheitliches Modelldesign: Geeignet für ein breites Spektrum von Sprachanwendungen, einschließlich automatischer Spracherkennung (ASR), Text-to-Speech (TTS) sowie mehrsprachiger Sprachübersetzung mit minimaler Anpassung.
Technische Grundlagen
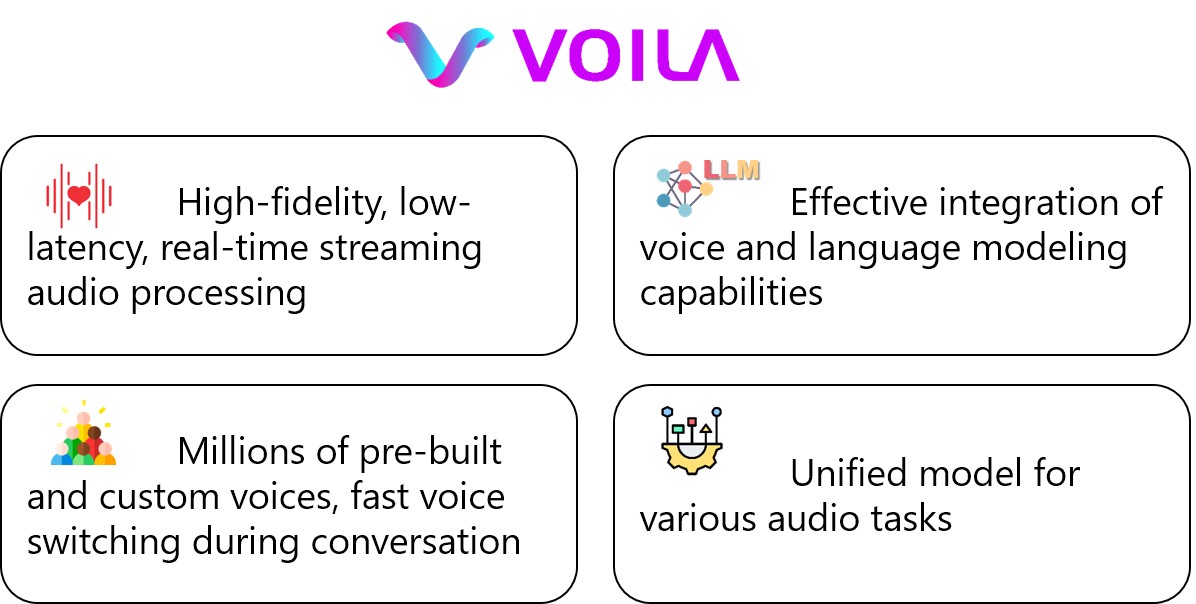
Hochauflösende, latenzarme Echtzeit-Audioverarbeitung in Streams: Ermöglicht Dialoge mit geringer Latenz und bewahrt Sprachdetails.
Effiziente Integration von Sprach- und Sprachmodellierungsfähigkeiten: Kombiniert Text- und Sprachmodellierung, um die Natürlichkeit der Interaktion zu verbessern.
Millionen von vorgefertigten und benutzerdefinierten Stimmen: Unterstützt den schnellen Wechsel zwischen Stimmen im Dialog und bereichert das Interaktionserlebnis.
Einheitliches Modell für verschiedene Audioaufgaben: Ein einziges Modell unterstützt mehrere Audioaufgaben und senkt die Entwicklungs- und Bereitstellungskosten.
Anwendungsszenarien für Voila
Sprachassistent: Kann als intelligenter Sprachassistent fungieren, der autonom, in Echtzeit und mit emotionalem Ausdruck mit Menschen interagiert, kontinuierlich zuhört, schlussfolgert und proaktiv reagiert, um ein reibungsloses, dynamisches und emotional ansprechendes Interaktionserlebnis zu ermöglichen.
Sprachrollenspiele: In Rollenspiel-Szenarien können Benutzer die Identität, den Tonfall und andere Merkmale des Sprechers definieren, um eine natürliche, charakterbewusste Sprachgenerierung zu erreichen.
Mehrsprachige Sprachübersetzung: Mit minimaler Anpassung kann es für mehrsprachige Sprachübersetzungen verwendet werden.
Projektbezogene Links
Projekt-Startseite: https://voila.maitrix.org/
Modell: https://huggingface.co/collections/maitrix-org/voila-67e0d96962c19f221fc73fa5
Demo: https://huggingface.co/spaces/maitrix-org/Voila-demo
Paper: https://arxiv.org/abs/2505.02707
GitHub-Repository: https://github.com/maitrix-org/Voila









