
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
RealtimeVoiceChat: KI-Sprachchat-App mit Echtzeit-Sprachantworten
小编 ·

RealtimeVoiceChat: KI-Sprachchat-App mit Echtzeit-Sprachantworten
Was ist RealtimeVoiceChat?
RealtimeVoiceChat ist ein Open-Source-Projekt, mit dem du per Sprache mit einem intelligenten System chatten und Sprachantworten in Echtzeit erhalten kannst. Es überträgt Audioschnipsel über das Netzwerk, wandelt Sprache in Text um, lässt diese vom intelligenten System verarbeiten und generiert daraus wieder Sprache. Das Projekt unterstützt verschiedene intelligente Systeme (standardmäßig Ollama, es kann auch Openai verwendet werden) und ermöglicht eine flexible Auswahl der Sprachstile. Es verwendet eine Client-Server-Architektur, ist auf geringe Latenz optimiert und erkennt intelligent die Gesprächswechsel, was den Chat flüssiger macht. Für die Bereitstellung wird Docker empfohlen; bei einer CUDA-fähigen NVIDIA-GPU ist die Leistung besser.
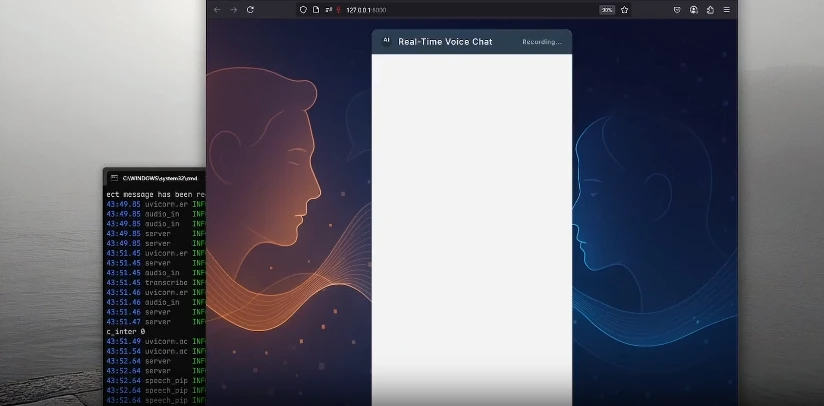
Kernfunktionen von RealtimeVoiceChat
Streaming-Sprachinteraktion: Die Benutzerstimme wird vom Browser erfasst, über WebSockets an das Python-Backend übertragen, in Echtzeit in Text transkribiert, zur Verarbeitung an das LLM gesendet und die Textantwort als Sprachstrom an den Benutzer zurückgespielt.
Design mit geringer Latenz: Die Architektur ist durch das Streamen von Audioblöcken optimiert und sorgt für flüssige Gespräche.
Intelligente Gesprächswechsel-Erkennung: Dynamische Stilleerkennung, die das Rederecht automatisch je nach Gesprächsdynamik übergibt.
Flexible KI-Backends: Unterstützt verschiedene LLM-Backends (standardmäßig Ollama, auch OpenAI wird unterstützt).
Anpassbare Stimmen: Verschiedene Text-to-Speech-Engines können ausgewählt werden (z. B. Kokoro, Coqui, Orpheus).
Schlanke Weboberfläche: Eine einfache Benutzeroberfläche, die mit Vanilla JS und der Web Audio API erstellt wurde.
Dockerisierte Bereitstellung: Für die Bereitstellung wird Docker Compose empfohlen, um Abhängigkeiten einfacher zu verwalten.
Eigenschaften von RealtimeVoiceChat
Echtzeit-Interaktion: Benutzer können per Sprache mit der KI kommunizieren, und die KI antwortet ebenfalls in Echtzeit per Sprache.
Zusammenarbeit mehrerer Komponenten: Das Projekt umfasst die Audioverarbeitung und UI-Interaktion im Frontend sowie Sprachtranskription, Textverarbeitung und Sprachsynthese im Backend.
Konfigurierbarkeit: Unterstützt verschiedene TTS-Engines und LLM-Modelle und kann über Umgebungsvariablen konfiguriert werden.
Technologie-Stack
Backend: Python 3.x, FastAPI
Frontend: HTML, CSS, JavaScript (Vanilla JS, Web Audio API, AudioWorklets)
Kommunikation: WebSockets
Containerisierung: Docker, Docker Compose
Kern-KI/ML-Bibliotheken: RealtimeSTT (Sprache zu Text), RealtimeTTS (Text zu Sprache), transformers (Gesprächswechsel-Erkennung, Tokenisierung), torch/torchaudio (Machine-Learning-Framework), ollama/openai (LLM-Clients)
Audioverarbeitung: numpy, scipy
Installation und Bereitstellung
Docker-Installation (empfohlen)
Klone das Projekt und wechsle in das Verzeichnis.
Baue das Docker-Image (lädt das Basis-Image herunter, installiert Python/ML-Abhängigkeiten und lädt das Standard-STT-Modell vorab herunter).
Starte die Dienste (App und Ollama).
Lade die benötigten Ollama-Modelle herunter.
Greife über den Browser auf http://localhost:8000 zu und beginne den Sprachchat.
Manuelle Installation
Erstelle und aktiviere eine Python-Virtual-Environment.
Installiere PyTorch (je nach Hardwarekonfiguration).
Installiere die übrigen Abhängigkeiten (requirements.txt).
Starte den FastAPI-Server.
Greife über den Browser auf http://localhost:8000 zu und beginne den Sprachchat.
Konfiguration und Anpassung
TTS-Engine und Stimme: In server.py und audio_module.py konfigurieren.
LLM-Backend und Modell: In server.py und llm_module.py konfigurieren.
STT-Einstellungen: In transcribe.py konfigurieren.
Empfindlichkeit der Gesprächswechsel-Erkennung: In turndetect.py konfigurieren.
SSL/HTTPS: In server.py konfigurieren.
Projektadresse
GitHub-Repository:https://github.com/KoljaB/RealtimeVoiceChat









